변수가 수백 개인 식을 성분마다 편미분하지 않고, 벡터와 행렬 채로 한 번에 미분하는 규칙 모음이다. 곱의 미분처럼 몇 가지 공식만 익히면 최소제곱의 정규방정식이나 로지스틱 회귀의 기울기가 한두 줄로 나온다. 기계학습 논문의 유도는 거의 이 언어로 쓰여 있다. 다만 결과의 모양(행벡터냐 열벡터냐)을 적는 관례가 책마다 달라, 크기를 맞춰 보고 수치 미분으로 확인하는 습관이 필요하다.
예시로 보기
\(f(\mathbf{x}) = \mathbf{x}^\top A\mathbf{x}\)(\(^\top\)는 행과 열을 바꾸는 전치), \(A = \begin{pmatrix}1 & 2\\ 0 & 3\end{pmatrix}\)을 성분으로 쓰면 \(x_1^2 + 2x_1x_2 + 3x_2^2\)이다. 편미분은
\[\frac{\partial f}{\partial x_1} = 2x_1 + 2x_2, \qquad \frac{\partial f}{\partial x_2} = 2x_1 + 6x_2.\]이것을 모으면 \(\begin{pmatrix}2 & 2\\ 2 & 6\end{pmatrix}\mathbf{x} = (A + A^\top)\mathbf{x}\)다. 한 변수의 \((ax^2)' = 2ax\)와 닮았지만, \(A\)가 대칭이 아니면 \(2A\mathbf{x}\)가 아니라 \((A + A^\top)\mathbf{x}\)다. 성분 계산을 행렬 한 줄로 바꾼 것이 아래 규칙표의 한 줄이다.
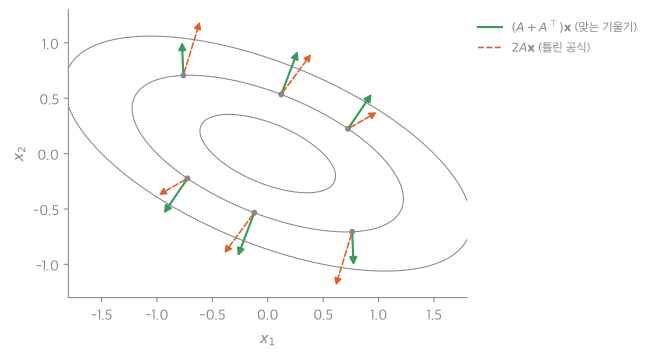
회색 타원은 이 \(f\)의 등고선이다. 가운데 등고선(\(f = 1\)) 위의 여섯 점에서 초록 화살표 \((A + A^\top)\mathbf{x}\)는 모두 등고선에 수직이다. 그래디언트라면 그래야 한다. 주황 점선 \(2A\mathbf{x}\)는 비스듬히 기울어 있어 그래디언트가 아니다1.
정의
이 문서에서 스칼라 함수 \(f(\mathbf{x})\)의 그래디언트 \(\nabla_{\mathbf{x}}f\)는 \(\mathbf{x}\)와 같은 모양의 열벡터다(분모 배치). 벡터 함수의 도함수는 야코비 행렬이다2.
| 식 \(f(\mathbf{x})\) | \(\nabla_{\mathbf{x}}f\) | 한 변수에서 닮은 꼴 |
|---|---|---|
| \(\mathbf{a}^\top\mathbf{x}\) | \(\mathbf{a}\) | \((ax)' = a\) |
| \(\mathbf{x}^\top\mathbf{x} = \Vert \mathbf{x}\Vert ^2\) | \(2\mathbf{x}\) | \((x^2)' = 2x\) |
| \(\mathbf{x}^\top A\mathbf{x}\) | \((A + A^\top)\mathbf{x}\) (대칭이면 \(2A\mathbf{x}\)) | \((ax^2)' = 2ax\) |
| \(\Vert A\mathbf{x} - \mathbf{b}\Vert ^2\) | \(2A^\top(A\mathbf{x} - \mathbf{b})\) | \(((ax - b)^2)' = 2a(ax - b)\) |
| \(g(\mathbf{h}(\mathbf{x}))\) | \(J_{\mathbf{h}}^\top\nabla g\) | 연쇄 법칙 |
규칙의 근거
- \(\mathbf{a}^\top\mathbf{x} = \sum a_ix_i\): \(x_k\)로 미분하면 \(a_k\).
- \(\mathbf{x}^\top A\mathbf{x} = \sum_{i,j}a_{ij}x_ix_j\): \(x_k\)가 들어 있는 항은 \(i = k\)이거나 \(j = k\)인 항이다. \(\frac{\partial}{\partial x_k} = \sum_j a_{kj}x_j + \sum_i a_{ik}x_i = (A\mathbf{x})_k + (A^\top\mathbf{x})_k\).
- \(\Vert A\mathbf{x} - \mathbf{b}\Vert ^2\): \(\mathbf{r} = A\mathbf{x} - \mathbf{b}\)로 두면 \(f = \mathbf{r}^\top\mathbf{r}\), \(\nabla_{\mathbf{r}}f = 2\mathbf{r}\), \(J_{\mathbf{r}} = A\). 연쇄 법칙으로 \(A^\top(2\mathbf{r})\). ∎
flowchart LR
    x["x"] -- "야코비 행렬 A" --> r["r = Ax − b"]
    r -- "∇_r f = 2r" --> f["f = rᵀr"]
    f -. "2r" .-> r
    r -. "Aᵀ 곱하기 2r" .-> x
실선은 앞으로 계산하는 방향, 점선은 기울기가 돌아오는 방향이다. 돌아올 때 야코비 행렬 \(A\)는 전치 \(A^\top\)로 곱해진다. 그래서 결과가 \(\mathbf{x}\)와 같은 크기의 열벡터가 된다3.
알아보는 신호와 요령. 식에 \(\mathbf{x}^\top\), 행렬, 노름이 있고 “기울기를 구하라”, “최솟점의 조건을 구하라”는 문제다. (1) 결과의 크기가 \(\mathbf{x}\)와 같은지 먼저 본다. (2) 한 변수로 줄여(모든 것을 \(1 \times 1\)로) 공식이 맞는 모양인지 본다. (3) 작은 무작위 입력에서 수치 미분과 비교한다(기울기 검사).
예제
릿지 회귀의 해. \(L(\mathbf{x}) = \Vert A\mathbf{x} - \mathbf{b}\Vert ^2 + \lambda\Vert \mathbf{x}\Vert ^2\)을 최소로 하는 \(\mathbf{x}\).
- 항마다 규칙: \(\nabla\Vert A\mathbf{x} - \mathbf{b}\Vert ^2 = 2A^\top(A\mathbf{x} - \mathbf{b})\), \(\nabla\lambda\Vert \mathbf{x}\Vert ^2 = 2\lambda\mathbf{x}\).
- 기울기 0: \(2A^\top(A\mathbf{x} - \mathbf{b}) + 2\lambda\mathbf{x} = \mathbf{0}\).
- 정리: \((A^\top A + \lambda I)\mathbf{x} = A^\top\mathbf{b}\). \(\lambda = 0\)이면 정규방정식이다.
- 최소인 이유: 헤세 행렬 \(2(A^\top A + \lambda I)\)가 \(\lambda > 0\)이면 늘 양의 정부호라 유일한 최솟점이다(헤세 판정).
로지스틱 회귀의 기울기. 데이터 행렬 \(X\), 정답 \(\mathbf{y} \in \{0, 1\}^m\)(\(\in\)은 “~에 속한다”), 예측 \(\mathbf{p} = \sigma(X\mathbf{w})\)(성분별 시그모이드)일 때 교차 엔트로피 손실 \(L = -\sum_i\big(y_i\ln p_i + (1 - y_i)\ln(1 - p_i)\big)\)의 기울기는 \(\nabla_{\mathbf{w}}L = X^\top(\mathbf{p} - \mathbf{y})\)다. 시그모이드의 도함수 \(\sigma(1 - \sigma)\)가 로그 미분과 지워져 이렇게 간단해진다4.
활용
- 학습 알고리즘의 유도. 선형 회귀, 릿지, 로지스틱 회귀, 신경망 한 층의 기울기가 모두 이 규칙으로 나온다. 자동미분 라이브러리가 계산을 대신하지만, 결과를 이해하고 검산하려면 손으로 유도할 줄 알아야 한다.
- 관례 확인. 분자 배치(야코비 행렬과 같은 모양)와 분모 배치(그래디언트를 열벡터로)는 서로 전치 관계다. 공식을 가져올 때 어느 관례인지 확인한다2.
- 흔한 실수. 비대칭 \(A\)에서 \(\nabla(\mathbf{x}^\top A\mathbf{x})\)를 \(2A\mathbf{x}\)로 쓰는 것, 연쇄 법칙에서 전치를 빠뜨려 크기가 맞지 않는 것.
연결
- 선수: 다변수 연쇄 법칙과 야코비 행렬, 최소제곱법
- 쓰는 곳: 역전파, 경사 하강법
확인 문제
C1 \(A = \begin{pmatrix}1 & 2\\ 0 & 3\end{pmatrix}\)일 때 \(\nabla_{\mathbf{x}}(\mathbf{x}^\top A\mathbf{x})\)를 행렬로 쓰라.
답: \((A + A^\top)\mathbf{x} = \begin{pmatrix}2 & 2\\ 2 & 6\end{pmatrix}\mathbf{x}\).
C2 \(\Vert A\mathbf{x} - \mathbf{b}\Vert ^2 + \lambda\Vert \mathbf{x}\Vert ^2\)의 기울기를 0으로 놓아 해가 만족하는 식을 구하라.
답: \(2A^\top(A\mathbf{x} - \mathbf{b}) + 2\lambda\mathbf{x} = \mathbf{0}\), 곧 \((A^\top A + \lambda I)\mathbf{x} = A^\top\mathbf{b}\).
C3 \(\nabla(\mathbf{x}^\top A\mathbf{x})\)가 \(2A\mathbf{x}\)가 아니라 \((A + A^\top)\mathbf{x}\)인 이유를 성분으로 설명하라.
답: \(\mathbf{x}^\top A\mathbf{x} = \sum a_{ij}x_ix_j\)에서 \(x_k\)는 앞자리(\(i = k\))에도 뒷자리(\(j = k\))에도 나온다. 앞자리 항의 미분이 \((A\mathbf{x})_k\), 뒷자리 항의 미분이 \((A^\top\mathbf{x})_k\)다. \(A\)가 대칭일 때만 둘이 같아 \(2A\mathbf{x}\)가 된다.
-
24_matrix-calculus_plot.py로 그렸다. 화살표 길이는 같은 비율로 줄였다. \((A + A^\top)\mathbf{x}\)가 무작위 점 50개에서 중앙 차분과 같은 것, 여섯 점에서 등고선의 접선과 수직인 것, \(2A\mathbf{x}\)는 수직이 아닌 것을 같은 코드로 확인했다. ↩
-
Petersen, Pedersen, The Matrix Cookbook, 2절 “Derivatives”(일차식·이차형식·노름의 미분, 배치 관례). ↩ ↩2
-
규칙의 근거 3번(\(\mathbf{r} = A\mathbf{x} - \mathbf{b}\)로 두고 연쇄 법칙)과 규칙표의 마지막 줄 \(J_{\mathbf{h}}^\top\nabla g\)를 근거로 그렸다. ↩
-
Goodfellow, Bengio, Courville, Deep Learning, 4.5절(선형 최소제곱의 기울기), 6.2.2절(시그모이드 출력과 교차 엔트로피의 결합). 공식은 24_matrix-calculus_verify.py에서 수치 미분과 맞춰 확인했다. ↩