안개 낀 산에서 내려가는 사람처럼, 발밑의 경사만 보고 가장 가파르게 내려가는 쪽으로 한 걸음씩 옮긴다. 계산이 단순해서 변수가 수억 개인 신경망 학습에도 그대로 쓰인다. 성패는 걸음 크기(학습률)가 가른다. 너무 크면 골짜기를 건너뛰며 튀어 올라 발산하고, 너무 작으면 한없이 느리다. 또 그릇 모양이 아닌 함수에서는 가장 낮은 곳이 아니라 근처의 움푹한 곳이나 안장점에 멈출 수 있다.
예시로 보기
\(f(x) = x^2\)을 \(x_0 = 1\)에서 시작해 줄인다. 기울기는 \(f'(x) = 2x\)이고, 한 걸음은 “지금 위치 − 학습률 × 기울기”다. 그래서 \(x_{k+1} = x_k - \eta \cdot 2x_k = (1 - 2\eta)x_k\)가 된다. 학습률 \(\eta\)만 바꿔 세 걸음을 추적한다.
| 학습률 \(\eta\) | \(x_0\) | \(x_1\) | \(x_2\) | \(x_3\) | 결과 |
|---|---|---|---|---|---|
| 0.1 | 1 | 0.8 | 0.64 | 0.512 | 천천히 수렴 |
| 0.5 | 1 | 0 | 0 | 0 | 한 걸음에 도착 |
| 1 | 1 | −1 | 1 | −1 | 제자리 진동 |
| 1.1 | 1 | −1.2 | 1.44 | −1.728 | 발산 |
곱해지는 수 \(1 - 2\eta\)의 절댓값이 1보다 작아야 줄어든다. 여기서 2는 \(f''\), 곧 곡률이다. 곡률이 클수록 허용되는 학습률이 작아진다. 아래 정의의 \(L\)이 이 곡률의 상한이다.
정의
입력: 미분 가능한 \(f : \mathbb{R}^n \to \mathbb{R}\)(\(\mathbb{R}\)은 실수 전체, \(\mathbb{R}^n\)은 실수 \(n\)개짜리 목록 전체)의 기울기 함수 \(\nabla f\), 시작점 \(\mathbf{x}_0\), 학습률 \(\eta > 0\), 허용오차 \(\varepsilon > 0\), 최대 반복 수 \(K\). 출력: 기울기가 작은 점 \(\mathbf{x}\).
GRADIENT-DESCENT(∇f, x0, η, ε, K)
  x ← x0
  for k = 0 to K − 1
      g ← ∇f(x)
      if ‖g‖ ≤ ε: return x          # 거의 평평하면 멈춘다
      x ← x − η·g                   # 가장 가파른 내리막으로 한 걸음
  return x
\(L\)-매끄러움. 기울기가 너무 급하게 바뀌지 않는다는 조건이다. 모든 \(\mathbf{x}, \mathbf{y}\)에서 \(\Vert \nabla f(\mathbf{x}) - \nabla f(\mathbf{y})\Vert \le L\Vert \mathbf{x} - \mathbf{y}\Vert\)(\(\lVert\cdot\rVert\)는 벡터의 길이)이면 \(f\)를 \(L\)-매끄럽다고 한다. \(f\)가 두 번 미분 가능하면, 모든 점에서 헤세 행렬의 고윳값 절댓값이 \(L\) 이하인 것과 같다1.
\(f\)가 \(L\)-매끄럽고 \(0 < \eta < \frac{2}{L}\)이면 한 걸음마다
\[f(\mathbf{x} - \eta\nabla f(\mathbf{x})) \le f(\mathbf{x}) - \eta\left(1 - \frac{L\eta}{2}\right)\Vert \nabla f(\mathbf{x})\Vert ^2.\]\(\eta = \frac1L\)로 두고 \(f\)의 하한을 \(f_{\inf}\)라 하면, \(K\)걸음 안에 \(\min_{k < K}\Vert \nabla f(\mathbf{x}_k)\Vert ^2 \le \frac{2L(f(\mathbf{x}_0) - f_{\inf})}{K}\)다. 볼록하지 않은 함수에도 맞는다. 여기에 더해
- \(f\)가 볼록이고 최솟점 \(\mathbf{x}^*\)가 있으면 \(f(\mathbf{x}_k) - f(\mathbf{x}^*) \le \frac{L\Vert \mathbf{x}_0 - \mathbf{x}^*\Vert ^2}{2k}\).
- 헤세 행렬의 고윳값이 늘 \(\mu > 0\) 이상(강볼록)이면 \(f(\mathbf{x}_k) - f(\mathbf{x}^*) \le \left(1 - \frac{\mu}{L}\right)^k\big(f(\mathbf{x}_0) - f(\mathbf{x}^*)\big)\).
루프 불변식. \(\eta = \frac1L\)일 때, \(k\)번째 반복이 시작할 때 \(f(\mathbf{x}_k) \le f(\mathbf{x}_0) - \frac{1}{2L}\sum_{j<k}\Vert \nabla f(\mathbf{x}_j)\Vert ^2\)(\(\sum\)은 차례로 모두 더한다는 기호)이다. 값이 매 걸음 줄고, 줄어든 양은 지나온 기울기 크기의 제곱합만큼이다.
증명
전략: 테일러 전개의 2차 항을 \(L\)로 눌러 한 걸음의 감소량을 아래에서 잡고(하강 보조정리), 그것을 반복 횟수만큼 더한다.
증명 펼치기
1. 이차 상한. \(\mathbf{d} = \mathbf{y} - \mathbf{x}\)로 두면
\[f(\mathbf{y}) - f(\mathbf{x}) - \nabla f(\mathbf{x})\cdot\mathbf{d} = \int_0^1\big(\nabla f(\mathbf{x} + t\mathbf{d}) - \nabla f(\mathbf{x})\big)\cdot\mathbf{d}\,dt.\]좌변은 \(\phi(t) = f(\mathbf{x} + t\mathbf{d})\)에 미적분의 기본정리와 연쇄 법칙 \(\phi'(t) = \nabla f(\mathbf{x} + t\mathbf{d})\cdot\mathbf{d}\)를 쓴 것이다. 코시–슈바르츠 부등식과 \(L\)-매끄러움으로 피적분함수는 \(L t\Vert \mathbf{d}\Vert ^2\) 이하다. 적분하면
\[f(\mathbf{y}) \le f(\mathbf{x}) + \nabla f(\mathbf{x})\cdot\mathbf{d} + \frac{L}{2}\Vert \mathbf{d}\Vert ^2.\]2. 한 걸음 대입. \(\mathbf{d} = -\eta\mathbf{g}\), \(\mathbf{g} = \nabla f(\mathbf{x})\)를 넣으면 \(f(\mathbf{y}) \le f(\mathbf{x}) - \eta\Vert \mathbf{g}\Vert ^2 + \frac{L\eta^2}{2}\Vert \mathbf{g}\Vert ^2\). 이것이 하강 보조정리다. \(0 < \eta < \frac2L\)이면 괄호 \(1 - \frac{L\eta}{2}\)가 양수라 값이 실제로 준다.
3. 불변식. 초기화: \(k = 0\)이면 합이 비어 \(f(\mathbf{x}_0) \le f(\mathbf{x}_0)\). 유지: \(\eta = \frac1L\)이면 2에서 \(f(\mathbf{x}_{k+1}) \le f(\mathbf{x}_k) - \frac{1}{2L}\Vert \nabla f(\mathbf{x}_k)\Vert ^2\)이고, 이것을 불변식에 더하면 \(k + 1\)에서도 맞는다.
4. 종료. 불변식에서 \(\frac{1}{2L}\sum_{j<K}\Vert \nabla f(\mathbf{x}_j)\Vert ^2 \le f(\mathbf{x}_0) - f(\mathbf{x}_K) \le f(\mathbf{x}_0) - f_{\inf}\). 합이 이 값 이하이면 가장 작은 항은 평균 이하이므로 \(K\min_j\Vert \nabla f(\mathbf{x}_j)\Vert ^2 \le 2L(f(\mathbf{x}_0) - f_{\inf})\). ∎
볼록·강볼록일 때의 속도(정리의 1, 2)는 같은 부등식에 볼록성의 접선 부등식을 더해 얻는다 [증명 생략: Boyd·Vandenberghe 9.3절].
스스로 설명해 보기
1. 증명 1단계에서 피적분함수가 \(Lt\Vert \mathbf{d}\Vert ^2\) 이하인 이유는?
코시–슈바르츠로 \((\nabla f(\mathbf{x} + t\mathbf{d}) - \nabla f(\mathbf{x}))\cdot\mathbf{d} \le \Vert \nabla f(\mathbf{x} + t\mathbf{d}) - \nabla f(\mathbf{x})\Vert \,\Vert \mathbf{d}\Vert\). \(L\)-매끄러움으로 앞 인수는 \(L\Vert t\mathbf{d}\Vert = Lt\Vert \mathbf{d}\Vert\) 이하다.
2. 증명 2단계에서 학습률이 \(\frac2L\)보다 작아야 하는 이유는?
감소량 \(\eta\left(1 - \frac{L\eta}{2}\right)\Vert \mathbf{g}\Vert ^2\)이 양수여야 값이 준다고 보장된다. \(\eta \ge \frac2L\)이면 이 보장이 사라지고, 예시의 \(x^2\)(\(L = 2\))처럼 \(\eta \ge 1\)에서 실제로 진동하거나 발산한다.
3. 이 증명의 핵심 아이디어는?
곡률의 상한 \(L\) 덕분에 “기울기 방향으로 조금 가면 이만큼은 반드시 내려간다”는 보장이 생긴다. 한 걸음의 보장을 더하면 전체 감소량이 기울기 제곱합을 잡아 준다. 함숫값에는 하한이 있으니 기울기가 영원히 크게 남을 수 없다.
4. 같은 방법을 쓰는 다른 상황은?
“매 단계 퍼텐셜이 일정량 이상 줄고 퍼텐셜에 하한이 있으니 단계 수가 유한하다”는 논증은 유클리드 호제법의 종료 증명(나머지가 계속 준다)과 같은 모양이다.
예제
조건이 나쁜 골짜기에서의 지그재그. \(f(x, y) = x^2 + 10y^2\), 시작점 \((1, 1)\).
- 기울기와 \(L\): \(\nabla f = (2x, 20y)\). 헤세 행렬 \(\operatorname{diag}(2, 20)\)이라 \(L = 20\), 허용 학습률은 \(\eta < 0.1\).
- 갱신 식: 좌표마다 따로 \(x \leftarrow (1 - 2\eta)x\), \(y \leftarrow (1 - 20\eta)y\).
- \(\eta = 0.09\): \(x\)는 0.82배씩, \(y\)는 \(-0.8\)배씩 준다. \(y\)가 매 걸음 부호를 바꾸며 골짜기 벽을 오가는 지그재그를 그리면서 수렴한다.
- \(\eta = 0.1\)이나 \(0.11\): \(y\) 쪽 인수가 \(-1\)이 되어 제자리에서 진동하거나, \(-1.2\)가 되어 발산한다. 완만한 \(x\) 방향은 멀쩡한데도 가파른 방향 하나가 학습률의 상한을 정한다.
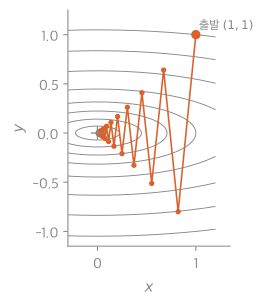
\(\eta = 0.09\)로 25걸음 간 길이다. 가파른 \(y\) 방향으로는 골짜기 벽을 넘나들며 위아래로 튀고, 완만한 \(x\) 방향으로는 조금씩만 다가간다. 그래서 바닥(+)으로 곧장 가지 못하고 톱니 모양으로 간다2.
이 상황을 조건수 \(\kappa = \frac{L}{\mu} = 10\)으로 요약한다. \(\kappa\)가 클수록 골짜기가 좁고 길어 느리다.
활용
비용. 한 걸음에 기울기 계산 한 번이 든다. 역전파로 구하면 \(f\)를 한 번 계산하는 비용의 상수배다. 메모리는 변수 수만큼, 곧 \(O(n)\)이다. 걸음 수는 함수에 따라 다르다.
| 함수의 성질 | 목표 | 걸음 수 |
|---|---|---|
| \(L\)-매끄러움만 (비볼록) | \(\Vert \nabla f\Vert \le \varepsilon\) | \(O(1/\varepsilon^2)\) |
| 볼록 | \(f - f^* \le \varepsilon\) | \(O(1/\varepsilon)\) |
| 강볼록 | \(f - f^* \le \varepsilon\) | \(O(\kappa\log(1/\varepsilon))\) |
- 뉴턴 방법과 비교. 뉴턴 방법은 \(\mathbf{x} \leftarrow \mathbf{x} - H^{-1}\nabla f\)로 곡률까지 써서 이차함수라면 한 걸음에 끝난다. 대신 헤세 행렬을 저장하는 데 \(n^2\), 풀어 쓰는 데 \(O(n^3)\)이 든다. 변수가 \(10^6\)개면 헤세 행렬 원소만 \(10^{12}\)개라, 대규모 학습은 경사 하강법 계열을 쓴다.
- 모멘텀. 이전 걸음의 방향을 일정 비율 이어 가면 지그재그가 서로 상쇄된다. 조건수 100인 이차함수에서 오차를 \(10^{-6}\)배로 줄이는 데, \(\eta = \frac1L\)이면 약 1,340걸음, 가장 좋은 고정 학습률 \(\frac{2}{L + \mu}\)이면 약 690걸음, 모멘텀(헤비볼)이면 약 90걸음이 걸렸다3.
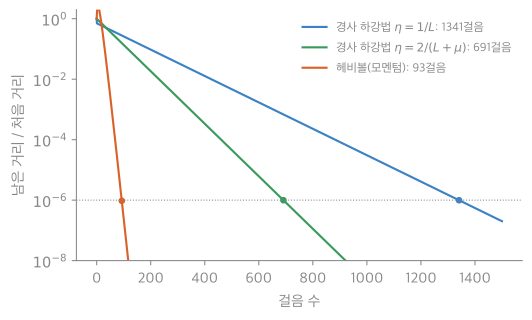
세로축이 로그 눈금이라 세 방법 모두 곧은 선으로 줄어든다. 선이 가파를수록 한 걸음에 더 많이 줄인다. 점선 \(10^{-6}\)에 닿는 걸음 수가 위 문장의 세 숫자다2.
- 확률적 경사 하강법(SGD). 데이터가 수백만 개면 전체 기울기 대신 작은 묶음(미니배치)으로 어림한 기울기를 쓴다. Adam 같은 방법은 좌표마다 학습률을 따로 맞춘다4.
- 흔한 실수. 입력 특성의 크기가 제각각이면(예: 나이는 수십, 소득은 수천만) 조건수가 커져 느려진다. 특성을 표준화하면 골짜기가 둥글어진다.
- 연습: 경사 하강법 예제 사다리
연결
- 선수: 헤세 행렬과 극값 판정(곡률 \(L\)과 \(\mu\)), 그래디언트(가장 가파른 방향)
- 기울기 계산: 행렬 미분, 역전파
- 이어지는 개념: 볼록 함수와 볼록 최적화(수렴 보장이 맞는 함수). 학습률의 안정 조건은 미분방정식과 오일러 방법의 걸음 크기 조건과 같은 구조다.
자주 하는 오해
틀렸다. 작은 범위에서는 학습률을 키울수록 빨라지니 그렇게 믿기 쉽다. 하지만 가장 가파른 방향의 곡률 \(L\)에 대해 \(\eta \ge \frac2L\)이 되는 순간 그 방향에서 튀어 오르기 시작한다. 예시의 \(x^2\)에서 \(\eta = 0.5\)는 한 걸음에 끝나지만 \(\eta = 1.1\)은 발산한다. 손실이 줄지 않고 출렁이거나 커지면 학습률부터 줄여 본다.
틀렸다. 기울기가 0인 점에는 안장점도 있다. \(f = x^2 - y^2\)을 \((1, 0)\)에서 시작하면 \(y\)가 늘 0이라 안장점 \((0, 0)\)에 정확히 멈춘다. 시작점을 \((1, 10^{-8})\)로 조금만 흔들어도 약 100걸음 뒤 \(\vert y\vert > 1\)로 빠져나간다. 멈춘 점이 최솟값인지는 헤세 행렬이나 볼록성으로 따로 확인해야 한다.
flowchart TD
    A["경사 하강법을 돌린 결과를 본다"] --> B{"손실이 어떻게 움직이나"}
    B -- "출렁이거나 커진다" --> C["학습률이 2/L 이상일 수 있다. 학습률을 줄인다"]
    B -- "지그재그로 아주 느리다" --> D["조건수가 크다. 특성을 표준화하거나 모멘텀을 쓴다"]
    B -- "기울기가 거의 0에서 멈췄다" --> E{"헤세 행렬이나 볼록성으로 확인한다"}
    E -- "최솟점" --> F["끝"]
    E -- "안장점이나 지역 최솟점" --> G["시작점을 흔들어 다시 돌린다"]
두 오해가 그림의 두 갈래다. 손실이 출렁이면 학습률을, 멈췄으면 그 점의 종류를 먼저 의심한다5.
과목별 관점
수치해석 (2-2학기). 최댓값을 찾는 같은 방법을 최급상승법이라 부른다. 기울기 \(\nabla f\)는 가장 가파르게 오르는 방향이고 그 크기가 오르는 정도다. \(f(x, y) = xy^2\)이면 \((2, 2)\)에서 \(\nabla f = (4, 8)\), 크기 \(\sqrt{4^2 + 8^2} \approx 8.944\)다. 기울기는 대체로 등고선에 수직이다.
최급상승법은 학습률을 고정하지 않고 걸음마다 직선 탐색을 한다. \(\mathbf S_i = \nabla f(\mathbf x_i)\)로 두고, \(f(\mathbf x_i + h\mathbf S_i)\)를 가장 크게 하는 \(h\)를 1차원 최적화로 찾아 \(\mathbf x_{i+1} = \mathbf x_i + h\mathbf S_i\)로 간다. 이 방법은 선형으로 수렴한다.
예: \(f(x, y) = 2xy + 2x - x^2 - 2y^2\), 시작점 \((-1, 1)\). \(\nabla f = (6, -6)\)이라 \(g(h) = f(-1 + 6h, 1 - 6h) = -7 + 72h - 180h^2\)이다. \(g'(h) = 72 - 360h = 0\)에서 \(h = 0.2\), 다음 점은 \((0.2, -0.2)\)다. 이 점은 기울기 방향 직선 위의 최대점이지 \(f\)의 최대점은 아니다. 다음 걸음은 \(\nabla f(0.2, -0.2) = (1.2, 1.2)\) 방향으로 \(h = 1\)이라 \((1.4, 1.0)\)이고, 참 최대점은 \((2, 1)\)이다. 직선 탐색을 정확히 하면 이웃한 두 걸음의 방향이 서로 수직이라 지그재그로 다가간다6.
확인 문제
C1 \(f(x) = (x - 3)^2\)에 \(x_0 = 0\), 학습률 \(0.25\)로 경사 하강법을 세 걸음 돌려 \(x_1, x_2, x_3\)을 구하라.
답: \(f'(x) = 2(x - 3)\)이라 \(x \leftarrow x - 0.5(x - 3)\), 곧 3까지의 거리가 매번 절반이 된다. \(x_1 = 1.5\), \(x_2 = 2.25\), \(x_3 = 2.625\).
흔한 오답: 기울기의 부호를 반대로 써서 \(x_1 = -1.5\)로 가는 것. 내리막은 기울기의 반대 방향이다.
C2 아래 함수가 하는 일을 한 문장으로 설명하라.
def step(w, X, y, lr):
    grad = [0.0] * len(w)
    for xi, yi in zip(X, y):
        err = sum(a * b for a, b in zip(w, xi)) - yi
        for j in range(len(w)):
            grad[j] += 2 * err * xi[j] / len(X)
    return [wj - lr * gj for wj, gj in zip(w, grad)]
답: 선형 모델의 평균제곱오차를 가중치로 미분한 기울기를 모든 데이터에서 모아, 가중치를 그 반대 방향으로 lr만큼 옮기는 경사 하강법의 한 걸음이다.
C3 이차함수에서 학습률 \(\eta\)가 가장 큰 곡률 \(L\)에 대해 \(\frac2L\)을 넘으면 왜 발산하는가?
답: 곡률이 \(\lambda\)인 방향의 성분은 한 걸음마다 \(1 - \eta\lambda\)배가 된다. 줄어들려면 \(\vert 1 - \eta\lambda\vert < 1\), 곧 \(0 < \eta < \frac{2}{\lambda}\)여야 한다. \(\eta > \frac2L\)이면 가장 가파른 방향에서 \(1 - \eta L < -1\)이라 부호를 바꾸며 커진다.
C4 변수가 \(10^6\)개인 신경망 학습에 뉴턴 방법과 경사 하강법 중 무엇을 쓰는가? 그 이유와, 반대로 뉴턴 방법이 나은 상황은?
답: 경사 하강법(과 그 변형). 뉴턴 방법은 헤세 행렬 \(10^{12}\)개 원소를 저장하고 풀어야 해서 한 걸음이 감당이 안 된다. 변수가 수십~수천 개이고 매끄러운 볼록 문제라면 뉴턴 방법이 몇 걸음 만에 매우 정확하게 수렴해 낫다.
C5 위 예의 둘째 걸음을 계산하라. \((0.2, -0.2)\)에서 기울기와 직선 탐색의 \(h\), 다음 점은?
답: \(\nabla f = (2y + 2 - 2x, 2x - 4y) = (1.2, 1.2)\). \(f(0.2 + 1.2h, -0.2 + 1.2h)\)를 최대로 하는 \(h = 1\)이라 다음 점은 \((1.4, 1.0)\), \(f = 1.64\)다. 첫 걸음 방향 \((6, -6)\)과 둘째 방향 \((1.2, 1.2)\)은 수직이다6.
-
Boyd, Vandenberghe, Convex Optimization, 9.1절(비제약 최소화, 강볼록성과 그 결과), 9.2절(하강 방법), 9.3절 “Gradient descent method”(수렴 분석). ↩
-
26_gradient-descent_plot.py로 그렸고, \(\eta = 0.09\)에서 \(x\)는 0.82배, \(y\)는 \(-0.8\)배씩 줄며 부호가 바뀌는 것, 오차를 \(10^{-6}\)배로 줄이는 걸음 수 1,341, 691, 93(문서의 약 1,340, 690, 90)을 같은 코드로 확인했다. ↩ ↩2
-
함수 \(\frac12(x^2 + 100y^2)\), 시작점 \((1, 1)\)에서 26_gradient-descent_verify.py로 센 값이다. 헤비볼의 계수는 폴랴크의 최적값 \(\eta = \frac{4}{(\sqrt L + \sqrt\mu)^2}\), \(\beta = \left(\frac{\sqrt L - \sqrt\mu}{\sqrt L + \sqrt\mu}\right)^2\)을 썼다. 이론상 오차는 한 걸음마다 경사 하강법이 약 \(\frac{\kappa - 1}{\kappa + 1}\)배, 헤비볼이 약 \(\frac{\sqrt\kappa - 1}{\sqrt\kappa + 1}\)배로 준다. ↩
-
Goodfellow, Bengio, Courville, Deep Learning, 4.3절 “Gradient-Based Optimization”, 8.3절(SGD와 모멘텀), 8.5절(Adam 등 적응적 학습률). ↩
-
자주 하는 오해 두 개, 예제(조건수와 지그재그), 활용 절의 모멘텀과 흔한 실수(특성 표준화), 볼록 함수와 볼록 최적화의 시작점에 따라 답이 다른 예를 근거로 그렸다. ↩