먼저 알아야 할 것
- 기술통계 (공학수학 확률과 통계): 평균·중앙값·최빈값·사분위수·상자 그림. 문서의
과목별 관점에 데이터 과학에서 보는 내용이 있다 - 분산과 표준편차, 공분산과 상관계수 (공학수학 확률과 통계): 분산, 공분산, 피어슨 상관계수
- 내적과 노름 (공학수학 선형대수학): 코사인 유사도, 코사인과 상관계수의 차이
- 교차 엔트로피와 KL 발산 (공학수학 확률과 통계): KL 발산
- 과적합과 교차검증, 가설검정과 p값 (공학수학 확률과 통계): 모델 평가 방법(홀드아웃·교차검증·부트스트랩), 편향과 분산, 짝지은 t-검정. 문서의
과목별 관점에 있다 - 공분산 행렬과 다변량 정규분포, 베이즈 정리, 최대가능도 추정 (공학수학 확률과 통계): GMM과 EM의 바탕
- 주성분 분석 (공학수학 확률과 통계): PCA와, 군집화에 PCA를 쓸 때의 장단점. 문서의
과목별 관점에 있다 - 대칭행렬과 스펙트럼 정리, 그래프의 기초 (공학수학): 그래프 라플라시안의 바탕
- 특잇값 분해 (공학수학 선형대수학): PureSVD의 바탕
- PageRank (공학수학 확률과 통계): 데이터 과학의 PageRank 내용 전체. 문서의
과목별 관점에 예, 막다른 페이지, 거미줄 함정, 구글 행렬이 있다 - 집합 (공학수학 이산수학), 조건부 확률 (공학수학 확률과 통계): 항목 집합과 신뢰도의 바탕
데이터, 측정, 전처리
읽기 전에
- 키를 cm로 적느냐 m로 적느냐에 따라 ‘가장 비슷한 사람’이 바뀔 수 있을까? → 민코프스키 거리
- 검사 10개 중 9개가 둘 다 음성인 두 환자는 90% 비슷한 걸까? → 범주형 속성의 비유사도
- 빈 소득 칸을 0으로 채우면 무엇이 문제일까? → 데이터 정제
| 번호 | 개념 | 한 줄 | 개념 코드 | 연습 |
|---|---|---|---|---|
| 01 | 속성의 종류 | 칸에 든 값으로 할 수 있는 계산: 같다/다르다, 순서, 차이, 비율 | — | — |
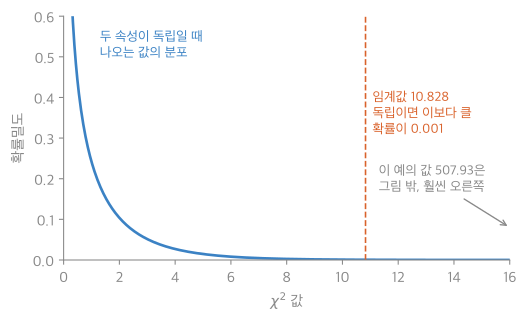
| 02 | 카이제곱 상관 분석 | 이름표 속성 둘의 관련. 독립일 때의 기대 인원과 실제 인원의 차이 | fig1 · plot · verify | — |
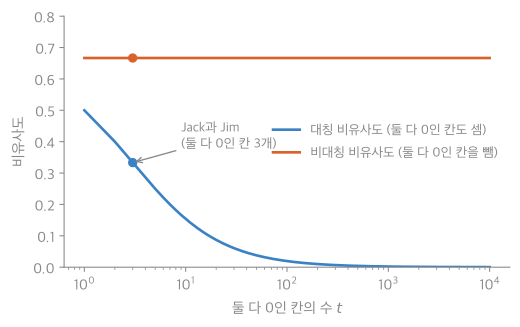
| 03 | 범주형 속성의 비유사도 | 같은 칸의 비율. 비대칭 이진은 둘 다 0인 칸을 뺀다(자카드) | fig1 · plot · verify | — |
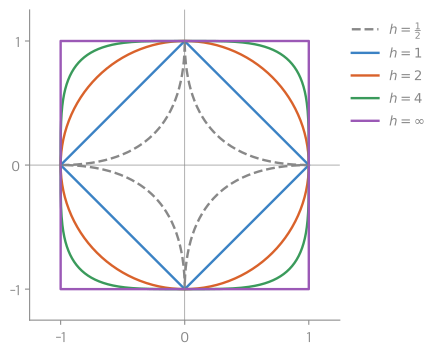
| 04 | 민코프스키 거리 | 좌표 차이의 \(h\)제곱 합. \(h = 1\) 맨해튼, \(h = 2\) 유클리드 | fig1 · plot · verify | — |
| 05 | 데이터 정제 | 빈칸 채우기, 비닝·회귀·이상치로 잡음 다듬기 | verify | — |
| 06 | 데이터 통합 | 같은 대상 맞추기, 상관 분석으로 중복 속성 찾기 | — | — |
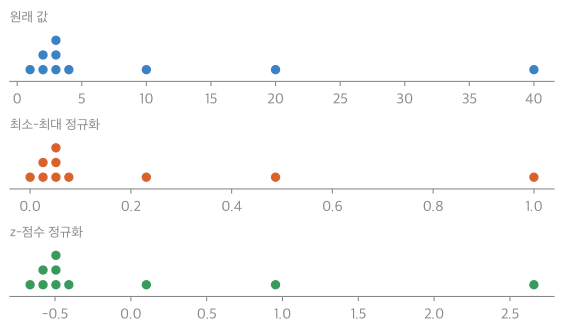
| 07 | 정규화 | 최소-최대(0~1)와 z-점수(평균 0, 표준편차 1) | fig1 · plot · verify | — |
| 08 | 이산화 | 수치를 구간 이름으로. 같은 폭 칸 나누기, 개념 계층 | fig1 · plot · verify | — |
| 09 | 표본 추출 | 비복원, 복원, 층화 추출 | verify | — |
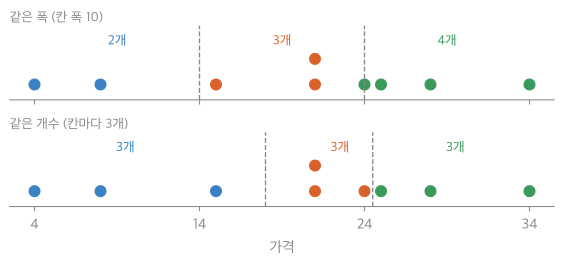
떠올려 보기: 노트를 닫고 속성의 다섯 종류, 종류마다 쓰는 비유사도·상관 척도, 전처리의 세 단계(정제·통합·변환)를 한 장의 표로 써 본다.
빈발 패턴
읽기 전에
- {A, B}가 빈발이 아니면 {A, B, C}를 세어 볼 필요가 있을까? → Apriori 알고리즘
- 후보 묶음을 하나도 만들지 않고 빈발 묶음을 모두 찾을 수 있을까? → FP-Growth
- 학생의 75%가 시리얼을 먹는다. ‘축구 → 시리얼’ 신뢰도 67%는 좋은 규칙일까? → 리프트
| 번호 | 개념 | 한 줄 | 개념 코드 | 연습 |
|---|---|---|---|---|
| 10 | 빈발 패턴 | 자주 함께 나오는 항목 묶음. 지지도 ≥ min_sup | verify | — |
| 11 | 연관 규칙 | \(X \Rightarrow Y\)의 지지도와 신뢰도 \(P(Y \mid X)\) | — | — |
| 12 | 닫힌 패턴과 최대 패턴 | 지지도가 같은 상위 집합이 없음(손실 없음) / 빈발 상위 집합이 없음(지지도 잃음) | verify | — |
| 13 | Apriori 알고리즘 | 아프리오리 성질로 후보를 결합·가지치기, 크기별로 DB를 훑는다 | impl | Apriori 예제 사다리 · 문제 코드 |
| 14 | ECLAT | 항목 → 거래 번호 목록, 교집합으로 지지도. DB 한 번 | impl | — |
| 15 | FP-Growth | 빈도순 앞부분 트리로 압축, 조건부 패턴 베이스로 재귀. 후보 없음, DB 두 번 | impl | FP-Growth 예제 사다리 · 문제 코드 |
| 16 | 빈발 패턴 마이닝 방법 비교 | 가르는 질문: DB를 몇 번 훑나, 메모리에 무엇을 드나 | — | — |
| 17 | 리프트 | 신뢰도 ÷ 뒤쪽의 원래 비율. 1보다 작으면 음의 상관 | verify | — |
| 18 | 널 불변 측정 | 널 거래에 흔들리지 않는 Kulc와 불균형 비율 IR | fig1 · plot · verify | — |
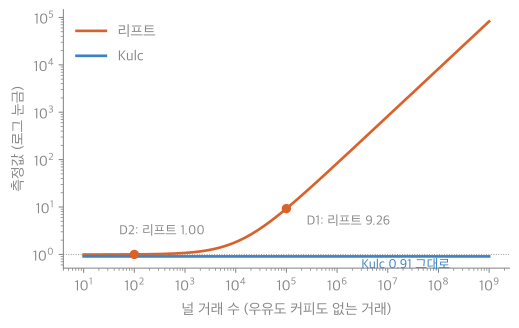
떠올려 보기: 노트를 닫고 같은 거래 9개(Apriori 예제 사다리 문제 3)로 Apriori의 \(C_k\)·\(L_k\)와 FP-tree를 각각 그린 뒤, 세 방법(Apriori, ECLAT, FP-Growth)의 DB 훑기·후보·메모리를 표로 비교해 본다.
앙상블
읽기 전에
- 서로 상관계수가 0.5인 모델을 무한히 많이 평균 내면 분산은 0이 될까? → 앙상블 학습
- 자료가 한 벌뿐인데 서로 다른 모델 여러 개를 어떻게 만들까? → 배깅과 랜덤 포레스트
- 겨우 찍기보다 나은 모델들만으로 훈련 오류를 0으로 만들 수 있을까? → 부스팅과 AdaBoost
| 번호 | 개념 | 한 줄 | 개념 코드 | 연습 |
|---|---|---|---|---|
| 19 | 분류 평가 지표 | 정확도, 정밀도, 재현율, F1. 어떤 실수가 비싼지로 고른다 | fig1 · plot · verify | — |
| 20 | 앙상블 학습 | 평균의 분산 \(\sigma^2/k + \frac{k-1}{k}\rho\sigma^2\). 서로 다를수록 효과가 크다 | fig1 · plot · verify | — |
| 21 | 배깅과 랜덤 포레스트 | 부트스트랩 표본마다 모델, 투표·평균. 랜덤 포레스트는 속성도 뽑는다 | fig1 · plot · impl | — |
| 22 | 부스팅과 AdaBoost | 틀린 자료의 무게를 키우며 차례로 훈련, 가중 투표 | impl · fig1 · plot | — |
| 23 | 배깅과 부스팅 비교 | 가르는 질문: 모델들이 서로를 보며 만들어지는가 | — | — |
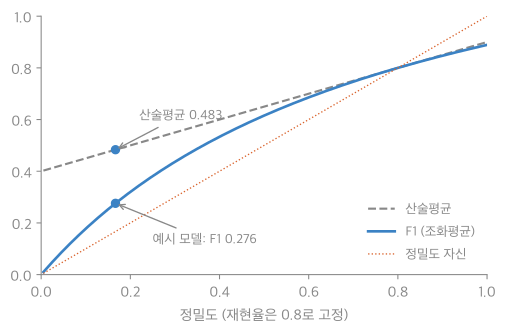
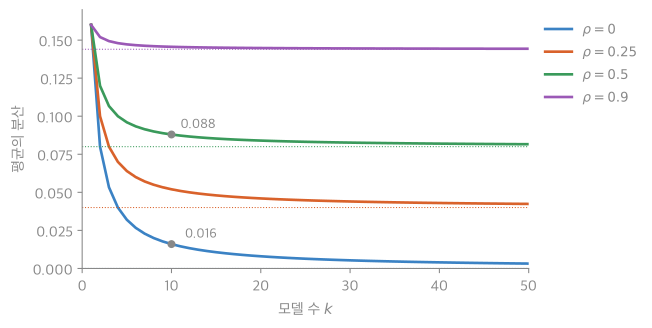
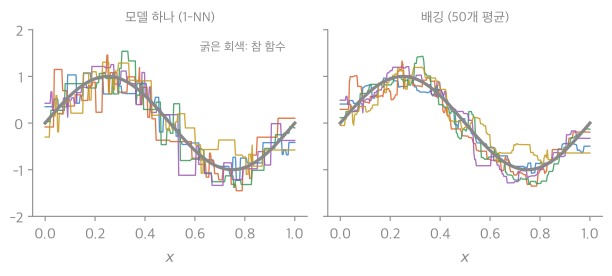
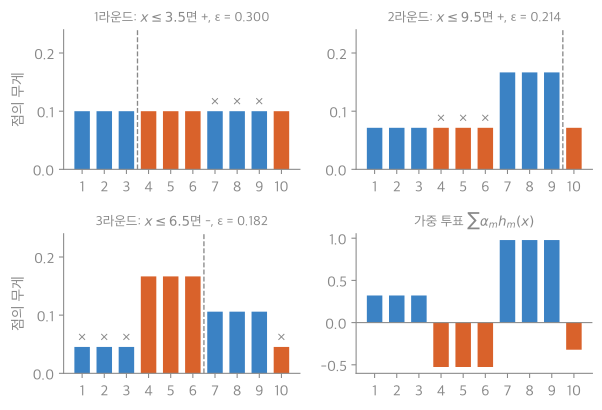
떠올려 보기: 노트를 닫고 오차의 세 부분(편향², 분산, 잡음), 앙상블 분산 공식, 배깅과 부스팅이 각각 무엇을 줄이는지와 그 이유를 한 장에 써 본다.
군집화 기초와 밀도 기반 군집화
읽기 전에
| 번호 | 개념 | 한 줄 | 개념 코드 | 연습 |
|---|---|---|---|---|
| 24 | 군집 분석 | 정답 없이 비슷한 것끼리 묶기. 안쪽은 닮고 서로는 다르게 | — | — |
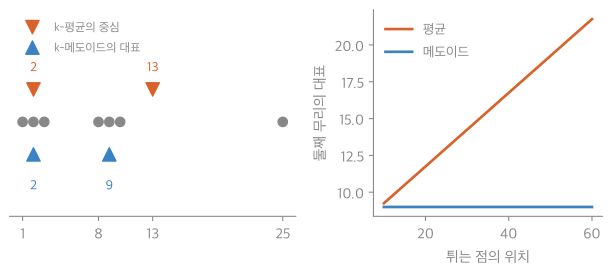
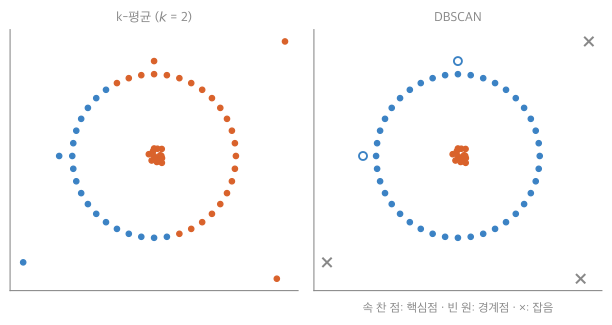
| 25 | k-평균 | 가까운 중심에 배정 → 평균으로 갱신. 반드시 멈추지만 국소 최적 | fig1 · fig2 · impl · plot | k-평균 예제 사다리 · 문제 코드 |
| 26 | k-메도이드 | 대표를 실제 점으로. 이상치에 견고, 아무 비유사도, 대신 느림 | fig1 · impl · plot | — |
| 27 | k-평균과 k-메도이드 비교 | 가르는 질문: 대표가 실제 점이어야 하는가 | — | — |
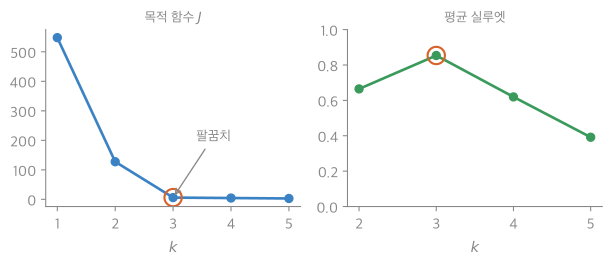
| 28 | 군집 수 고르기 | 엘보(개선이 꺾이는 곳)와 실루엣 \(s = (b-a)/\max(a,b)\) | fig1 · plot · verify | — |
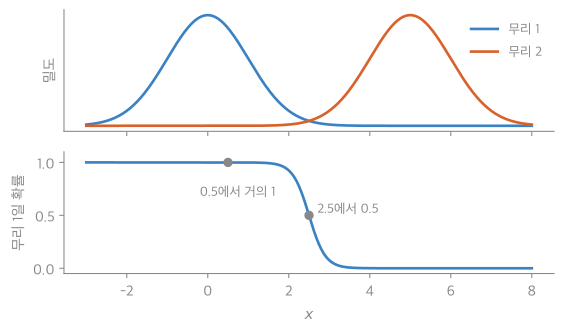
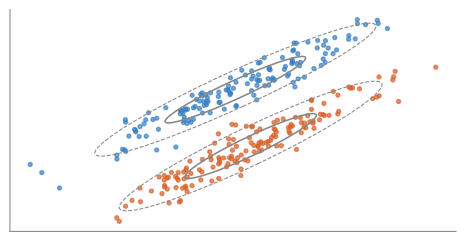
| 29 | 가우스 혼합 모델 | 가우스 분포의 혼합. 점마다 군집별 확률(부드러운 배정) | fig1 · fig2 · plot | — |
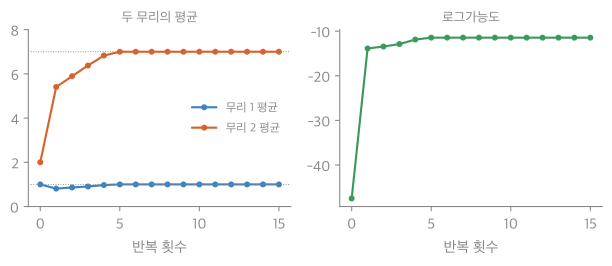
| 30 | EM 알고리즘 | 책임도(E)와 가중 평균·공분산·비중(M)을 번갈아. 가능도는 줄지 않는다 | fig1 · plot · impl | — |
| 31 | DBSCAN | 반지름 안 이웃이 많은 핵심점에서 퍼져 나가 묶기. \(k\) 불필요, 잡음 분리 | fig1 · impl · plot | — |
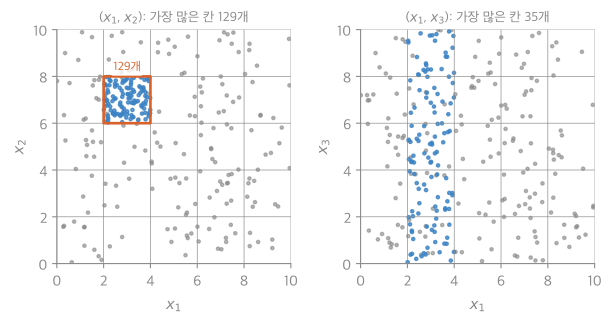
| 32 | CLIQUE | 격자 칸의 밀도, 아프리오리 성질로 부분공간 찾기 | fig1 · impl · plot | — |
| 33 | 군집화 알고리즘 비교 | 가르는 질문: \(k\)를 아는가, 모양을 가정할 수 있는가 | — | — |
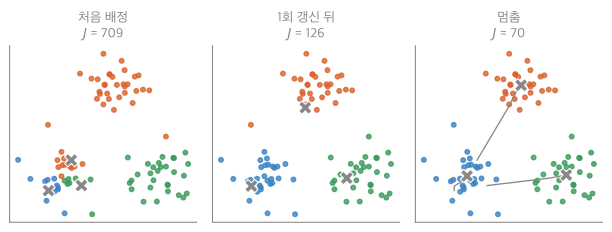
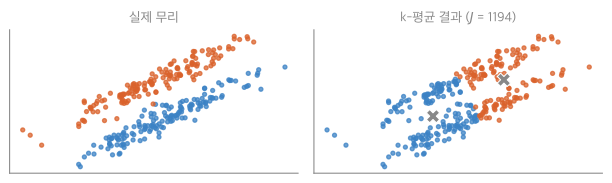
떠올려 보기: 노트를 닫고 k-평균, k-메도이드, GMM, DBSCAN, CLIQUE를 ‘무엇을 비슷하다고 보는가’, ‘\(k\) 필요’, ‘모양 가정’, ‘잡음’ 네 칸의 표로 쓰고, k-평균과 EM이 둘 다 ‘번갈아 고치기’라는 것을 한 문단으로 설명해 본다.
고차원 군집화와 그래프 군집화
읽기 전에
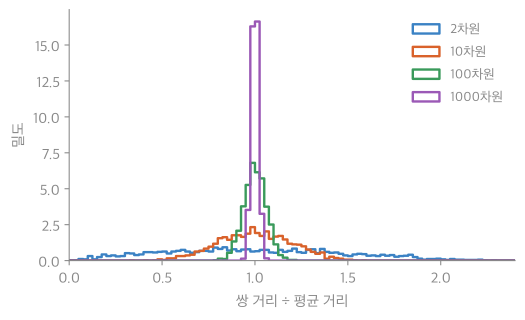
- 점 1,000개 중 가장 가까운 10개를 담으려면, 100차원에서는 공간의 얼마를 덮어야 할까? → 차원의 저주
- 문서 × 단어 표를 두 표의 곱으로 나누면 ‘주제’가 나올까? → 행렬 분해 군집화
- 잘리는 선만 가장 적게 하도록 그래프를 자르면 어떤 답이 나올까? → 그래프 분할과 정규화 컷
| 번호 | 개념 | 한 줄 | 개념 코드 | 연습 |
|---|---|---|---|---|
| 34 | 차원의 저주 | 차원이 늘면 가까운 이웃도 멀고 모든 거리가 비슷해진다 | fig1 · plot · verify | — |
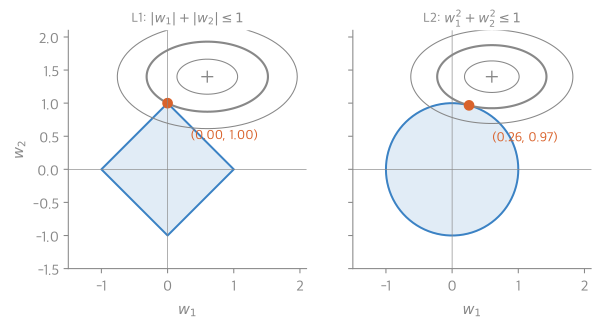
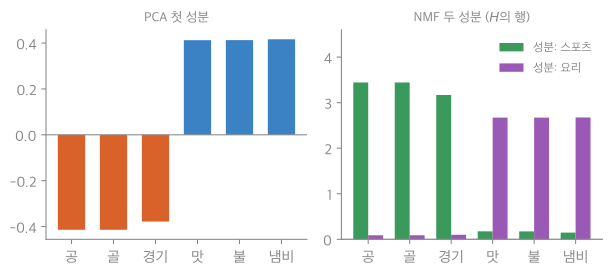
| 35 | 행렬 분해 군집화 | \(X \approx WH\), \(W, H \ge 0\). 더하기만 하는 부분이 군집, L1로 뚜렷하게 | fig1 · impl · plot | — |
| 36 | PCA와 NMF 비교 | 가르는 질문: 성분을 빼서 써도 되는가 | fig1 · plot | — |
| 37 | 그래프 분할과 정규화 컷 | 유사도 그래프를 자르기. 컷만 줄이면 외딴 점 하나, 정규화 컷으로 균형 | — | — |
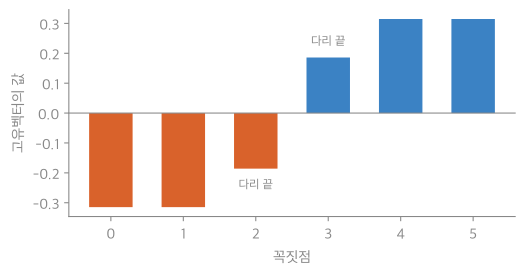
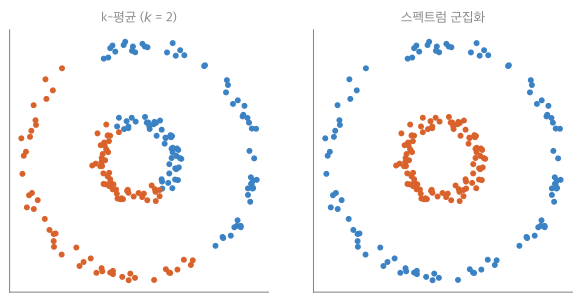
| 38 | 스펙트럼 군집화 | 라플라시안 \(L = D - W\)의 둘째 고유벡터 부호로 2-분할, 여러 개로 k-분할 | fig1 · fig2 · impl · plot | — |
떠올려 보기: 노트를 닫고 고차원 군집화의 세 갈래(차원 줄이기 PCA, 부분 분해 NMF, 부분공간 CLIQUE)와 그래프 군집화의 흐름(유사도 그래프 → 정규화 컷 → 라플라시안 고유벡터 → k-평균)을 한 장에 그려 본다.
추천 시스템 소개와 평가
읽기 전에
| 번호 | 개념 | 한 줄 | 개념 코드 | 연습 |
|---|---|---|---|---|
| 39 | 추천 시스템 | 좋아할 것 몇 개만 골라 보여 주기. 내용 정보와 협업 정보 | — | — |
| 40 | 내용 기반 추천 | TF-IDF 아이템 프로필과 사용자 프로필의 코사인. 새 아이템에 강함 | verify | — |
| 41 | 협업 필터링 | 비슷한 사용자(또는 아이템)의 평점을 평균 보정해 빌려 오기 | impl | — |
| 42 | 추천 방법 비교 | 가르는 질문: 새 것이 사용자인가 아이템인가, 다양성인가 규모인가 | — | — |
| 43 | 추천 평가 지표 | 평점 오차(MAE, RMSE), 목록(P·R·HR@K), 순위(MR, MRR, nDCG) | verify | — |
떠올려 보기: 노트를 닫고 내용 기반·사용자 기반·아이템 기반을 ‘근거, 쓰는 정보, 장점, 한계’ 표로 쓰고, 평가 지표 세 갈래(평점, 목록, 순위)의 대표 식을 하나씩 써 본다.
행렬 분해 기반 추천과 희소성
읽기 전에
- 평점표의 빈칸을 0으로 채우면 무엇이 문제일까? → 행렬 분해 추천
- ‘봤다’는 기록만 있고 ‘싫다’는 기록이 없으면 무엇을 배워야 할까? → 단일 클래스 협업 필터링
- 비어 있는 칸 중 일부만 0으로 채우면 왜 추천이 좋아질까? → 0 주입
| 번호 | 개념 | 한 줄 | 개념 코드 | 연습 |
|---|---|---|---|---|
| 44 | 행렬 분해 추천 | \(R \approx PQ^\top\). PureSVD, 편향 \(\mu + b_u + b_i + p_u^\top q_i\), SVD++ | fig1 · impl · plot | — |
| 45 | 단일 클래스 협업 필터링 | 1과 빈칸만으로. WRMF는 빈칸에 작은 무게, BPR은 순서를 배운다 | impl | — |
| 46 | 0 주입 | 사용 전 선호가 가장 낮은 빈칸에만 0을 넣어 행렬을 빽빽하게 | verify | — |
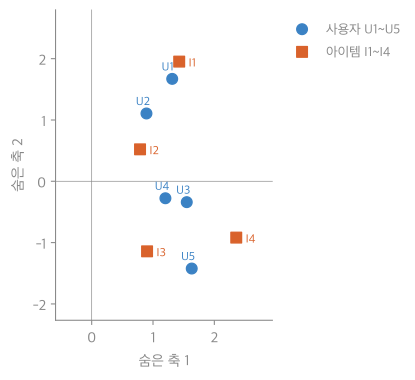
떠올려 보기: 노트를 닫고 PureSVD, 편향 MF, SVD++, WRMF, BPR을 ‘자료, 개인화, 학습, 손실, 목표’ 다섯 칸의 표로 써 본다.
PageRank
개념: PageRank는 공학수학의 PageRank 문서에 과목별 관점으로 합쳤다(무작위 서퍼, 거듭제곱법, 막다른 페이지, 거미줄 함정, 구글 행렬).
다른 과목과의 연결
- 통계와 유사도의 기초 내용은 공학수학 문서에
과목별 관점으로 합쳐 두었다(위 ‘먼저 알아야 할 것’). - Apriori 알고리즘 ↔ 너비 우선 탐색, FP-Growth ↔ 트라이 (알고리즘): 크기별로 넓혀 가는 탐색과 앞부분 공유 트리
- DBSCAN ↔ 깊이 우선 탐색 (알고리즘): 핵심점에서 퍼져 나가는 그래프 탐색
- CLIQUE ↔ Apriori 알고리즘 (같은 과목): 같은 아프리오리 가지치기를 격자 칸에 쓴다
- 스펙트럼 군집화 ↔ 주성분 분석 (공학수학): 둘 다 대칭행렬의 고유벡터로 새 공간을 만든다. PCA는 큰 고윳값, 스펙트럼은 작은 고윳값
- 널 불변 측정 ↔ 자카드 계수 (같은 과목): 둘 다 ‘둘 다 없음’을 빼서 희소한 자료를 지킨다
흐름
graph TD
  C1["01 속성의 종류"]
  C2["02 카이제곱 상관 분석"]
  C3["03 범주형 속성의 비유사도"]
  C4["04 민코프스키 거리"]
  C5["05 데이터 정제"]
  C6["06 데이터 통합"]
  C7["07 정규화"]
  C8["08 이산화"]
  C9["09 표본 추출"]
  C10["10 빈발 패턴"]
  C11["11 연관 규칙"]
  C12["12 닫힌 패턴과 최대 패턴"]
  C13["13 Apriori 알고리즘"]
  C14["14 ECLAT"]
  C15["15 FP-Growth"]
  C16["16 빈발 패턴 마이닝 방법 비교"]
  C17["17 리프트"]
  C18["18 널 불변 측정"]
  C19["19 분류 평가 지표"]
  C20["20 앙상블 학습"]
  C21["21 배깅과 랜덤 포레스트"]
  C22["22 부스팅과 AdaBoost"]
  C23["23 배깅과 부스팅 비교"]
  C24["24 군집 분석"]
  C25["25 k-평균"]
  C26["26 k-메도이드"]
  C27["27 k-평균과 k-메도이드 비교"]
  C28["28 군집 수 고르기"]
  C29["29 가우스 혼합 모델"]
  C30["30 EM 알고리즘"]
  C31["31 DBSCAN"]
  C32["32 CLIQUE"]
  C33["33 군집화 알고리즘 비교"]
  C34["34 차원의 저주"]
  C35["35 행렬 분해 군집화"]
  C36["36 PCA와 NMF 비교"]
  C37["37 그래프 분할과 정규화 컷"]
  C38["38 스펙트럼 군집화"]
  C39["39 추천 시스템"]
  C40["40 내용 기반 추천"]
  C41["41 협업 필터링"]
  C42["42 추천 방법 비교"]
  C43["43 추천 평가 지표"]
  C44["44 행렬 분해 추천"]
  C45["45 단일 클래스 협업 필터링"]
  C46["46 0 주입"]
  C1 --> C2
  C1 --> C3
  C3 --> C4
  C1 --> C5
  C2 --> C6
  C5 --> C6
  C4 --> C7
  C5 --> C8
  C1 --> C9
  C1 --> C10
  C10 --> C11
  C10 --> C12
  C10 --> C13
  C11 --> C13
  C13 --> C14
  C13 --> C15
  C13 --> C16
  C14 --> C16
  C15 --> C16
  C11 --> C17
  C2 --> C17
  C17 --> C18
  C19 --> C20
  C20 --> C21
  C9 --> C21
  C20 --> C22
  C21 --> C23
  C22 --> C23
  C4 --> C24
  C24 --> C25
  C7 --> C25
  C25 --> C26
  C25 --> C27
  C26 --> C27
  C25 --> C28
  C25 --> C29
  C29 --> C30
  C24 --> C31
  C4 --> C31
  C31 --> C32
  C13 --> C32
  C8 --> C32
  C25 --> C33
  C29 --> C33
  C31 --> C33
  C32 --> C33
  C4 --> C34
  C33 --> C34
  C34 --> C35
  C35 --> C36
  C24 --> C37
  C37 --> C38
  C25 --> C38
  C24 --> C39
  C39 --> C40
  C39 --> C41
  C40 --> C42
  C41 --> C42
  C39 --> C43
  C19 --> C43
  C41 --> C44
  C35 --> C44
  C44 --> C45
  C43 --> C45
  C45 --> C46
  C41 --> C46