k-평균과 같은 방식으로 무리를 나누지만, 무리의 대표를 평균 위치가 아니라 무리 안의 실제 자료점 하나로 고른다. 다른 점들까지의 거리 합이 가장 작은 점, 즉 무리 한가운데 있는 실제 점이 대표가 된다. 대표가 실제 고객이나 실제 문서라 해석하기 쉽고, 튀는 점 하나에 끌려가지 않는다. 대신 대표를 고를 때 무리 안 모든 점 쌍의 거리를 재야 해서 느리다.
예시로 보기
k-평균에서 점 1, 2, 3, 8, 9, 10, 25의 둘째 중심은 25에 끌려 13이 되었다. 같은 자료를 \(k = 2\), 처음 대표 1, 2로 k-메도이드에 넣는다. 거리는 두 수의 차이다1.
| 단계 | 대표 | 소속 | 비용(대표까지 거리 합) |
|---|---|---|---|
| 1 | 1, 2 | {1} / {2, 3, 8, 9, 10, 25} | 45 |
| 2 | 1, 8 | {1, 2, 3} / {8, 9, 10, 25} | 23 |
| 3 | 2, 9 | 그대로 | 20 → 멈춤 |
3단계에서 둘째 무리 {8, 9, 10, 25}의 대표를 고른다. 8은 다른 점들까지 거리 합이 \(1 + 2 + 17 = 20\), 9는 \(1 + 1 + 16 = 18\)이다. 9가 대표가 된다. 25가 아무리 멀어도 대표는 실제 점 중에서 고르므로 8~10 근처를 벗어나지 않는다. 중앙값이 평균보다 이상치에 덜 흔들리는 것과 같은 이유다.
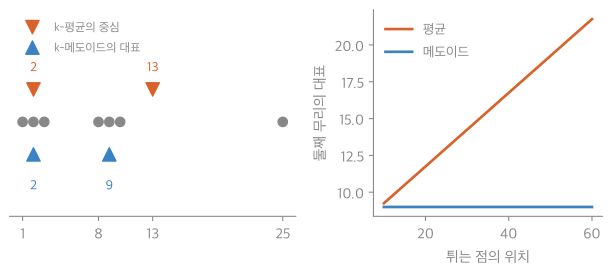
왼쪽은 같은 점 일곱 개에서 k-평균의 중심(2, 13)과 k-메도이드의 대표(2, 9)다. 오른쪽은 둘째 무리 {8, 9, 10, 튀는 점}에서 튀는 점을 10부터 60까지 멀리 보낸 결과다. 평균은 따라서 계속 커지고, 메도이드는 9에 머문다2.
정의
k-메도이드는 각 군집을 실제 자료점 하나(메도이드)로 대표하는 중심 기반 군집화다. 메도이드는 군집에서 가장 대표적인 실제 대상이라, 대표 고객 프로필, 대표 문서, 대표 사진처럼 해석하기 쉽다.
목적 함수는 점과 그 메도이드 사이의 비유사도 합이다.
\[\min \sum_{\alpha=1}^{k}\sum_{\mathbf x_i \in C_\alpha} \operatorname{dist}(\mathbf x_i, \mathbf m_\alpha)\]\(C_\alpha\)는 군집 \(\alpha\)에 속한 점들, \(\mathbf m_\alpha \in C_\alpha\)는 그 메도이드다.
k-메도이드는 점과 점 사이의 거리만 재고 평균을 내지 않는다. 그래서 \(\operatorname{dist}\) 자리에 유클리드 거리뿐 아니라 맨해튼 거리, 편집 거리 같은 아무 비유사도나 넣을 수 있다. k-평균은 다르다. “평균이 거리 제곱 합을 가장 작게 만든다”는 성질에 기대므로 (제곱) 유클리드 거리에 묶인다3.
알고리즘(PAM, 메도이드 둘레로 나누기):
k개 점을 무작위로 골라 메도이드로 정한다
반복:
    각 점을 가장 가까운 메도이드의 군집에 넣는다
    각 군집에서 같은 군집 다른 점들까지 거리 합이 가장 작은 점을 새 메도이드로 고른다
메도이드가 바뀌지 않으면 멈춘다
k-메도이드의 결정적 한계는 계산량이다. 메도이드를 고를 때 군집 안 점 \(m\)개마다 다른 점 \(m\)개까지 거리를 재므로 \(m^2\)번이 든다. 점 100개짜리 군집 하나에 1만 번이다. k-평균은 평균 한 번으로 끝난다1.
활용
- 수치가 아닌 자료(문자열, 범주형 속성, 그래프 위의 점)를 군집화할 때 쓴다. 범주형 속성의 비유사도를 그대로 넣을 수 있다.
- 단어 “data, date, dated, mining, minning, dining”을 편집 거리로 두 무리로 나누면 메도이드는 “date”와 “mining”이다1.
연결
- 선수: k-평균
- 평균 대 중앙값의 견고성: 기술통계
- 비교: k-평균과 k-메도이드 비교
과목별 관점
자료와 정보 (2-1학기). k-평균이 튀는 값에 약하다는 데서 출발해, 평균 대신 무리 한가운데 있는 실제 점을 대표로 쓴다. 이 문서와 다른 곳은 대표를 고치는 방법이다.
- 메도이드를 식으로. 메도이드는 \(x_{\text{medoid}} = \arg\min_{y \in \mathcal X}\sum_{i=1}^{n} d(y, x_i)\)다. 자료 집합 \(\mathcal X\)의 점 \(y\)를 하나씩 후보로 놓고, 다른 모든 점 \(x_i\)까지의 거리 \(d\)를 더해, 그 합이 가장 작은 \(y\)를 고른다는 뜻이다(\(\arg\min\)은 “가장 작게 만드는 것”을 가리킨다). “평균 비유사도가 가장 작은 점”이라고 정의해도 된다. 합을 점 수로 나눈 것이라 같은 점이 뽑힌다.
-
맞바꾸기로 고치는 PAM. 위 의사코드는 군집마다 대표를 다시 뽑는다. 본래의 PAM은 메도이드 하나와 메도이드가 아닌 점 하나를 맞바꿔 본다.
  1. 비용이 작아지도록 점 k개를 하나씩 골라 처음 메도이드로 삼는다
  2. 각 점을 가장 가까운 메도이드에 붙인다
  3. 비용이 줄어드는 동안 되풀이한다:
       메도이드 m과 메도이드가 아닌 점 x의 모든 짝에 대해
           둘을 맞바꾸면 비용이 얼마나 바뀌는지 계산한다
       비용을 가장 많이 줄이는 짝을 실제로 맞바꾼다
       비용을 줄이는 짝이 없으면 멈춘다
맞바꿀 짝은 메도이드 \(k\)개 × 메도이드가 아닌 점 \(N - k\)개로 \(k(N-k)\)개다. 짝마다 메도이드가 아닌 점 \(N - k\)개의 비용을 다시 계산하므로, 반복 한 번에 \(O(k(N-k)^2)\)이 든다. 점 10개를 \(k = 2\)로 나누면 짝이 \(2 \times 8 = 16\)개다4.
- 예. 점 10개를 \(k = 2\)로 나눈다. 메도이드 둘을 아무렇게나 고르고 나머지 점을 가까운 쪽에 붙이면 총비용이 20이다. 메도이드 하나를 다른 점과 맞바꿔 계산하니 26이다. 비용이 늘었으므로 맞바꾸지 않는다. 바뀌는 것이 없을 때까지 이 일을 되풀이한다.
- k-평균과 나란히. 같은 자료에 k-메도이드를 돌리면 여섯 번째 반복에서 멈추고, k-평균의 결과와 소속이 다른 점은 3개뿐이다. 튀는 값이 없는 자료에서는 두 방법의 답이 거의 같다.
- 장단점. 이상치에 강하다. 어떤 비유사도든 쓸 수 있다(k-평균은 유클리드 공간을 가정한다). 군집마다 대표 점이 나와 풀이하기 쉽다. 대신 계산이 더 든다. PAM의 결과도 처음 값에 따라 달라지고, 작은 자료에서는 잘 돌지만 큰 자료에서는 느려서 쓰기 어렵다.
확인 문제
C1 메도이드의 정의와 k-메도이드의 목적 함수를 쓰라.
답: 메도이드는 군집 안의 실제 자료점 중 같은 군집 다른 점들까지의 비유사도 합이 가장 작은 점이다. 목적 함수는 \(\sum_\alpha\sum_{\mathbf x \in C_\alpha}\operatorname{dist}(\mathbf x, \mathbf m_\alpha)\)의 최소화다.
C2 군집 {8, 9, 10, 25}의 메도이드와 평균을 각각 구하라(거리는 차이의 절댓값).
답: 거리 합은 8: 20, 9: 18, 10: 18, 25: 48. 가장 작은 9(같으면 먼저 나온 점)가 메도이드다. 평균은 13이다. 이상치 25가 평균은 크게 끌지만 메도이드는 거의 끌지 못한다.
C3 k-메도이드가 k-평균과 달리 편집 거리 같은 비유사도로도 돌아가는 이유는?
답: k-메도이드는 점들 사이의 거리만 계산하고 새 대표도 실제 점 중에서 고른다. k-평균은 갱신 단계에서 점들의 평균을 내야 하는데, 문자열의 “평균”은 정의되지 않고, 평균이 최적이라는 성질도 거리 제곱 합(유클리드)일 때만 맞다.
C4 점 열 개 \((3,8), (4,7), (2,6), (3,4), (7,6), (8,5), (6,4), (7,4), (7,3), (6,2)\)를 맨해튼 거리로 나눈다. 지금 메도이드는 \((3,8)\)과 \((6,4)\)다. \((6,4)\)를 \((6,2)\)와 맞바꾼 비용과 \((7,4)\)와 맞바꾼 비용을 구하라. PAM은 어느 쪽으로 맞바꾸는가?
답: 지금 비용은 \(2 + 3 + 3 + 3 + 3 + 1 + 2 + 2 = 19\)다. \((6,2)\)로 바꾸면 \(2 + 3 + 4 + 5 + 5 + 2 + 3 + 2 = 26\)으로 늘어난다. \((7,4)\)로 바꾸면 \(2 + 3 + 4 + 2 + 2 + 1 + 1 + 3 = 18\)로 줄어든다. PAM은 \((7,4)\)로 맞바꾼다.
이유: PAM은 맞바꿀 수 있는 짝 16개의 비용을 모두 계산해 가장 작은 것을 고르고, 지금보다 줄어들 때만 실제로 바꾼다. 16개 가운데 18이 가장 작다. \((6,2)\)는 오른쪽 무리의 맨 아래 끝에 있어 다른 점들에서 멀다5.
-
26_k-medoids_plot.py로 그렸고, k-평균의 중심 2, 13과 메도이드 2, 9, 튀는 점이 10~60일 때 메도이드가 늘 9인 것을 같은 코드로 확인했다. 10도 다른 점들까지 거리 합이 \(2 + 1 + 15 = 18\)로 9와 같다. 거리 합이 같으면 앞에 있는 9를 고른다. ↩
-
k-메도이드에 아무 비유사도나 넣을 수 있다는 것은 26_k-medoids_impl.py에서 편집 거리로 단어를 묶어 확인했다. ↩
-
PAM의 반복 한 번 복잡도로 널리 알려진 값이고(Kaufman & Rousseeuw, 1990), 맞바꿀 짝의 수 \(k(N-k) = 16\)은 파이썬으로 세어 확인했다. ↩
-
읽은 좌표로 계산하면 처음 비용이 19, \((6,2)\)로 맞바꾼 비용이 26이다. 맞바꾸면 비용이 늘어난다는 결론은 같다. 세 비용과 짝 16개 가운데 18이 가장 작다는 것을 파이썬으로 계산해 확인했다. ↩