모델 하나를 고르는 대신 여러 모델의 예측을 평균 내거나 투표시킨다. 한 모델이 훈련 자료에 휘둘려 엉뚱하게 튀어도, 다른 모델들과 섞이면 튄 부분이 서로 상쇄되어 예측이 안정된다. 그래서 정확도가 오르고 과적합이 줄어든다. 단, 모델들이 서로 똑같이 틀리면 아무리 많이 모아도 소용없어서, 모델들이 서로 달라야 효과가 있다.
예시로 보기
모델마다 데이터에 대한 가정이 달라서(결정 트리, 나이브 베이즈, 퍼셉트론, 로지스틱 회귀, SVM) 같은 자료에서도 성능이 다르다. 그렇다면 하나를 고르는 대신 여럿을 섞으면 어떨까?
어떤 점의 정답이 2인데, 모델 하나는 훈련 자료에 따라 예측이 평균 2.3에서 표준편차 0.4로 흔들리고, 측정 자체에도 표준편차 0.5의 잡음이 있다. 이 모델의 제곱 오차 평균은 세 부분의 합이다1.
| 부분 | 뜻 | 값 |
|---|---|---|
| 편향² | 예측의 평균이 정답에서 벗어난 정도 | \(0.3^2 = 0.09\) |
| 분산 | 훈련 자료가 바뀔 때 예측이 흔들리는 정도 | \(0.4^2 = 0.16\) |
| 잡음 | 데이터 자체의 무작위성. 어떤 모델로도 못 줄인다 | \(0.5^2 = 0.25\) |
이런 모델을 서로 독립적으로 10개 만들어 평균 내면, 분산 0.16이 \(\frac{0.16}{10} = 0.016\)으로 준다. 편향은 그대로다. 모델들이 반쯤 닮아 상관계수가 0.5면 분산은 0.088까지만 준다.
정의
앙상블 학습은 하나의 모델을 고르는 대신 여러 “약한” 모델을 합쳐, 그 예측을 평균(회귀)이나 투표(분류)로 모아 더 강한 하나의 예측을 만든다. 정확도를 높이고, 과적합을 줄이고, 성능을 더 안정되게 한다.
오차 분해. 참값을 \(y = f(x) + \epsilon\)(\(f\)는 모르는 참 함수, \(\epsilon\)은 평균 0, 분산 \(\sigma_\epsilon^2\)인 잡음), 모델의 예측을 \(\hat f(x)\)라 하면 제곱 오차의 기댓값은
\[\mathbb{E}[(y - \hat f(x))^2] = \underbrace{(\mathbb{E}[\hat f(x)] - f(x))^2}_{\text{편향}^2} + \underbrace{\mathbb{E}[(\hat f(x) - \mathbb{E}[\hat f(x)])^2]}_{\text{분산}} + \underbrace{\mathbb{E}[\epsilon^2]}_{\text{잡음}}\]정리 (평균의 분산). 기본 모델 \(f_1, \dots, f_k\)의 분산이 모두 \(\sigma^2\)이고, 서로 다른 두 모델의 상관계수가 모두 \(\rho\)이면, 평균 \(f_{ens} = \frac1k\sum_{i=1}^{k} f_i\)의 분산은
\[\operatorname{Var}(f_{ens}) = \frac{\sigma^2}{k} + \frac{k - 1}{k}\rho\sigma^2\]말로 하면, 모델끼리 닮지 않은 몫(\(1 - \rho\))은 \(k\)로 나뉘어 사라지고, 닮은 몫(\(\rho\sigma^2\))은 아무리 모아도 남는다. 대입하면 다음과 같다.
- \(\rho = 0\)(서로 독립): \(\frac{\sigma^2}{k}\). \(k\)가 커질수록 0으로 간다.
- \(\rho = 1\)(모두 같은 모델): \(\sigma^2\). 평균 내도 줄지 않는다.
- \(k \to \infty\): \(\rho\sigma^2\)로 다가간다.
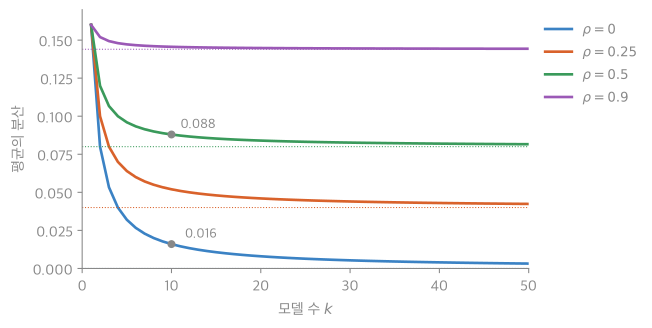
모델 하나의 분산을 예시의 0.16으로 두고 모델 수 \(k\)를 늘렸다. 점선은 \(\rho\sigma^2\), 곧 아무리 모아도 남는 몫이다. 서로 독립(\(\rho = 0\))이면 0까지 내려가지만, \(\rho = 0.9\)면 처음부터 거의 줄지 않는다2.
증명
분산을 합의 공식으로 펼친다. 자주 보는 \(\frac{\sigma^2}{k}\)는 \(\rho = 0\)인 특수한 경우다.
증명 펼치기
- \(\operatorname{Var}\left(\frac1k\sum f_i\right) = \frac{1}{k^2}\operatorname{Var}\left(\sum f_i\right)\) — \(\operatorname{Var}(aX) = a^2\operatorname{Var}(X)\)
- \(\operatorname{Var}\left(\sum f_i\right) = \sum_i \operatorname{Var}(f_i) + \sum_{i \ne j}\operatorname{Cov}(f_i, f_j)\) — 합의 분산(공분산 문서)
- 첫 합은 \(k\sigma^2\)이다. 둘째 합의 항은 \(k(k - 1)\)개이고 각각 \(\operatorname{Cov}(f_i, f_j) = \rho\sigma\sigma = \rho\sigma^2\)이다. — 가정, 상관계수의 정의
- 대입하면 \(\frac{1}{k^2}\left(k\sigma^2 + k(k - 1)\rho\sigma^2\right) = \frac{\sigma^2}{k} + \frac{k - 1}{k}\rho\sigma^2\). ∎
오차 분해의 증명은 \(f - \hat f = (f - \mathbb{E}\hat f) + (\mathbb{E}\hat f - \hat f)\)로 나눠 제곱을 펼친다. 교차항은 \(\mathbb{E}[\hat f - \mathbb{E}\hat f] = 0\)이라서, 잡음과의 교차항은 \(\epsilon\)이 평균 0이고 \(\hat f\)와 독립이라서 사라진다1.
스스로 설명해 보기
1. 2단계에서 공분산 항이 \(k(k-1)\)개인 이유
순서 있는 쌍 \((i, j)\)에서 \(i \ne j\)인 것을 센다. \(i\)를 \(k\)가지, \(j\)를 나머지 \(k - 1\)가지 고르므로 \(k(k - 1)\)개다. \((1, 2)\)와 \((2, 1)\)을 따로 센다.
2. 평균의 분산을 곧바로 \(\frac{1}{k^2}\sum \operatorname{Var}(f_i)\)로 쓰는 계산에 숨은 가정
공분산 항을 지웠으므로 모델끼리 상관이 없다(서로 독립)고 가정한 것이다. “\(\operatorname{Var}(f_i) \approx \operatorname{Var}(f_j)\)“라는 가정만으로는 모자란다. 그것은 3단계의 \(k\sigma^2\)를 위한 가정이고, 공분산이 0이라는 가정은 따로 필요하다. 위 일반식이 그 빠진 항을 되살린다.
3. 앙상블이 편향은 줄이지 못하는 이유
평균의 기댓값은 기댓값의 평균이다. 모든 모델이 같은 편향 \(b\)를 가지면 평균도 편향 \(b\)다. 평균 내기는 흔들림만 줄인다.
이 증명의 핵심 아이디어는?
평균의 분산 = (혼자 흔들리는 부분) / \(k\) + (함께 흔들리는 부분). 함께 흔들리는 부분은 평균으로 없앨 수 없다.
이 방법을 쓸 수 있는 다른 상황은?
여러 번 재서 평균 내는 측정(큰 수의 법칙), 투자에서 서로 덜 닮은 자산에 나눠 담는 분산 투자, 여러 사람의 추측을 평균 내는 “군중의 지혜”.
활용
- 언제 더 쓸모 있나: 기본 모델들이 서로 다를 때(독립이거나 상관이 낮을 때), 그리고 기본 모델의 분산이 클 때. 분산이 큰 모델은 훈련 자료가 조금만 바뀌어도 결정 경계가 크게 달라져, 그 자체로 서로 다른 모델이 만들어진다.
- 모델을 서로 다르게 만드는 방법이 배깅과 랜덤 포레스트다. 편향까지 줄이려 차례로 실수를 고쳐 나가는 방법이 부스팅이다.
연결
자주 하는 오해
아니다. 분산은 \(\rho\sigma^2\) 아래로는 내려가지 않고, 편향과 잡음은 평균으로 전혀 줄지 않는다. 같은 자료로 같은 방법을 돌려 만든 모델들은 거의 같아(\(\rho \approx 1\)) 모아도 이득이 없다. 그럴듯해 보이는 이유는 독립일 때의 식 \(\frac{\sigma^2}{k}\)만 기억하기 때문이다. 확인: \(\sigma^2 = 4\), \(\rho = 0.25\)면 \(k = 10\)에서 1.3, \(k\)가 무한대여도 1이다.
확인 문제
C1 제곱 오차의 기댓값을 세 부분으로 나눠 쓰고, 앙상블이 주로 줄이는 부분을 말하라.
답: 편향² + 분산 + 줄일 수 없는 잡음. 평균 내는 앙상블은 분산을 줄인다.
C2 기본 모델이 모두 똑같으면(\(f_1 = \cdots = f_k\)) 평균 내도 분산이 줄지 않는 이유를 공식으로 설명하라.
답: 모두 같으면 \(\rho = 1\)이라 \(\frac{\sigma^2}{k} + \frac{k-1}{k}\sigma^2 = \sigma^2\)이다. 서로 다른 몫(\(1 - \rho\))이 없어서 상쇄될 것이 없다.
C3 분산 4, 서로 상관계수 0.25인 모델 10개를 평균 내면 분산은? 모델을 무한히 늘리면?
답: \(\frac{4}{10} + \frac{9}{10} \times 0.25 \times 4 = 0.4 + 0.9 = 1.3\). 무한히 늘리면 \(\rho\sigma^2 = 1\).
C4 증명 3단계에서 \(\operatorname{Cov}(f_i, f_j) = \rho\sigma^2\)인 이유를 대라.
답: 상관계수의 정의 \(\rho = \frac{\operatorname{Cov}(f_i, f_j)}{\sigma_i\sigma_j}\)에서 \(\sigma_i = \sigma_j = \sigma\)이므로 \(\operatorname{Cov} = \rho\sigma^2\)이다.
-
20_ensemble-learning_plot.py로 그렸고, \(k = 10\)에서 0.016(\(\rho = 0\))과 0.088(\(\rho = 0.5\))을 식과 몬테카를로 20만 회로 확인했다. ↩