둘 다 고차원 자료를 성분 몇 개로 줄인다. 가르는 질문은 “성분을 빼서 써도 되는가”다. PCA는 분산을 가장 잘 남기는 방향을 찾고 양수·음수 가중치로 속성을 섞는다. NMF는 음수 없는 부분들의 더하기로만 자료를 나타내서 성분이 군집과 바로 맞닿는다.
어느 쪽일까
C1 (a) 센서 100개의 측정값에서 잡음을 덜고 2차원 그림으로 큰 흐름을 보고 싶다. 값은 음수도 있다. (b) 문서 × 단어 횟수 표에서 “주제”를 찾아 각 문서를 주제로 묶고 싶다. 어느 쪽인가?
답: (a) PCA. 분산을 최대한 남기는 축으로 줄이는 것이 목적이고, 자료에 음수가 있어 NMF를 쓸 수 없다. 계산도 간단하다. (b) NMF. 횟수라 음수가 없고, 성분(주제)이 단어들의 더하기라 읽기 쉬우며 문서의 가장 큰 성분이 곧 군집이다.
C2 같은 문서 × 단어 표에서 PCA의 첫 성분이 스포츠 단어에 −0.4, 요리 단어에 +0.4를 주었다. NMF와 비교해 이 성분을 해석할 때 어려운 점은?
답: 한 성분이 “요리는 많고 스포츠는 적은 정도”라는 대비를 나타내서, 문서가 어느 주제에 속하는지가 양수·음수의 상쇄로 섞인다. NMF는 성분 둘이 각각 스포츠 단어, 요리 단어의 더하기라 “이 문서는 스포츠 1.2, 요리 0.05”처럼 바로 읽힌다1.
결정적 차이
두 방법을 군집화에 쓸 때를 나란히 놓으면 이렇다.
| 군집화를 위한 PCA | 군집화를 위한 NMF | |
|---|---|---|
| 핵심 생각 | 분산이 가장 큰 방향으로 투영 | 잠재 성분의 더하기로 표현 |
| 표현 | 전체적인 선형 투영(± 가중치로 속성을 섞음) | 부분 기반, 음수 없음(더하기만) |
| 군집과 맞닿음 | 군집을 보고 줄이지 않는다(분산 ≠ 군집 분리) | 자연스럽게 맞닿는다(성분 ≈ 군집) |
| 해석 | 낮다(속성 상쇄) | 높다(각 성분이 뜻 있는 부분) |
| 장점 | 간단, 효율적, 잡음 감소 | 군집 구조를 드러냄, 희소하고 읽기 쉬움 |
| 단점 | 군집 구조를 흐릴 수 있다 | 볼록하지 않아 처음 값에 민감 |
선택을 가르는 줄은 “표현”이다. 자료에 음수가 있거나 분산 보존이 목적이면 PCA, 음수 없는 횟수·강도 자료를 부분으로 나누려면 NMF다.
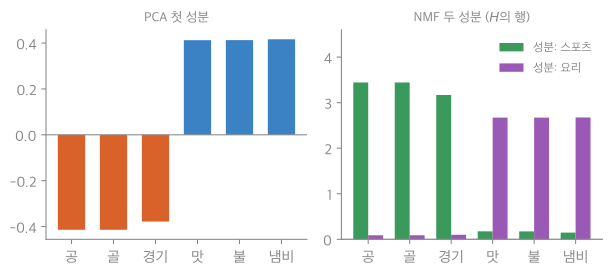
같은 문서 × 단어 표에서 뽑은 성분이다. PCA 첫 성분은 스포츠 단어에 −0.4, 요리 단어에 +0.4를 줘서, 한 성분 안에서 두 주제가 서로 빼진다. NMF는 한 성분이 스포츠 단어만, 다른 성분이 요리 단어만 크게 가진다2.
둘 다 아닐 때
C3 PCA도 NMF도 맞지 않는 상황과 선택지를 쓰라.
답: ① 군집이 고리처럼 휘어 있어 어떤 직선 투영·선형 분해로도 안 갈라질 때 → 유사도 그래프를 만들어 스펙트럼 군집화. ② 자료가 점의 속성 없이 연결 관계(그래프)로만 주어질 때 → 역시 그래프 군집화1.
-
36_contrast–pca-nmf_plot.py로 그렸고, PCA 첫 성분 −0.41, −0.41, −0.38, 0.41, 0.41, 0.42와 NMF의 \(W\), \(H\)에 음수가 없고 문서가 두 주제로 정확히 나뉘는 것을 같은 코드로 확인했다. ↩