그래프를 가장 잘 자르는 방법을 모든 경우를 따져 찾기는 불가능하다. 그래서 “각 점이 어느 쪽인가”를 +1, −1 대신 아무 실수로 풀어 주면, 문제가 행렬의 고유벡터를 구하는 쉬운 문제로 바뀐다. 그래프의 연결을 담은 행렬(라플라시안)에서 둘째로 작은 고윳값의 고유벡터를 구해 부호로 나누면 두 조각, 고유벡터 여러 개로 점을 옮긴 뒤 k-평균을 돌리면 여러 조각이 된다. 휜 모양의 군집도 잘 찾지만, 큰 그래프에서는 고유분해가 비싸고 풀어 준 답이 원래 답의 근사일 뿐이다.
예시로 보기
정규화 컷을 정확히 최소화하는 것은 NP-hard다. 그런데 이 문제를 행렬로 쓰면 길이 보인다.
꼭짓점 4개에 선 1–2, 1–3, 2–3, 2–4, 3–4가 있는 그래프를 본다. 차수 행렬 \(D\)와 인접행렬 \(A\)의 차이가 그래프 라플라시안 \(L\)이다.
\[D = \begin{pmatrix} 2&0&0&0 \\ 0&3&0&0 \\ 0&0&3&0 \\ 0&0&0&2 \end{pmatrix}, \quad A = \begin{pmatrix} 0&1&1&0 \\ 1&0&1&1 \\ 1&1&0&1 \\ 0&1&1&0 \end{pmatrix}, \quad L = D - A = \begin{pmatrix} 2&-1&-1&0 \\ -1&3&-1&-1 \\ -1&-1&3&-1 \\ 0&-1&-1&2 \end{pmatrix}\]\(L\)의 고윳값은 0, 2, 4, 4다. 가장 작은 0의 고유벡터는 모든 칸이 같다. 모두를 한쪽에 두는, 나누지 않는 답이다. 둘째로 작은 2의 고유벡터는 \((-0.71, 0, 0, 0.71)\)로, 꼭짓점 1과 4가 양 끝으로 갈리고 가운데 2, 3은 0이다1.
삼각형 두 개를 다리 하나로 이은 그래프에서는 둘째 고유벡터의 부호가 정확히 두 삼각형을 가른다. 덩어리 셋을 약하게 이은 그래프에서는 둘째·셋째 고유벡터로 점을 옮기면 같은 덩어리끼리 한 자리에 모인다1.
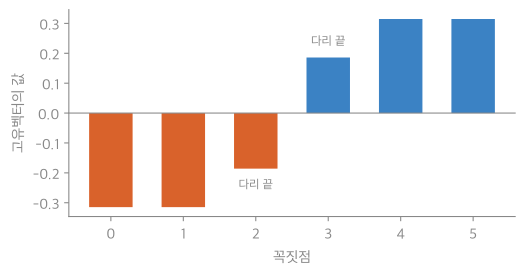
꼭짓점 0~2와 3~5가 각각 삼각형이고 2–3이 다리다. 둘째 고유벡터는 한 삼각형에 음수, 다른 삼각형에 양수를 준다. 부호만 보고 자르면 두 삼각형이 나온다. 다리 끝 2와 3은 0에 더 가깝다2.
정의
스펙트럼 완화. 소속 벡터 \(\mathbf f\)를 두고 \(f_i = +1\)(\(i \in A\)), \(f_i = -1\)(\(i \in B\))이라 하자. 두 점이 같은 쪽이면 \((f_i - f_j)^2 = 0\), 다른 쪽이면 4다. 그래서 컷은
\[\operatorname{cut}(A, B) = \frac14\sum_{i<j} w_{ij}(f_i - f_j)^2 = \frac14\mathbf f^\top L\mathbf f, \qquad L = D - W,\ D_{ii} = \sum_j w_{ij}\]\(f_i\)를 ±1 대신 아무 실수로 풀어 주는 것이 완화다. 정규화 컷은 다음 문제로 바뀌고, 그 답은 일반화 고유값 문제를 푼다.
\[\min_{A, B}\operatorname{NCut}(A, B) \ \to\ \min_{\mathbf f}\frac{\mathbf f^\top L\mathbf f}{\mathbf f^\top D\mathbf f}, \qquad L\mathbf f = \lambda D\mathbf f\]가장 작은 \(\lambda = 0\)의 해는 모든 칸이 같은 벡터(나누지 않음)다. 그래서 둘째로 작은 고윳값의 고유벡터가 답이고, 그 부호로 나눈다: \(f_i > 0\)이면 \(A\), \(f_i < 0\)이면 \(B\).
이것을 흔히 “그래프 라플라시안의 둘째로 작은 고유벡터”라 부른다. 정확히는 일반화 문제 \(L\mathbf f = \lambda D\mathbf f\)의 고유벡터이고, 정규화 라플라시안 \(D^{-1/2}LD^{-1/2}\)의 고유벡터 \(\mathbf g\)에서 \(\mathbf f = D^{-1/2}\mathbf g\)로 얻는다. 차수가 모두 같으면 \(L\)의 고유벡터와 같다1.
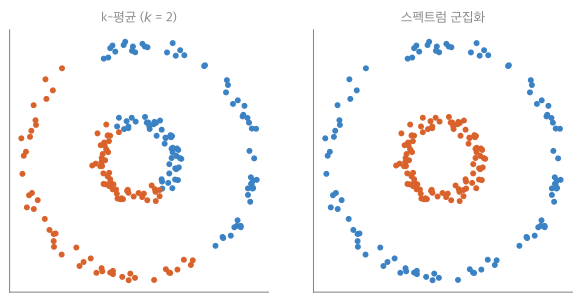
반지름 1과 3인 두 고리(점 200개)다. k-평균은 거리만 보고 둘로 잘라 두 고리를 섞는다. 스펙트럼 군집화는 가까운 점끼리 무게가 큰 그래프(가우스 커널, \(\sigma = 0.4\))를 만들고 둘째 고유벡터의 부호로 나눠, 두 고리를 정확히 가른다2.
증명: \(\mathbf f^\top L\mathbf f = \sum_{i<j} w_{ij}(f_i - f_j)^2\)
증명 펼치기
- \(\mathbf f^\top L\mathbf f = \mathbf f^\top D\mathbf f - \mathbf f^\top W\mathbf f = \sum_i d_i f_i^2 - \sum_{i,j} w_{ij}f_if_j\). — \(L = D - W\)
- \(d_i = \sum_j w_{ij}\)를 넣고 \(W\)가 대칭이므로, \(\sum_i d_if_i^2 = \frac12\sum_{i,j}w_{ij}(f_i^2 + f_j^2)\). — 대칭으로 두 번 쓰고 반으로
- 합치면 \(\frac12\sum_{i,j}w_{ij}(f_i^2 - 2f_if_j + f_j^2) = \frac12\sum_{i,j}w_{ij}(f_i - f_j)^2 = \sum_{i<j}w_{ij}(f_i - f_j)^2\). — 완전제곱, 순서쌍을 쌍으로
- \(f_i = \pm1\)이면 다른 쪽 쌍만 4가 남아 \(4\operatorname{cut}(A, B)\)다. ∎
이 식에서 \(L\)이 양의 준정부호(\(\mathbf f^\top L\mathbf f \ge 0\))이고, 모든 칸이 같은 벡터에서 0이 된다는 것도 바로 나온다1.
여러 조각으로
두 방법이 있다.
- 재귀 이분할: 두 조각으로 자르고, 한 조각을 골라 또 자르기를 \(k\)개가 될 때까지 되풀이한다. 고유분해를 여러 번 해야 해 느리고(\(O(n^3)\)씩), 앞의 잘못된 결정을 뒤에서 고칠 수 없어 불안정하다. \(k\)개로 한 번에 정규화 컷을 최소화한 것과도 다르다.
- 고유벡터 여러 개: 가장 작은 것(나누지 않는 답)을 빼고 그다음 \(k\)개의 고유벡터를 고른다. 꼭짓점 \(i\)를 그 \(k\)개 고유벡터의 \(i\)번째 값들로 이루어진 \(k\)차원 점으로 옮긴다. 새 공간에서 같은 군집은 가깝게 모이고 직선으로도 갈라지므로, k-평균 같은 아무 군집화나 돌린다.
스펙트럼 군집화(유사도 그래프 W, 군집 수 k):
    D ← 차수 대각 행렬,  L ← D − W
    Lf = λDf의 고유벡터를 고윳값이 작은 순으로 구한다
    첫째(상수 벡터)를 빼고 다음 k개를 열로 쌓아 n × k 행렬 U를 만든다
    U의 각 행(꼭짓점의 새 좌표)에 k-평균을 돌린다
flowchart LR
    X["자료 X"] --> W["유사도 그래프 W"]
    W --> L["D와 L = D − W"]
    L --> E["Lf = λDf의 고유벡터"]
    E --> U["상수 벡터를 빼고 다음 k개로 U"]
    U --> K["U의 행마다 k-평균"]
    K --> C["군집 k개"]
점의 원래 좌표는 첫 칸에서만 쓰인다. 그 뒤로는 그래프와 고유벡터가 만든 새 좌표로 군집을 나눈다.
활용
- 구현: 38_spectral-clustering_impl.py
- 사이킷런
SpectralClustering이 유사도 그래프 만들기(가우스 커널, k-NN), 고유분해, k-평균을 한 번에 한다1. - 고유분해가 \(O(n^3)\)이라 꼭짓점이 많으면 희소 행렬용 반복법(란초스 등)으로 필요한 고유벡터 몇 개만 구한다1.
연결
- 선수: 그래프 분할과 정규화 컷, 대칭행렬과 스펙트럼 정리(대칭행렬 \(L\)의 고유벡터는 직교), k-평균
- 이차형식 \(\mathbf f^\top L\mathbf f\)의 최소화: 양의 정부호 행렬과 이차형식
- 같은 “고유벡터로 새 공간을 만든다”는 생각: 주성분 분석은 공분산의 큰 고유벡터, 스펙트럼 군집화는 라플라시안의 작은 고유벡터를 쓴다.
확인 문제
C1 그래프 라플라시안 \(L\)을 정의하고, 2-분할에 쓰는 고유벡터가 첫째가 아니라 둘째로 작은 고윳값의 것인 이유를 쓰라.
답: \(L = D - W\), \(D\)는 차수 대각 행렬. 가장 작은 고윳값 0의 고유벡터는 모든 칸이 같은 벡터라, 부호로 나누면 모두 한쪽에 들어가 나누지 않는 답이 된다. 그래서 그다음인 둘째 고유벡터를 쓴다.
C2 경로 그래프 1 – 2 – 3(선 무게 1)의 \(D\), \(L\)을 쓰고, \(\mathbf f = (1, 1, -1)\)에서 \(\mathbf f^\top L\mathbf f\)와 컷을 구하라.
답: \(D = \operatorname{diag}(1, 2, 1)\), \(L = \begin{pmatrix} 1&-1&0 \\ -1&2&-1 \\ 0&-1&1 \end{pmatrix}\). \(\mathbf f^\top L\mathbf f = (1-1)^2 + (1-(-1))^2 = 4\), 컷 \(= 1\)(선 2–3), \(4 \times 1 = 4\)로 맞는다.
C3 의사코드의 “U의 각 행에 k-평균을 돌린다” 줄이 하는 일을 한 문장으로 쓰라.
답: 고유벡터들로 만든 새 좌표에서는 같은 군집의 꼭짓점들이 가깝게 모여 있으므로, 그 좌표를 k-평균에 넣어 꼭짓점을 \(k\)개 군집으로 나눈다.
C4 증명 2단계 \(\sum_i d_if_i^2 = \frac12\sum_{i,j}w_{ij}(f_i^2 + f_j^2)\)의 근거를 대라.
답: \(\sum_i d_if_i^2 = \sum_{i,j}w_{ij}f_i^2\)이고, \(W\)가 대칭이라 \(i\)와 \(j\)를 바꾼 \(\sum_{i,j}w_{ij}f_j^2\)와 같다. 두 식의 평균을 쓰면 오른쪽이 된다.