자료가 종 모양 분포 여러 개를 섞어서 생겼다고 보는 군집화다. 점 하나를 만들 때 먼저 어느 종을 쓸지 주사위로 고르고, 그 종에서 점을 뽑는다고 생각한다. 그러면 점마다 “무리 1에서 왔을 확률 0.7, 무리 2에서 0.3”처럼 부드럽게 나눌 수 있고, 종마다 퍼짐과 기울기가 달라 길쭉한 타원 무리도 표현한다. 다만 여전히 무리 수를 정해야 하고, 자료가 정말 종 모양에서 왔다고 가정하며, 처음 값에 따라 다른 답에 멈출 수 있다.
예시로 보기
k-평균은 무리를 둥글고 크기가 비슷하다고 보고, 경계의 점도 한 무리에 딱 잘라 넣는다. 그런데 두 무리 가운데에 있는 점은 “반쯤 이쪽”이라고 말하는 편이 정직하다.
1차원에서 무리 1은 평균 0, 무리 2는 평균 5이고 둘 다 표준편차 1, 비율 반반이라 하자. 가운데 2.5에 있는 점은 두 무리에서 나왔을 가능성이 같아 각각 0.5다. 0.5에 있는 점은 거의 무리 1이다1. 이렇게 점마다 무리별 확률을 주는 것을 부드러운 배정이라 부른다.
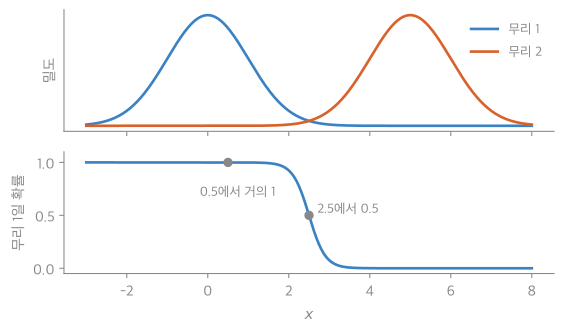
위는 두 무리가 만드는 밀도, 아래는 점이 무리 1에서 왔을 확률(책임도)이다. 두 종의 가운데 2.5에서 0.5이고, 그 양옆 폭 2쯤에서만 0과 1 사이 값을 가진다. 그 밖에서는 거의 0 또는 1이라 k-평균의 딱 잘라 넣기와 비슷해진다2.
두 차원이 서로 강하게 함께 움직이면(상관이 크면) 무리는 기울어진 타원이 된다. 종 모양 분포의 공분산 행렬이 그 모양을 담는다.
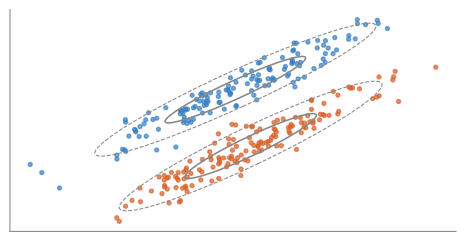
k-평균이 반으로 잘랐던 길쭉한 두 무리에 성분 2개짜리 GMM을 맞췄다. 실선은 평균에서 표준편차 1개, 점선은 2개만큼 떨어진 타원이다. 무리마다 기울어진 타원을 따로 가져서, 점 300개 중 299개를 실제 무리대로 나눈다2.
정의
GMM은 확률적이고 생성적인 군집화 모델이다. 자료점이 가우스 분포 여러 개의 혼합에서 나왔다고 보고, 각 점이 여러 군집에 서로 다른 확률로 속한다.
군집 \(\alpha\)는 평균 \(\boldsymbol\mu_\alpha\)(중심)와 공분산 \(\Sigma_\alpha\)(모양과 퍼짐)를 가진 가우스 분포다. 공분산이 작으면 촘촘한 군집, 크면 퍼진 군집, 차원끼리 상관이 있으면 기울어진 타원이다.
자료 전체의 확률밀도는 \(k\)개 성분의 가중합이다.
\[p(\mathbf x) = \sum_{\alpha=1}^{k}\pi_\alpha\,\mathcal N(\mathbf x \mid \boldsymbol\mu_\alpha, \Sigma_\alpha), \qquad \sum_{\alpha=1}^{k}\pi_\alpha = 1,\ \pi_\alpha \ge 0\]\(\pi_\alpha\)(혼합 계수)는 군집 \(\alpha\)의 비중이다. 이 식은 점 하나를 만드는 과정으로 읽는다. ① 확률 \(\pi_\alpha\)로 군집 \(\alpha\)를 고르고 ② 가우스 분포 \(\alpha\)에서 점을 뽑는다.
군집 배정. 점 \(\mathbf x_i\)가 군집 \(\alpha\)에서 나왔을 확률(그 군집이 그 점을 만든 책임의 크기, 책임도)은 베이즈 정리로 구한다.
\[[\mathbf z_i]_\alpha = \frac{\pi_\alpha\,\mathcal N(\mathbf x_i \mid \boldsymbol\mu_\alpha, \Sigma_\alpha)}{\sum_{l=1}^{k}\pi_l\,\mathcal N(\mathbf x_i \mid \boldsymbol\mu_l, \Sigma_l)}\]분자는 “군집 \(\alpha\)를 고르고 그 군집에서 \(\mathbf x_i\)가 나올 가능성”, 분모는 모든 군집에 대한 합이다. 이것을 계산하려면 모든 군집의 \((\boldsymbol\mu_\alpha, \Sigma_\alpha, \pi_\alpha)\)가 필요하다. 그것을 추정하는 방법이 EM 알고리즘이다.
활용
- k-평균보다 나은 점: 부드러운 배정(확률적 해석, 겹치는 군집), 군집마다 다른 퍼짐과 타원 모양.
- 한계: 군집 수 \(k\)를 정해야 한다. 자료가 가우스 분포에서 왔다고 가정한다. 처음 값에 민감하고 국소 최적에 멈출 수 있다. 고차원에서는 공분산 추정이 불안정하다(차원의 저주).
- 사이킷런
GaussianMixture가 이것이다.predict_proba가 책임도다1.
연결
- 선수: k-평균, 다변량 정규분포, 베이즈 정리
- 매개변수 추정: EM 알고리즘
- 분산을 모두 같게 하고 0으로 보내면 책임도가 0/1이 되어 k-평균의 배정과 같아진다. GMM은 k-평균의 확률적 확장이다1.
확인 문제
C1 GMM의 확률밀도 식을 쓰고, 이 식이 말하는 점 생성 과정 두 단계를 쓰라.
답: \(p(\mathbf x) = \sum_\alpha \pi_\alpha\mathcal N(\mathbf x \mid \boldsymbol\mu_\alpha, \Sigma_\alpha)\), \(\sum\pi_\alpha = 1\). ① 확률 \(\pi_\alpha\)로 군집을 고른다 ② 그 군집의 가우스 분포에서 점을 뽑는다.
C2 k-평균은 표현하지 못하고 GMM은 표현하는 것 두 가지를 쓰고, 각각 GMM의 무엇이 그것을 가능하게 하는지 말하라.
답: ① 경계의 점이 여러 군집에 걸친 정도: 책임도(부드러운 배정)가 확률로 준다. ② 길쭉하거나 기울어진, 크기가 다른 군집: 군집마다 다른 공분산 \(\Sigma_\alpha\)가 모양과 퍼짐을 담는다.
C3 1차원 두 성분이 평균 1과 2, 분산 1, 비율 반반이다. 점 0의 성분 1 책임도를 구하라.
답: \(\frac{e^{-1/2}}{e^{-1/2} + e^{-2}} = \frac{1}{1 + e^{-3/2}} \approx 0.818\). (정규분포의 앞 상수는 같아 약분된다.)1