수천 개의 측정값을 몇 개의 수와 그림으로 요약하는 방법이다. 가운데(평균, 중앙값), 흩어진 정도(표준편차, 사분위 범위), 모양(히스토그램, 분위수)을 본다. 평균은 극단값 하나에 크게 끌려가지만 중앙값과 분위수는 버틴다. 응답 시간처럼 가끔 아주 큰 값이 나오는 자료는 평균보다 “상위 1%가 얼마나 느린가”가 사용자 경험을 더 잘 말해 준다.
예시로 보기
API 응답 시간 10개(ms)가 \(12, 13, 13, 14, 15, 15, 16, 18, 20, 250\)이다.
| 요약 | 값 | 250을 25로 바꾸면 |
|---|---|---|
| 평균 | 38.6 | 16.1 |
| 중앙값 | 15 | 15 |
| 표준편차(\(n - 1\)) | 약 74.3 | 약 4.0 |
요청 하나가 느렸을 뿐인데 평균은 대부분의 요청보다 두 배 넘게 크게 나온다. 중앙값은 “보통 요청”을 그대로 보여 준다. 10개의 값이 아래 정의의 \(x_1, \dots, x_n\)이다.
정의
자료 \(x_1, \dots, x_n\)을 크기 순으로 늘어놓은 것을 \(x_{(1)} \le \cdots \le x_{(n)}\)이라 하자.
| 요약 | 정의 | 무엇을 말하나 |
|---|---|---|
| 표본평균 | \(\bar x = \frac1n\sum x_i\) | 무게중심 |
| 중앙값 | 가운데 값(\(n\)이 짝수면 가운데 두 값의 평균) | 절반이 이보다 작다 |
| \(q\) 분위수 | 자료의 비율 \(q\)가 이보다 작거나 같은 값 | p50 = 중앙값, p99 = 상위 1% 경계 |
| 표본분산 | \(s^2 = \frac{1}{n - 1}\sum(x_i - \bar x)^2\) | 흩어짐(제곱 단위) |
| 사분위 범위(IQR) | 75% 분위수 − 25% 분위수 | 가운데 절반의 폭 |
| 경험적 분포함수 | \(\hat F(x) = \frac{\#\{i : x_i \le x\}}{n}\) | 값마다 \(\frac1n\)씩 오르는 계단 |
표본분산을 \(n\)이 아니라 \(n - 1\)로 나누는 이유는 표본분포와 추정량에서 다룬다. 경험적 분포함수는 표본이 늘수록 참 CDF에 가까워진다1.
분위수 계산 규약. 자료 사이의 값을 어떻게 메우느냐에 따라 분위수 계산법이 여럿이다. 예시 자료의 90% 분위수는 최근접 순위 방식이면 20, 선형 보간 방식(파이썬 statistics.quantiles의 method='inclusive')이면 43, 기본값 'exclusive'면 227이다. 표본이 작고 꼬리가 길수록 차이가 커서, 분위수를 보고할 때는 계산 방법을 함께 적는다.
견고성. 값 하나를 무한히 키우면 평균과 표준편차는 무한히 커지지만, 중앙값과 IQR은 거의 그대로다. 자료의 절반 가까이가 망가져야 중앙값이 망가진다.
예제
어떤 요약을 보고할까. 서비스 지연 시간 로그 100만 건을 요약한다.
- 모양 먼저: 히스토그램을 그리면 대부분 10~30 ms에 몰리고 오른쪽으로 긴 꼬리가 있다.
- 가운데: 꼬리 때문에 평균이 중앙값보다 크다. “보통 요청”은 중앙값(p50)으로 말한다.
- 꼬리: 사용자가 느끼는 최악은 p99, p99.9로 말한다. 요청 100개를 여는 페이지라면 그중 하나쯤은 p99보다 느리다.
- 흩어짐: 표준편차는 꼬리에 크게 흔들리므로 IQR을 함께 본다.
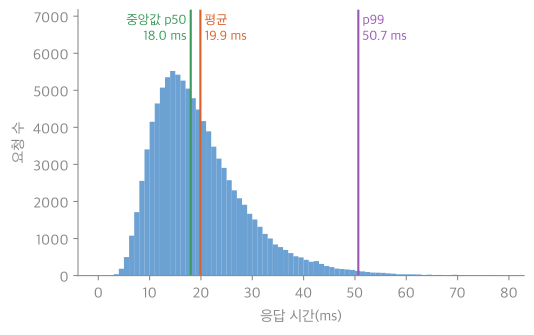
오른쪽 꼬리가 긴 지연 시간 자료 10만 건의 히스토그램이다. 꼬리가 평균을 중앙값보다 오른쪽으로 끌고, p99는 중앙값의 세 배 가까이 떨어져 있다2.
활용
- 서비스 수준 목표(SLO). “요청의 99%가 200 ms 안”처럼 분위수로 목표를 잡는다.
- 로그와 모니터링. 대시보드는 평균 하나보다 p50·p95·p99를 함께 그린다. 분위수를 스트림으로 어림하는 자료구조(t-digest 등)도 이것 때문에 있다.
- 흔한 실수. 서버마다 구한 p99를 평균 내면 전체의 p99가 아니다. 분위수는 평균처럼 합칠 수 없다.
- 알고리즘에서: 값을 1 올리는 비용이 P, 1 내리는 비용이 Q일 때 모든 값을 한 값으로 맞추는 가장 싼 목표는 Q/(P + Q) 분위수(최근접 순위 방식)이고, P = Q면 중앙값이다(지형 편집). 정렬해 둔 자료에서 경험적 분포함수 \(\hat F(x)\)는 \(x\) 이하인 값의 수를 이분 탐색으로 세어 질문마다 \(O(\log n)\)에 구한다. 값을 모두 저장해도 되면 계속 들어오는 값의 중앙값은 힙 두 개로 정확히 따라간다. 그 밖에 K번째수에서도 쓴다.
연결
과목별 관점
데이터 과학 (3-2학기). 기술통계를 “전처리 전에 자료 전체를 한눈에 보는 도구”로 쓴다. 어느 값을 잡음이나 이상치로 다룰지, 빈 값을 무엇으로 채울지 정하기 전에 중심과 흩어짐부터 본다.
- 가중 평균. 값마다 중요도 \(w_i\)가 다르면 \(\bar x = \frac{\sum w_i x_i}{\sum w_i}\)로 평균을 낸다. 예: 80점에 가중치 3, 90점에 1이면 \(\frac{240 + 90}{4} = 82.5\)다.
- 최빈값. 가장 자주 나오는 값이다. 가장 많이 나오는 값이 여럿이면 다봉(multimodal)이라 부른다. 좌우가 대칭이면 최빈값 = 중앙값 = 평균이다. 오른쪽으로 꼬리가 길면 큰 값들이 평균만 끌어올려 최빈값 < 중앙값 < 평균이 되고, 왼쪽으로 길면 순서가 반대다.
- 다섯 수 요약과 상자 그림. 최솟값, \(Q_1\), 중앙값, \(Q_3\), 최댓값 다섯 개로 분포를 요약한다. 상자 그림은 상자의 양 끝을 \(Q_1\)과 \(Q_3\), 상자 안의 선을 중앙값, 상자 밖 두 선을 최솟값과 최댓값으로 그린다.
- 분산의 분모. 자료 \(N\)개의 분산을 \(\sigma^2 = \frac1N\sum(x_i - \bar x)^2\)처럼 \(N\)으로 나누기도 한다. 위 표의 표본분산 \(s^2\)는 \(n - 1\)로 나눈다. 자료 전체를 모집단으로 보면 \(N\), 더 큰 모집단에서 뽑은 표본으로 보고 모집단 분산을 추정하면 \(n - 1\)이다.
확인 문제
C1 응답 시간 \(12, 13, 13, 14, 15, 15, 16, 18, 20, 250\) ms의 평균과 중앙값을 구하라.
답: 평균 \(\frac{386}{10} = 38.6\), 중앙값은 5번째와 6번째 값의 평균 \(\frac{15 + 15}{2} = 15\).
C2 지연 시간 목표를 평균 대신 p99로 잡는 이유는?
답: 지연 시간은 오른쪽 꼬리가 길어 평균이 소수의 아주 느린 요청과 다수의 빠른 요청을 뭉개 버린다. 사용자가 불만을 느끼는 것은 느린 요청이고, 한 페이지가 여러 요청을 기다리면 꼬리가 사용자 경험을 좌우한다. p99는 그 꼬리를 직접 잰다.
C3 가구 소득 자료의 “대표값”으로 평균과 중앙값 중 무엇이 알맞은가? 이유는?
답: 중앙값. 소득은 소수의 고소득이 오른쪽 꼬리를 만들어 평균을 끌어올린다. 중앙값은 “절반이 이보다 적게 번다”는 뜻이라 보통 가구를 나타낸다. 총액이 중요할 때(세수 추정 등)는 평균이 맞다.
C4 과목 점수 80점(학점 3)과 90점(학점 1)의 학점 가중 평균은? 단순 평균과 왜 다른가?
답: \(\frac{3 \times 80 + 1 \times 90}{4} = 82.5\). 단순 평균 85와 다른 이유는 학점이 큰 80점이 평균을 더 세게 끌어당기기 때문이다.
C5 자료 \(1, 2, 2, 2, 3, 3, 4, 5, 9, 20\)에서 최빈값, 중앙값, 평균의 크기 순서를 예측하고, 그 순서가 나오는 이유를 대라.
답: 최빈값 2 < 중앙값 3 < 평균 5.1. 오른쪽 꼬리의 9와 20이 합에는 크게 더해져 평균만 끌어올린다. 중앙값은 가운데 순위만 보고, 최빈값은 가장 많은 값만 본다.
-
Wasserman, All of Statistics, “Estimating the CDF and Statistical Functionals” 장(경험적 분포함수, 통계적 범함수로서의 평균·분위수). ↩
-
28_descriptive-statistics_plot.py로 그렸고, 그림에 쓴 값(예시 표의 38.6·15·74.3, 중앙값 < 평균 < p99. 그림의 자료는 로그정규분포로 만든 모의 자료다)을 같은 코드로 확인했다. ↩