나이 23, 37, 61 같은 숫자를 “20대”, “30대” 또는 “청년”, “장년” 같은 구간 이름으로 바꾸는 일이다. 값의 가짓수가 줄어 패턴을 찾기 쉽고 결과를 사람이 읽기 쉬워진다. 구간끼리는 다시 묶어 “싸다/보통/비싸다” 같은 더 큰 구간으로 올라갈 수 있다. 대신 같은 구간 안의 차이는 모두 지워져, 19세와 20세는 다른 칸이고 20세와 29세는 같은 칸이 된다.
예시로 보기
데이터 정제의 가격 \(4, 8, 15, 21, 21, 24, 25, 28, 34\)를 이번에는 폭이 같은 세 칸으로 나눈다. 범위가 \(4 \sim 34\), 폭이 30이니 칸 하나의 폭은 10이다1.
| 칸 | \([4, 14)\) | \([14, 24)\) | \([24, 34]\) |
|---|---|---|---|
| 든 값 | 4, 8 | 15, 21, 21 | 24, 25, 28, 34 |
| 이름 | 싸다 | 보통 | 비싸다 |
| 칸 평균 | 6 | 19 | 27.75 |
데이터 정제에서는 칸마다 개수를 3개로 같게 맞췄다(같은 개수 칸 나누기). 여기서는 칸의 폭을 같게 맞춰서 칸마다 개수가 2, 3, 4로 다르다. 칸 안의 값을 칸 평균이나 중앙값으로 바꿀 수도 있고, 칸 이름으로 바꿀 수도 있다.
정의
이산화는 수치 속성의 원래 값을 구간 이름으로 바꾼다. 예: 나이 → (0~10, 11~20, 21~30, …) 또는 (청소년, 성인, 노인, …).
구간 이름은 다시 더 큰 개념으로 묶을 수 있다. 이렇게 쌓은 층을 그 속성의 개념 계층이라 부른다. 예: 가격 → (아주 쌈, …, 보통, …, 아주 비쌈).
칸 나누기로 이산화. 같은 폭의 칸으로 나누고(같은 폭 칸 나누기), 칸 안의 값을 칸 평균이나 중앙값으로 바꾼다. 두 칸 나누기를 비교하면 다음과 같다1.
| 같은 폭 | 같은 개수 | |
|---|---|---|
| 칸을 정하는 법 | 범위를 \(k\)등분 | 정렬해 \(\frac{n}{k}\)개씩 |
| 장점 | 간단하고 칸의 뜻이 분명 | 칸마다 자료가 고르게 든다 |
| 약점 | 치우친 자료면 거의 빈 칸과 꽉 찬 칸이 생긴다 | 같은 값이 다른 칸으로 갈라질 수 있다 |
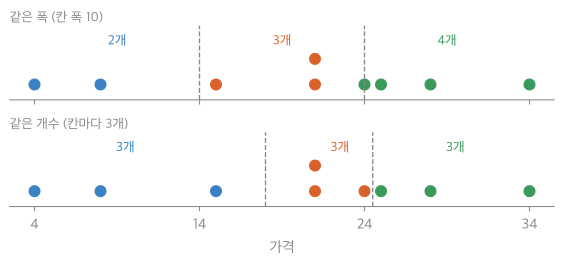
같은 가격 9개를 두 방법으로 나눴다. 같은 폭은 경계가 14, 24로 고정이라 칸마다 2, 3, 4개가 든다. 같은 개수는 경계가 자료를 따라 움직여 칸마다 3개씩 든다2.
연결
확인 문제
C1 수치 속성을 구간 이름으로 바꾸면 얻는 것과 잃는 것을 하나씩 쓰라. 바꾼 뒤 속성의 종류는 무엇인가?
답: 얻는 것: 값의 가짓수가 줄어 패턴을 찾기 쉽고 결과를 읽기 쉽다. 잃는 것: 같은 칸 안의 차이(20세와 29세)가 지워지고, 경계 양쪽의 가까운 값(19세와 20세)이 다른 칸으로 갈린다. 바꾼 뒤에는 순서 속성이다.
C2 나이 13, 15, 16, 19, 20, 21, 22, 25, 30, 33, 35, 36, 40, 45, 46, 52, 70을 13에서 시작해 폭 20인 세 칸 \([13, 33)\), \([33, 53)\), \([53, 73]\)으로 나누면 칸마다 몇 명인가? 이 결과가 보여 주는 같은 폭 칸 나누기의 약점은?
답: 9명, 7명, 1명. 70세 한 명 때문에 범위가 넓어져 마지막 칸이 거의 비었다. 치우친 자료에서 같은 폭으로 나누면 칸마다 개수가 크게 달라진다1.
-
08_discretization_plot.py로 그렸고, 같은 폭 칸의 경계 4, 14, 24, 34와 개수 2, 3, 4, 칸 평균 6, 19, 27.75를 같은 코드로 확인했다. ↩