차원이 많은 자료에서는 점끼리 거리가 다 비슷해지고, 쓸모없는 차원이 무리를 가린다. CLIQUE는 각 축을 같은 폭의 칸으로 잘라 바둑판을 만들고, 점이 많이 든 칸(밀집 칸)을 찾아 이웃한 밀집 칸끼리 묶는다. 이때 모든 차원을 한꺼번에 보지 않고, 무리가 보이는 일부 차원(부분공간)을 찾는다. 점이 아니라 칸을 세서 빠르고 쓸모 있는 차원을 스스로 고르지만, 칸 크기와 밀도 기준에 결과가 크게 달라지고 축에 비스듬한 무리는 잘 못 잡는다.
예시로 보기
차원이 많아지면 가까운 점과 먼 점의 거리 차이가 줄어 거리가 쓸모를 잃는다. 모든 차원이 군집에 중요한 것도 아니고, 쓸모없는 차원이 의미 있는 군집을 가린다. 또 점마다 이웃을 세는 DBSCAN은 \(O(n^2 d)\)라 비싸다.
점 300개를 세 축 \(x_1, x_2, x_3\)(각각 0~10)에 흩었다. 120개는 \(x_1 \in [2, 4)\), \(x_2 \in [6, 8)\)에 모여 있지만 \(x_3\)은 고르게 퍼져 있고, 나머지 180개는 잡음이다. 각 축을 폭 2인 5칸으로 자르고, 전체의 15% 이상이 든 칸을 밀집 칸으로 본다1.
| 단계 | 밀집 칸 |
|---|---|
| 1차원 | \(x_1\)의 [2, 4)(149개), \(x_1\)의 [6, 8)(49개), \(x_2\)의 [6, 8)(161개), \(x_3\)의 다섯 칸 모두(52~70개) |
| 2차원 후보 | 밀집 1차원 칸끼리만 잇는다 |
| 2차원 | (\(x_1\) [2, 4), \(x_2\) [6, 8)) 129개 하나뿐 |
| 3차원 | 없음 |
\(x_3\)은 1차원으로는 모든 칸이 밀집이다. 점이 고르게 퍼져서 칸마다 20%쯤 들기 때문이다. 하지만 다른 축과 짝지으면 어디에도 모이지 않는다. 무리는 \((x_1, x_2)\) 부분공간에서만 보이고, 세 축 전체로 보면 사라진다.
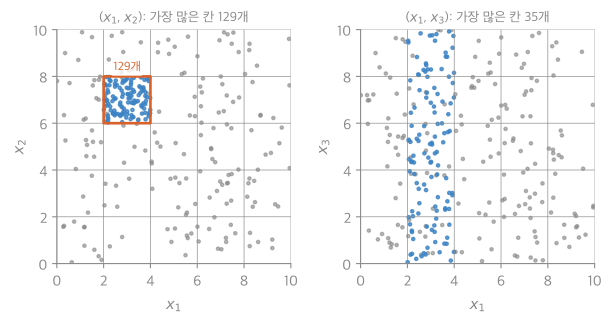
같은 점 300개를 두 평면에 비췄다. 파란 점이 모인 120개, 회색 점이 잡음이다. 밀집 기준 15%는 45개다. \((x_1, x_2)\)에서는 한 칸에 129개가 모여 밀집 칸이 된다. \((x_1, x_3)\)에서는 모인 점이 세로 띠로 퍼져서, 가장 많은 칸도 35개라 밀집 칸이 없다2.
정의
CLIQUE(CLustering In QUEst)는 격자 기반 부분공간 군집화 알고리즘이다. 격자로 큰 자료를 다루고(확장성), 부분공간으로 고차원 자료를 다룬다. 핵심 관찰은 “군집이 특정 부분공간에만 있을 수 있다”이다. 예를 들어 \((x_1, x_2)\)에서는 보이는 군집이 전체 공간 \((x_1, \dots, x_d)\)에서는 보이지 않을 수 있다.
순서는 다음과 같다.
- 각 차원을 같은 폭의 구간으로 나눈다(같은 폭 칸 나누기).
- 여러 차원의 구간을 곱해 단위를 만든다(데카르트 곱).
- 밀집 단위를 찾는다. 단위에 든 점의 비율이 기준 \(\tau\) 이상이면 밀집이다.
- 이웃한 밀집 단위를 이어 군집을 만든다.
밀집 부분공간을 효율적으로 찾기. 아프리오리 성질을 쓴다. \(k\)차원 단위가 밀집이려면 그 모든 투영(부분공간의 단위)이 밀집이어야 한다. 예: \((x_1, x_2, x_3)\)의 단위가 밀집이면 \((x_1, x_2)\), \((x_2, x_3)\), \((x_1, x_3)\)의 투영 단위도 밀집이다. 단위 안의 점은 투영 단위에도 반드시 들어가서, 투영의 점 수가 원래 단위의 점 수 이상이기 때문이다1.
그래서 ① 차원마다 따로 밀집 1차원 단위를 찾고 ② 밀집 \((k-1)\)차원 단위끼리만 이어 \(k\)차원 후보를 만든다. 밀집이 아닌 \((k-1)\)차원 단위는 볼 필요가 없다. 빈발 항목 집합을 찾는 Apriori와 같은 구조다.
활용
- 구현: 32_clique_impl.py
- 장점. 점이 아니라 격자를 다뤄 확장성이 좋다. 서로 다른 부분공간의 군집을 찾는다(군집 A는 \((x_1, x_2)\), 군집 B는 \((x_3, x_4, x_5)\)). 군집마다 관련 차원을 스스로 찾는다. 모양이 제멋대로인 군집도 찾는다.
- 한계. 격자 크기와 밀도 기준에 민감하다. 축에 나란한 군집을 선호한다. 차원이 많으면 후보 부분공간이 너무 많다. 칸으로 나눠서 경계의 점이 어긋난다.
연결
- 선수: DBSCAN(밀도 기반), Apriori 알고리즘(같은 가지치기), 이산화(같은 폭 칸)
- 비교: 군집화 알고리즘 비교
확인 문제
C1 CLIQUE의 네 단계를 쓰고, 밀집 단위의 조건을 식으로 쓰라.
답: ① 차원마다 같은 폭 구간으로 나눈다 ② 구간들의 곱으로 단위를 만든다 ③ 밀집 단위를 찾는다 ④ 이웃한 밀집 단위를 이어 군집을 만든다. 밀집 조건은 \(\frac{\#\text{(단위 안의 점)}}{n} \ge \tau\).
C2 \(k\)차원 밀집 단위의 모든 \((k-1)\)차원 투영이 밀집인 이유를 대고, 이 성질이 후보 생성에서 어떻게 쓰이는지 말하라.
답: 단위 안의 점은 그 단위를 어느 부분공간으로 비추어도 비춘 단위 안에 있으므로, 투영의 점 수가 원래 이상이다. 그래서 밀집이 아닌 \((k-1)\)차원 단위를 포함하는 \(k\)차원 후보는 만들 필요가 없고, 밀집 \((k-1)\)차원 단위끼리만 잇는다(Apriori의 가지치기와 같다).
C3 1차원으로 보면 모든 칸이 밀집인 축(예시의 \(x_3\))은 군집에 쓸모 있는 축인가? 어떻게 알 수 있는가?
답: 아니다. 점이 고르게 퍼져 칸마다 비슷한 수가 든 것이라 구조가 없다. 다른 축과 짝지은 2차원 단위에서 밀집이 나오지 않는 것으로 알 수 있다. 예시에서 \(x_3\)이 든 2차원 밀집 단위는 하나도 없었다.
-
32_clique_plot.py로 그렸다. 32_clique_impl.py와 같은 난수 흐름으로 같은 점 300개를 만들었고, 1차원 칸의 149·49·161개, \((x_1, x_2)\)의 129개, \((x_1, x_3)\)과 \((x_2, x_3)\)에 밀집 칸이 없음을 같은 코드로 확인했다. ↩