어떤 행렬이든(정사각이 아니어도, 대칭이 아니어도) “돌리기 → 축마다 늘이기 → 돌리기” 세 단계로 쪼갤 수 있다. 늘이는 배율이 특잇값이고, 큰 것부터 줄 세우면 행렬의 “중요한 방향”이 순서대로 드러난다. 큰 특잇값 몇 개만 남기면 그 크기에서 가장 정확한 근사가 되어, 이미지 압축, 추천 시스템, 데이터 차원 축소(PCA)가 모두 이 원리를 쓴다. 다만 특잇값은 고윳값과 다른 수이고, 큰 행렬에서는 계산 비용이 크다.
예시로 보기
\(A = \begin{pmatrix}3 & 0\\ 4 & 5\end{pmatrix}\)는 단위원을 타원으로 보낸다. 가장 많이 늘어나는 입력 방향은 \(\mathbf{v}_1 = \frac{1}{\sqrt2}(1, 1)\)이고, 이것이 \(A\mathbf{v}_1 = \frac{1}{\sqrt2}(3, 9)\), 곧 길이 \(3\sqrt5 \approx 6.71\)인 \(\mathbf{u}_1 = \frac{1}{\sqrt{10}}(1, 3)\) 방향으로 간다. 그와 수직인 \(\mathbf{v}_2 = \frac{1}{\sqrt2}(-1, 1)\)은 길이 \(\sqrt5 \approx 2.24\)인 \(\mathbf{u}_2 = \frac{1}{\sqrt{10}}(-3, 1)\) 방향으로 간다. \(\mathbf{u}_1\)과 \(\mathbf{u}_2\)도 서로 수직이다.
타원의 긴 반지름이 \(\sigma_1 = 3\sqrt5\), 짧은 반지름이 \(\sigma_2 = \sqrt5\)다. 수직인 입력 축 \(\mathbf{v}_i\)가 수직인 출력 축 \(\mathbf{u}_i\)로 \(\sigma_i\)배 늘어 가는 것이 아래 정리의 \(A\mathbf{v}_i = \sigma_i\mathbf{u}_i\)다.
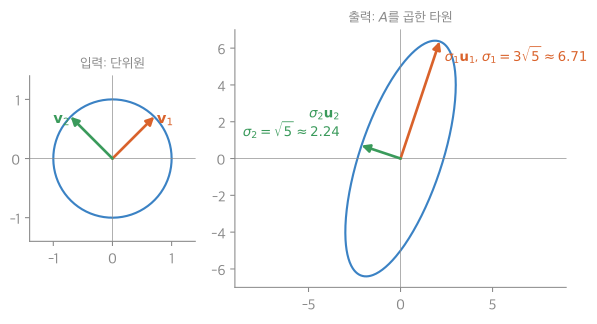
왼쪽 단위원의 수직인 두 반지름 \(\mathbf{v}_1\), \(\mathbf{v}_2\)가 오른쪽 타원의 긴 반지름과 짧은 반지름이 된다. 출력 쪽 두 축도 여전히 수직이다1.
정의
랭크가 \(r\)인 모든 \(m \times n\) 실수 행렬 \(A\)는
\[A = U\Sigma V^\top = \sigma_1\mathbf{u}_1\mathbf{v}_1^\top + \cdots + \sigma_r\mathbf{u}_r\mathbf{v}_r^\top\]로 쓸 수 있다. \(U\)(\(m \times m\))와 \(V\)(\(n \times n\))는 직교 행렬, \(\Sigma\)는 대각에 \(\sigma_1 \ge \cdots \ge \sigma_r > 0\)(나머지 0)을 둔 \(m \times n\) 행렬이다. \(\sigma_i^2\)은 \(A^\top A\)(그리고 \(AA^\top\))의 0이 아닌 고윳값이고, \(\mathbf{v}_i\)는 \(A^\top A\)의 고유벡터, \(\mathbf{u}_i = A\mathbf{v}_i/\sigma_i\)다2.
flowchart LR
    X["입력 x"] -->|"Vᵀ"| CV["입력 축 v₁ … vₙ로 잰 좌표"]
    CV -->|"Σ"| S["i번째 좌표는 σᵢ배, r번째 뒤는 0"]
    S -->|"U"| Y["출력 축 u₁ … uₘ으로 다시 조립한 Ax"]
Ax = UΣVᵀx를 오른쪽부터 읽으면 세 단계다. 수직인 입력 축으로 재고, 축마다 따로 늘이고, 수직인 출력 축으로 다시 조립한다3.
\(A_k = \sigma_1\mathbf{u}_1\mathbf{v}_1^\top + \cdots + \sigma_k\mathbf{u}_k\mathbf{v}_k^\top\)는 랭크가 \(k\) 이하인 모든 행렬 \(B\) 중 \(A\)에 가장 가깝다. 오차의 크기는 \(\Vert A - A_k\Vert _2 = \sigma_{k+1}\)(가장 많이 늘이는 배율로 잰 크기), \(\Vert A - A_k\Vert _F = \sqrt{\sigma_{k+1}^2 + \cdots + \sigma_r^2}\)(성분 제곱합의 제곱근)이다4.
가정. 없다. 모든 실수 행렬에 맞는다. 이 점이 고윳값 분해(정사각이고, 대각화 가능해야 함)와 다르다.
고윳값 분해와의 관계. 대칭이고 양의 준정부호인 행렬에서는 \(U = V = Q\)라 SVD가 스펙트럼 분해와 같다. 일반 행렬에서는 다르다. 특잇값은 모두 0 이상이고, 입력 축과 출력 축이 다를 수 있다.
증명
\(A^\top A\)에 스펙트럼 정리를 쓰고, 출력 축을 \(\mathbf{u}_i = A\mathbf{v}_i/\sigma_i\)로 만든다.
증명 펼치기
- 입력 축: \(A^\top A\)는 대칭이고 양의 준정부호라 정규직교 고유벡터 \(\mathbf{v}_1, \dots, \mathbf{v}_n\)과 고윳값 \(\lambda_i \ge 0\)을 가진다(양의 정부호 행렬과 이차형식). 큰 순서로 놓고, 양수인 것 \(r\)개에 대해 \(\sigma_i = \sqrt{\lambda_i}\)로 둔다.
- 출력 축: \(\mathbf{u}_i = \frac{A\mathbf{v}_i}{\sigma_i}\)(\(i \le r\))로 두면
그래서 \(\mathbf{u}_1, \dots, \mathbf{u}_r\)은 정규직교다. 그람–슈미트로 \(m\)개까지 늘려 \(U\)를 만든다.
- 조립: \(i \le r\)이면 \(A\mathbf{v}_i = \sigma_i\mathbf{u}_i\). \(i > r\)이면 \(\Vert A\mathbf{v}_i\Vert ^2 = \lambda_i = 0\)이라 \(A\mathbf{v}_i = \mathbf{0}\). 열별로 모으면 \(AV = U\Sigma\)이고, \(V\)가 직교라 \(A = U\Sigma V^\top\). ∎
에카르트–영 정리의 증명은 [증명 생략: Eckart·Young(1936)]4.
스스로 설명해 보기
1. 2단계에서 \(\mathbf{v}_i^\top A^\top A\mathbf{v}_j = \sigma_j^2\mathbf{v}_i^\top\mathbf{v}_j\)인 이유는?
\(\mathbf{v}_j\)가 \(A^\top A\)의 고유벡터라 \(A^\top A\mathbf{v}_j = \sigma_j^2\mathbf{v}_j\)이기 때문이다. 그다음 \(\mathbf{v}\)들이 정규직교라 \(\mathbf{v}_i^\top\mathbf{v}_j\)가 1 또는 0이다.
2. 3단계에서 \(i > r\)일 때 \(A\mathbf{v}_i = \mathbf{0}\)인 이유는?
\(\Vert A\mathbf{v}_i\Vert ^2 = \mathbf{v}_i^\top A^\top A\mathbf{v}_i = \lambda_i\Vert \mathbf{v}_i\Vert ^2 = 0\)이다. 길이가 0인 벡터는 영벡터다. 이 \(\mathbf{v}_i\)들이 영공간의 정규직교 기저다.
이 증명의 핵심 아이디어는?
일반 행렬 \(A\)는 대칭이 아니지만 \(A^\top A\)는 대칭이다. 대칭행렬의 좋은 성질(직교 고유벡터)을 빌려 입력 축을 정하고, \(A\)를 곱해 출력 축을 얻는다.
같은 생각을 쓰는 다른 상황은?
최소제곱의 \(A^\top A\), 공분산 행렬 \(X^\top X\)처럼 “전치를 곱해 대칭으로 만들기”는 선형대수 곳곳에 나온다. 주성분 분석은 데이터 행렬의 SVD가 곧 공분산 행렬의 고윳값 분해라는 관계를 쓴다.
예제
랭크 1로 줄이기. 위 \(A = \begin{pmatrix}3 & 0\\ 4 & 5\end{pmatrix}\)에서 큰 항 하나만 남긴다.
- 첫 항: \(A_1 = \sigma_1\mathbf{u}_1\mathbf{v}_1^\top = 3\sqrt5 \cdot \frac{1}{\sqrt{10}}\begin{pmatrix}1\\ 3\end{pmatrix}\frac{1}{\sqrt2}\begin{pmatrix}1 & 1\end{pmatrix} = \frac32\begin{pmatrix}1 & 1\\ 3 & 3\end{pmatrix}\).
- 오차: \(A - A_1 = \begin{pmatrix}1.5 & -1.5\\ -0.5 & 0.5\end{pmatrix} = \sigma_2\mathbf{u}_2\mathbf{v}_2^\top\). 가장 많이 늘이는 배율이 \(\sigma_2 = \sqrt5\)다.
- 의미: 랭크 1인 어떤 행렬도 이보다 \(A\)에 가깝지 않다. 성분 제곱합으로 재면 오차 \(\sigma_2^2 = 5\)는 전체 \(\sigma_1^2 + \sigma_2^2 = 50\)의 10%다.
활용
- 이미지 압축. \(m \times n\) 흑백 이미지를 랭크 \(k\)로 줄이면 수 \(k(m + n + 1)\)개만 저장한다. \(1000 \times 1000\) 이미지를 \(k = 50\)으로 줄이면 약 10만 개, 원래의 10%다. 자연 이미지는 특잇값이 빠르게 작아져 이 정도로도 알아볼 수 있다5.
- 추천 시스템. 사용자 × 상품 평점 행렬을 저랭크로 근사하면, 몇 개의 “취향 축”으로 사용자와 상품을 설명하고 빈칸(안 본 상품)의 평점을 예측한다5.
- 주성분 분석과 잡음 제거. 데이터 행렬(평균을 뺀 것)의 첫 몇 개 \(\mathbf{v}_i\)가 분산이 가장 큰 방향이다. 작은 특잇값 성분은 잡음인 경우가 많아 버린다.
- 최소제곱과 유사역행렬. \(A^+ = V\Sigma^+U^\top\)(\(\Sigma^+\)는 0이 아닌 \(\sigma_i\)를 \(1/\sigma_i\)로)로 \(\hat{\mathbf{x}} = A^+\mathbf{b}\)를 구하면, 열이 종속이어도 최소제곱 해 중 길이가 가장 짧은 것을 준다. NumPy의
lstsq가 이 방법이다. - 비용. 밀집 행렬의 SVD는 \(O(mn\min(m, n))\)이다. 큰 행렬에서는 필요한 \(k\)개만 반복법으로 구한다.
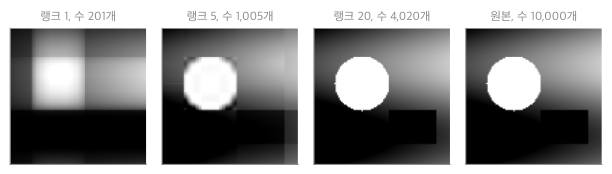
\(100 \times 100\) 합성 이미지를 랭크 1, 5, 20으로 줄였다. 랭크 20은 저장하는 수가 원본의 40%인데도 원본과 거의 구별되지 않는다(상대 오차 0.2%)1.
연결
- 선수: 대칭행렬과 스펙트럼 정리
- 비교: 고윳값과 고유벡터(같은 방향으로 늘이기) 대 특잇값(입력 축 → 출력 축)
- 이어지는 개념: 노름과 조건수(\(\sigma_1/\sigma_n\)), LU·QR·고윳값·SVD 비교
자주 하는 오해
틀렸다. 대칭행렬에서는 정말 그렇기 때문에 일반화하기 쉽다. 하지만 일반 행렬에서는 다르다. \(\begin{pmatrix}1 & 1\\ 0 & 1\end{pmatrix}\)의 고윳값은 1, 1인데 특잇값은 \(\frac{1 + \sqrt5}{2} \approx 1.618\)과 \(\frac{\sqrt5 - 1}{2} \approx 0.618\)이다. 고윳값은 “방향을 바꾸지 않는 벡터의 배율”이고, 특잇값은 “수직인 입력 축이 수직인 출력 축으로 가는 배율”이라 묻는 것이 다르다. 두 값이 같은 것은 대칭(더 일반적으로 정규) 행렬일 때다.
확인 문제
C1 \(A = U\Sigma V^\top\)에서 \(U\), \(\Sigma\), \(V\)의 모양과 성질을 쓰라.
답: \(U\)는 \(m \times m\) 직교 행렬(출력 축), \(V\)는 \(n \times n\) 직교 행렬(입력 축), \(\Sigma\)는 \(m \times n\)이고 대각에 \(\sigma_1 \ge \sigma_2 \ge \cdots \ge 0\)인 특잇값을 둔다. \(A\mathbf{v}_i = \sigma_i\mathbf{u}_i\).
C2 \(A = \begin{pmatrix}3 & 0\\ 4 & 5\end{pmatrix}\)의 특잇값을 \(A^\top A\)로 구하라.
답: \(A^\top A = \begin{pmatrix}25 & 20\\ 20 & 25\end{pmatrix}\)의 고윳값은 45와 5. 특잇값은 \(\sqrt{45} = 3\sqrt5\)와 \(\sqrt5\)다. 곱 \(15 = \vert \det A\vert\)로 확인된다.
C3 특잇값의 제곱이 \(A^\top A\)의 고윳값인 이유를 \(A = U\Sigma V^\top\)로 설명하라.
답: \(A^\top A = V\Sigma^\top U^\top U\Sigma V^\top = V(\Sigma^\top\Sigma)V^\top\)이다. \(\Sigma^\top\Sigma\)는 대각이 \(\sigma_i^2\)인 대각행렬이고 \(V\)는 직교라, 이것이 \(A^\top A\)의 스펙트럼 분해다.
C4 특잇값이 고윳값의 절댓값과 다른 행렬을 들라.
답: \(\begin{pmatrix}1 & 1\\ 0 & 1\end{pmatrix}\). 고윳값은 1, 1, 특잇값은 약 1.618, 0.618이다(\(A^\top A = \begin{pmatrix}1 & 1\\ 1 & 2\end{pmatrix}\)의 고윳값 \(\frac{3 \pm \sqrt5}{2}\)의 제곱근).
-
24_svd_plot.py로 그렸고, \(A\mathbf{v}_i = \sigma_i\mathbf{u}_i\)와 \(\sigma_1 = 3\sqrt5\), \(\sigma_2 = \sqrt5\), 랭크 \(k\) 근사의 상대 오차가 버린 특잇값으로 정해지는 것(랭크 1, 5, 20에서 약 31%, 9%, 0.2%)을 같은 코드로 확인했다. ↩ ↩2
-
Strang, Introduction to Linear Algebra 5판, 7.1절 “Image Processing by Linear Algebra”(저랭크 이미지), 7.2절 “Bases and Matrices in the SVD”(존재 증명, \(A\mathbf{v}_i = \sigma_i\mathbf{u}_i\), 예 \(\begin{pmatrix}3 & 0\\ 4 & 5\end{pmatrix}\)), 7.3절 “Principal Component Analysis by the SVD”, 7.4절 “The Geometry of the SVD”. ↩
-
이 문서
정의의 \(A = U\Sigma V^\top\), \(A\mathbf{v}_i = \sigma_i\mathbf{u}_i\)와예시로 보기의 “수직인 입력 축이 수직인 출력 축으로 \(\sigma_i\)배”를 옮겼다(Strang 5판 7.2절). ↩ -
에카르트–영 정리는 C. Eckart, G. Young, “The approximation of one matrix by another of lower rank”, Psychometrika 1 (1936)의 결과다. 24_svd_verify.py에서 무작위 랭크 \(k\) 행렬과 비교해 실험으로 확인했다(증명이 아니다). ↩ ↩2
-
저장량 \(k(m + n + 1)\)은 \(\mathbf{u}_i\), \(\mathbf{v}_i\), \(\sigma_i\)의 개수를 센 것이다. 저랭크 행렬 분해로 평점을 예측하는 방법은 넷플릭스 상 대회(2006~2009) 이후 추천 시스템의 표준 기법이 되었다(Koren·Bell·Volinsky, “Matrix factorization techniques for recommender systems”, IEEE Computer 2009). ↩ ↩2