변수가 많은 데이터에서 점들이 가장 넓게 퍼진 방향을 첫 번째 새 축으로, 그다음으로 넓게 퍼진 수직 방향을 두 번째 축으로 잡는 식으로 좌표를 다시 짠다. 앞의 몇 축만 남기면 정보를 크게 잃지 않고 차원을 줄일 수 있어, 시각화·압축·잡음 제거에 쓴다. 새 축은 공분산 행렬의 고유벡터이고, 각 축이 설명하는 분산이 고윳값이다. 하지만 변수의 단위가 다르면 큰 단위의 변수가 축을 독차지하고, 분산이 크다고 해서 목적(예: 분류)에 중요한 방향이라는 보장은 없다.
예시로 보기
두 센서 값이 공분산 행렬 \(\Sigma = \begin{pmatrix}4 & 2\\ 2 & 3\end{pmatrix}\)을 따른다. 점 구름은 오른쪽 위로 기운 타원이다(다변량 정규분포의 예시).
- 전체 분산은 대각합 \(4 + 3 = 7\)이다.
- \(\Sigma\)의 고윳값은 약 5.56과 1.44다. 긴 축 방향(첫 주성분)으로 투영하면 분산 5.56, 전체의 약 79.5%가 남는다.
- 점마다 첫 주성분 좌표 하나만 저장하면 두 수 대신 한 수로 정보의 80%를 보존한다.
긴 축이 아래 정의의 \(\mathbf{v}_1\), 5.56이 \(\lambda_1\), 79.5%가 설명된 분산 비율이다.
정의
적용 조건. 수치 변수가 여럿이고, 그 사이에 상관이 있어 정보가 겹칠 때. 선형 구조(직선·평면 방향)로 요약해도 괜찮을 때.
알아보는 신호. “차원을 줄여라”, “2차원으로 그려 보라”, “변수 수백 개를 몇 개로 요약하라”, “상관이 높은 특징들”.
절차. 자료 \(n\)개, 변수 \(d\)개인 행렬 \(X\)(\(n \times d\))에서
- 가운데로 옮기기: 열마다 평균을 빼 \(\tilde X\)를 만든다(단위가 다르면 표준편차로도 나눈다).
- 공분산 행렬: \(\Sigma = \frac1n\tilde X^\top\tilde X\)(\(^\top\)는 행과 열을 바꾸는 전치).
- 고유분해: 스펙트럼 정리로 \(\Sigma = V\Lambda V^\top\), 고윳값 \(\lambda_1 \ge \cdots \ge \lambda_d \ge 0\).
- 투영: 앞의 \(k\)개 고유벡터로 점수 \(\tilde X V_k\)를 구한다. 설명된 분산 비율은 \(\frac{\lambda_1 + \cdots + \lambda_k}{\lambda_1 + \cdots + \lambda_d}\).
실무에서는 \(\Sigma\)를 만들지 않고 \(\tilde X\)의 특잇값 분해 \(\tilde X = U S V^\top\)로 바로 구한다. 오른쪽 특이벡터가 주성분 방향이고 \(\lambda_i = \frac{s_i^2}{n}\)이다. \(\tilde X^\top\tilde X\)를 만들면 조건수가 제곱으로 나빠지기 때문이다1.
flowchart TD
    X["자료 행렬 X, n × d"] --> C["열마다 평균 빼기"]
    C --> Q{"변수 단위가 서로 다른가"}
    Q -->|"예"| S["열마다 표준편차로도 나누기"]
    Q -->|"아니오"| K{"계산 방법"}
    S --> K
    K -->|"교과서식"| E["공분산 행렬 Σ를 만들어 고유분해"]
    K -->|"실무"| V["X̃의 특잇값 분해"]
    E --> P["앞의 k개 방향으로 투영해 점수 구하기"]
    V --> P
    P --> R["설명된 분산 비율 확인"]
위쪽 갈림길에서 표준화 여부를 정하고, 아래쪽 두 계산 길 중 하나로 같은 주성분에 닿는다.2
단위벡터 \(\mathbf{v}\) 방향으로 투영한 값의 분산 \(\mathbf{v}^\top\Sigma\mathbf{v}\)는 \(\mathbf{v}\)가 \(\Sigma\)의 가장 큰 고윳값의 고유벡터일 때 최대 \(\lambda_1\)이다. 그와 수직인 방향 중에서는 둘째 고유벡터가 최대 \(\lambda_2\)를 주고, 이런 식으로 이어진다. 서로 다른 주성분의 점수끼리는 공분산이 0이다.
증명 펼치기
- 분산을 식으로: 가운데로 옮긴 자료를 \(\mathbf{v}\)로 투영한 값 \(\tilde{\mathbf{x}}_i^\top\mathbf{v}\)의 분산은 \(\frac1n\sum(\tilde{\mathbf{x}}_i^\top\mathbf{v})^2 = \mathbf{v}^\top\Sigma\mathbf{v}\).
- 제약 최적화: \(\Vert \mathbf{v}\Vert = 1\) 아래 \(\mathbf{v}^\top\Sigma\mathbf{v}\)를 최대화한다. 라그랑주 승수법으로 \(2\Sigma\mathbf{v} = \lambda \cdot 2\mathbf{v}\), 곧 후보는 고유벡터다.
- 후보 비교: 고유벡터에서 \(\mathbf{v}^\top\Sigma\mathbf{v} = \lambda\)라 가장 큰 고윳값이 최대다.
- 무상관: 두 고유벡터의 점수의 공분산은 \(\mathbf{v}_i^\top\Sigma\mathbf{v}_j = \lambda_j\mathbf{v}_i^\top\mathbf{v}_j = 0\)(대칭행렬의 고유벡터는 직교). ∎
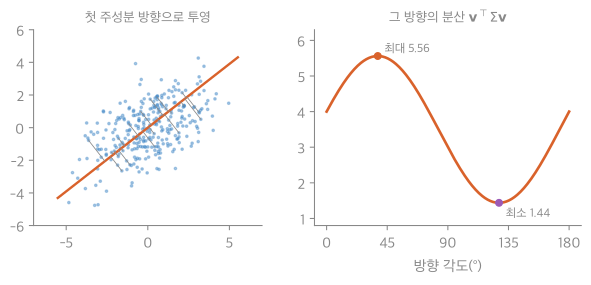
왼쪽은 예시의 \(\Sigma\)에서 뽑은 점 300개와 첫 주성분 직선이다. 회색 선분은 점을 그 직선에 수직으로 내린 것이다. 오른쪽은 단위벡터의 방향을 0°에서 180°까지 돌리며, 그 방향으로 투영한 값의 분산 \(\mathbf{v}^\top\Sigma\mathbf{v}\)를 그린 것이다. 최대 5.56과 최소 1.44가 두 고윳값이고, 두 방향은 90° 떨어져 있다3.
스스로 설명해 보기
1. 증명 1단계에서 자료를 가운데로 옮기지 않으면 무엇이 달라지는가?
\(\frac1n\sum(\mathbf{x}_i^\top\mathbf{v})^2\)는 분산이 아니라 원점에서의 제곱 평균이 된다. 평균이 원점에서 멀면 첫 “주성분”이 흩어진 방향이 아니라 원점에서 평균 쪽을 가리키게 된다.
2. 2단계의 라그랑주 조건에서 승수 \(\lambda\)가 고윳값과 같은 이유는?
조건 \(\Sigma\mathbf{v} = \lambda\mathbf{v}\)가 고유벡터의 정의 그 자체라서, 승수가 곧 고윳값이다. 그리고 그 값이 곧 그 방향의 분산이다(3단계).
3. 주성분 분석의 핵심 아이디어는?
“정보 = 흩어짐”으로 보고, 흩어짐(분산)을 가장 많이 담는 수직 축들로 좌표를 돌린다. 좌표를 돌려도 전체 분산(대각합)은 그대로이고 축별로 재배치될 뿐이라, 앞쪽 축에 몰아넣고 뒤쪽을 버린다.
예제
대표 문제 1: 손으로 하는 PCA. 점 \((2, 1), (-2, -1), (1, 2), (-1, -2)\).
- 가운데: 평균이 이미 \((0, 0)\)이다.
- 공분산: \(\Sigma = \frac14\begin{pmatrix}10 & 8\\ 8 & 10\end{pmatrix} = \begin{pmatrix}2.5 & 2\\ 2 & 2.5\end{pmatrix}\).
- 고유분해: 고윳값 4.5(방향 \(\frac{1}{\sqrt2}(1, 1)\))와 0.5(방향 \(\frac{1}{\sqrt2}(1, -1)\)).
- 투영: 첫 주성분이 분산의 \(\frac{4.5}{5} = 90\%\)를 설명한다. 점 \((2, 1)\)의 첫 주성분 점수는 \(\frac{2 + 1}{\sqrt2} \approx 2.12\)다.
대표 문제 2: 단위가 다른 변수. 같은 공통 요인을 따르는 두 변수 중 하나를 1,000배 큰 단위(m → mm)로 적으면, 첫 주성분이 거의 그 변수 축으로 쏠린다. 분산이 단위의 제곱으로 커지기 때문이다. 각 변수를 표준편차로 나눠(표준화) 공분산 대신 상관 행렬로 PCA하면 두 변수가 다시 같은 비중을 가진다.
활용
- 시각화. 수십 차원의 특징을 첫 두 주성분으로 투영해 산점도로 본다.
- 압축과 잡음 제거. 뒤쪽 주성분은 대개 잡음이라, 앞의 \(k\)개만으로 재구성하면 잡음이 줄고 저장 공간이 준다. 이것은 잘린 SVD로 한 저랭크 근사와 같다.
- 전처리. 상관이 높은 특징을 서로 무상관인 소수의 특징으로 바꿔 회귀나 분류에 넣는다.
- 연습: 주성분 분석 예제 사다리
연결
자주 하는 오해
틀렸다. 주성분 분석은 결과(정답 라벨)를 보지 않고 흩어짐만 본다. 그래서 흩어짐이 큰 방향이 중요한 방향처럼 느껴진다. 하지만 두 부류가 분산이 작은 방향으로만 갈리고 분산이 큰 방향으로는 섞여 있으면, 첫 주성분에 투영한 순간 부류가 뒤섞인다. 모의실험에서 첫 주성분으로 가른 정확도는 약 51%(동전 던지기 수준), 둘째 축으로는 거의 100%였다. 목적이 분류라면 라벨을 쓰는 방법(선형 판별 분석 등)과 비교하고, 버린 성분에 신호가 없는지 확인한다.
과목별 관점
데이터 과학 (3-2학기). PCA를 고차원 자료의 군집화 앞 단계로 쓴다. \(n \times d\) 자료를 주성분 \(k\)개 축으로 투영해 \(n \times k\)로 줄인 뒤, 줄인 공간에서 군집화 알고리즘을 돌린다.
평균을 빼는 이유는 숫자로 보면 분명하다. 점 (100, 30), (101, 31), (99, 29)는 평균 (100, 30)을 빼면 (0, 0), (1, 1), (−1, −1)이 되어, 절대 위치가 아니라 흩어짐만 남는다. 값의 범위가 큰 속성이 작은 속성을 덮는 것도 막는다. 이어서 \(\operatorname{Var}(\mathbf w^\top\bar{\mathbf x}) = \mathbf w^\top\Sigma\mathbf w\)를 \(\Vert \mathbf w\Vert = 1\) 아래 최대화하는 문제를 라그랑주 승수법으로 풀면 주성분이 공분산 행렬의 고유벡터로 나온다.
군집화의 관점에서 본 장단점:
- 장점: 차원의 저주를 누그러뜨린다. 잡음과 쓸모없는 차원을 덜어 낸다. 자료의 큰 줄기를 잡는다.
- 단점: 군집을 보고 줄이는 것이 아니다. 군집을 가르는 정보가 분산이 작은 방향에 있으면 버려진다. 성분이 양수·음수 가중치의 선형 결합이라 속성들이 서로 상쇄되어 군집 차이가 흐려질 수 있다. 모든 속성을 섞으므로 “부분들의 합”으로 읽히지 않는다. 이 단점을 푸는 방법이 행렬 분해 군집화(NMF)다.
확인 문제
C1 공분산 행렬 \(\begin{pmatrix}2 & 1\\ 1 & 2\end{pmatrix}\)에서 첫 주성분의 방향과 설명된 분산 비율은?
답: 고윳값 3(방향 \(\frac{1}{\sqrt2}(1, 1)\))과 1. 비율 \(\frac{3}{3 + 1} = 75\%\).
C2 첫 주성분이 공분산 행렬의 가장 큰 고윳값의 고유벡터인 이유를 최적화 문제로 설명하라.
답: 단위벡터 \(\mathbf{v}\) 방향 투영의 분산은 \(\mathbf{v}^\top\Sigma\mathbf{v}\)다. \(\Vert \mathbf{v}\Vert = 1\) 제약 아래 이것을 최대화하면 라그랑주 조건 \(\Sigma\mathbf{v} = \lambda\mathbf{v}\)가 나와 후보가 고유벡터뿐이고, 그때 목적값이 \(\lambda\)라 가장 큰 고윳값이 최대다.
C3 평균이 0인 자료에서 첫 주성분 방향이 \(\frac{1}{\sqrt2}(1, 1)\)이다. 점 \((3, 1)\)의 첫 주성분 점수는?
답: 내적 \(\frac{3 + 1}{\sqrt2} = 2\sqrt2 \approx 2.83\).
C4 표준화하지 않고 PCA를 하면 결과가 왜곡되는 예를 들어라.
답: 키(m)와 몸무게(kg)처럼 단위가 다른 변수에서, 키를 mm로 바꾸기만 해도 키의 분산이 \(10^6\)배가 되어 첫 주성분이 거의 키 축이 된다. 자료의 구조는 그대로인데 단위 선택이 결과를 바꾼 것이다. 표준화(상관 행렬 PCA)하면 이 문제가 사라진다.
C5 PCA로 1차원으로 줄인 뒤 군집화하면 군집이 사라지는 2차원 자료의 예를 들라.
답: 두 군집이 \(x\)축으로 길게 퍼져 있고(\(x\) 방향 분산이 큼) \(y\) 방향으로만 조금 떨어져 있는 자료. 예: 군집 A는 \((t, 0)\), 군집 B는 \((t, 1)\), \(t\)는 −10~10. 첫 주성분은 \(x\)축이라, 거기로 투영하면 두 군집이 완전히 겹친다. 군집을 가르는 정보가 분산이 작은 \(y\) 방향에 있었다4.
-
Strang, Introduction to Linear Algebra 5판, 7.3절 “Principal Component Analysis (PCA by the SVD)”(공분산 행렬, 특잇값 분해로 구하는 주성분, 설명된 분산). ↩
-
이 문서 정의 절의 절차 1~4단계와 특잇값 분해 문단을 그렸다. ↩
-
36_pca_plot.py로 그렸고, 그림에 쓴 값(고윳값 5.56과 1.44, 각도별 분산의 최대·최소, 설명된 분산 비율 0.795)을 같은 코드로 확인했다. ↩
-
36_pca_verify.py로 확인했다. ↩