자료 표를 두 개의 작은 표의 곱으로 나눈다. 한 표는 “각 자료가 몇 가지 숨은 재료를 얼마씩 섞었나”, 다른 표는 “각 재료가 어떤 속성으로 이루어졌나”다. 재료의 양을 음수가 될 수 없게(비음수) 하면 재료를 빼서 상쇄할 수 없어, 자료가 “부분들의 합”으로 읽히고 가장 많이 섞인 재료가 곧 군집이 된다. 여기에 L1 벌점을 더하면 재료 대부분의 양이 0이 되어 주된 군집이 뚜렷해진다. 다만 답이 처음 값에 따라 달라진다.
예시로 보기
거리로 군집을 나누는 방법은 고차원에서 불안정하다(차원의 저주). 그래서 원래 속성 대신 숨은 성분 몇 개로 자료를 나타낸다.
문서 6개에 단어 6개가 몇 번 나왔는지 센 표 \(X\)가 있다. 문서 1~3은 “공, 골, 경기”가 많고, 문서 4~6은 “맛, 불, 냄비”가 많다1.
\[X = \begin{pmatrix} 5&3&4&0&1&0 \\ 4&4&3&0&0&1 \\ 3&5&4&1&0&0 \\ 0&1&0&4&5&3 \\ 1&0&0&5&3&4 \\ 0&0&1&3&4&5 \end{pmatrix} \approx WH\]성분 \(k = 2\)로 비음수 행렬 분해를 하면, \(W\)(문서 × 성분)는 다음과 같이 나온다.
| 문서 | 성분 1 | 성분 2 | 군집 |
|---|---|---|---|
| 1~3 | 약 0.05 | 약 1.1~1.2 | 2 |
| 4~6 | 약 1.49 | 약 0.05 | 1 |
각 문서에서 가장 큰 칸이 그 문서의 군집이다. 스포츠 문서와 요리 문서가 정확히 나뉜다. \(H\)(성분 × 단어)의 성분 2는 스포츠 단어, 성분 1은 요리 단어에 큰 값을 가진 “주제”다.
정의
행렬 분해 군집화. 자료 \(X \in \mathbb{R}^{n \times d}\)(\(n\)개 자료, \(d\)개 속성)를 두 잠재 성분 행렬의 곱으로 나눈다.
\[X \approx WH, \qquad W \in \mathbb{R}^{n \times k},\ H \in \mathbb{R}^{k \times d}\]자료 \(i\)는 성분들의 결합이다. \(\mathbf x_i \approx \sum_{j=1}^{k} W_{i,j}\mathbf H_j\)(\(\mathbf H_j\)는 \(H\)의 \(j\)번째 행, 곧 성분 \(j\)). 각 자료는 적은 수의 잠재 성분, 곧 군집에서 만들어진다고 본다.
        d개 속성                k개 성분         d개 속성
     ┌───────────┐            ┌─────┐        ┌───────────┐
     │           │            │     │      k │     H     │
   n │     X     │   ≈      n │  W  │   ×    └───────────┘
     │           │            │     │
     └───────────┘            └─────┘
   자료 i = X의 i번째 행     W의 i번째 행    H의 j번째 행 = 성분 j
\(k\)는 \(n\)과 \(d\)보다 훨씬 작다. 그래서 \(W\)와 \(H\)의 칸 수를 합해도 \(X\)의 칸 수보다 훨씬 적다. \(W\)의 가로 길이와 \(H\)의 세로 길이가 같은 \(k\)여야 곱할 수 있다.
비음수 행렬 분해(NMF). 실제 값과 예측값의 차이를 최소화하되 두 행렬에 음수를 허용하지 않는다.
\[\min_{W, H \ge 0}\Vert X - WH\Vert ^2\]\(\Vert \cdot\Vert ^2\)은 모든 칸의 차이 제곱 합(프로베니우스 노름의 제곱)이다. 음수가 없으면 빼기가 없어 상쇄가 생기지 않고, 더하기만으로 자료를 만든다. 그래서 부분 기반 표현이 되고 군집으로 읽기 쉽다. \(W\)의 \(i\)번째 행 \(\mathbf w_i = (W_{i1}, \dots, W_{ik})\)가 자료 \(i\)의 군집 소속이다.
L1 정칙화. \(W\)에 L1 벌점을 더한다.
\[\min_{W, H \ge 0}\Vert X - WH\Vert ^2 + \lambda\Vert W\Vert _1, \qquad \Vert W\Vert _1 = \sum_{i,j}\vert W_{i,j}\vert\]\(\lambda\)는 벌점의 세기다. 많은 \(W_{i,j}\)가 비슷한 값이면(예: \((0.22, 0.18, 0.25, 0.20, 0.15)\)) 어느 군집이 주된 것인지 정하기 어렵다. L1 벌점은 많은 칸을 0으로 밀어 낸다.
왜 L2가 아니라 L1인가? 2차원으로 보면 L1이 허용하는 영역 \(\vert w_1\vert + \vert w_2\vert \le c\)는 꼭짓점이 축 위에 있는 마름모다. 오차의 등고선이 이 마름모에 처음 닿는 곳은 꼭짓점일 때가 많고, 꼭짓점에서는 한 좌표가 0이다(예: \((0.01, 0.99)\)). L2 영역 \(w_1^2 + w_2^2 \le c\)는 매끄러운 원이라 닿는 곳에서 두 좌표가 모두 0이 아니다(예: \((0.25, 0.75)\)).
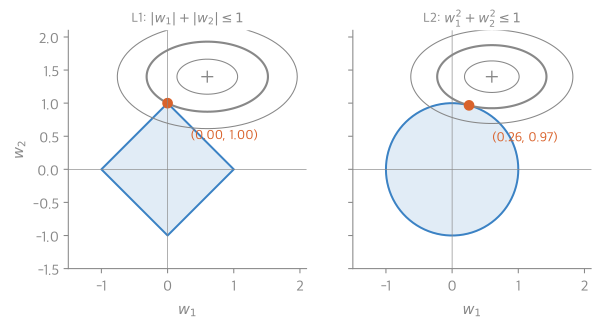
오차가 가장 작은 곳(+)을 (0.6, 1.4)에 두고, 등고선을 키워 가며 허용 영역에 처음 닿는 곳(주황 점)을 찾았다. 마름모에서는 꼭짓점 (0, 1)에 닿아 \(w_1\)이 정확히 0이 된다. 원에서는 (0.26, 0.97)에 닿아 두 값이 모두 남는다2.
푸는 법
\(W\)와 \(H\)를 번갈아 고치는 곱셈 갱신이 흔하다1.
\[H \leftarrow H \odot \frac{W^\top X}{W^\top W H}, \qquad W \leftarrow W \odot \frac{X H^\top}{W H H^\top + \lambda}\]\(\odot\)과 분수는 칸끼리의 곱과 나눗셈이다. 곱하고 나누기만 해서 음수가 생기지 않는다. 문제가 볼록하지 않아 처음 값에 따라 답이 달라진다.
연결
- 선수: 차원의 저주, 행렬 곱셈과 전치, 주성분 분석(부호가 섞인 분해)
- 음수 제약이 없는 분해: 특잇값 분해. 행렬 분해 추천도 같은 \(X \approx WH\)다.
- L1과 L2 노름: 민코프스키 거리의 \(h = 1, 2\)
- 비교: PCA와 NMF 비교
확인 문제
C1 NMF 군집화의 목적 함수(L1 포함)를 쓰고, \(W\)의 행이 무엇을 뜻하는지 말하라.
답: \(\min_{W, H \ge 0}\Vert X - WH\Vert ^2 + \lambda\Vert W\Vert _1\). \(W\)의 \(i\)번째 행은 자료 \(i\)가 성분(군집) \(k\)개를 얼마씩 섞었는지, 곧 군집 소속이다. 가장 큰 칸이 그 자료의 군집이다.
C2 비음수 제약이 군집 해석을 돕는 이유를 “상쇄”라는 말로 설명하라.
답: 음수를 허용하면 한 성분을 크게 더하고 다른 성분을 크게 빼서 자료를 맞출 수 있다. 그러면 성분의 양이 “이 자료가 그 군집에 얼마나 속하는가”로 읽히지 않는다. 음수가 없으면 더하기만 하므로, 큰 양을 가진 성분이 곧 그 자료를 이룬 주된 부분이다.
C3 같은 벌점 세기에서 L1이 L2보다 0인 칸을 많이 만드는 이유를 그림으로 설명하라.
답: L1의 허용 영역은 축 위에 뾰족한 꼭짓점이 있는 마름모라, 오차 등고선이 처음 닿는 곳이 꼭짓점(한 좌표가 0)일 때가 많다. L2는 둥근 원이라 닿는 곳이 축 위가 아닌 경우가 대부분이어서 좌표들이 작아질 뿐 0이 되지 않는다.
-
35_nmf-clustering_plot.py로 그렸다. 오차는 \((w_1 - 0.6)^2 + 3(w_2 - 1.4)^2\)로 정했고, 경계 위 2만 개 점에서 가장 작은 곳이 L1에서 (0, 1), L2에서 (0.26, 0.97)임을 같은 코드로 확인했다. ↩