결과(검사 양성, 스팸 단어)를 보고 원인(병, 스팸)이 있을 확률을 거꾸로 계산하는 규칙이다. 원래 그 원인이 얼마나 흔한지(기저율)에, 이 증거가 그 원인에서 얼마나 더 잘 나오는지를 곱해 믿음을 갱신한다. 새 증거가 들어올 때마다 같은 계산을 되풀이하면 된다. 가장 흔한 실수는 기저율을 잊는 것이다. 99% 정확한 검사에서 양성이 나와도, 병이 아주 드물면 실제로 병이 있을 확률은 낮을 수 있다.
예시로 보기
어떤 병의 유병률이 1%, 검사는 병이 있으면 95% 양성(민감도), 병이 없어도 5% 양성(위양성률)이다. 양성이 나온 사람이 실제로 병이 있을 확률은?
사람 1만 명으로 바꿔 세면 분명해진다.
| 양성 | 음성 | 합 | |
|---|---|---|---|
| 병 있음 | 95 | 5 | 100 |
| 병 없음 | 495 | 9,405 | 9,900 |
| 합 | 590 | 9,410 | 10,000 |
양성 590명 중 병이 있는 사람은 95명뿐이라 \(\frac{95}{590} \approx 16\%\)다. 병 없는 사람이 99배 많아서, 5%의 위양성이 95명의 진양성보다 많아졌다. 표의 첫 열 비율 계산이 아래 정리의 식이다. “병 있음”이 원인 \(H\), “양성”이 증거 \(E\)다.
flowchart LR
    T["1만 명"] -->|"유병률 1%"| D["병 있음 100명"]
    T -->|"99%"| H["병 없음 9,900명"]
    D -->|"민감도 95%"| DP["양성 95명"]
    D -->|"5%"| DN["음성 5명"]
    H -->|"위양성률 5%"| HP["양성 495명"]
    H -->|"95%"| HN["음성 9,405명"]
양성으로 끝나는 가지는 두 개다. 첫 갈림길은 원인(\(H\)), 둘째 갈림길은 원인에서 증거(\(E\))가 나오는 확률이다. 사후확률은 양성 가지 두 개의 사람 수 95와 495 중 95의 몫이다.1
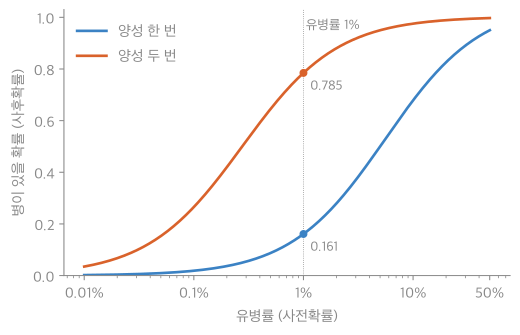
가로축은 유병률, 세로축은 양성일 때 실제로 병이 있을 확률이다. 같은 검사라도 유병률이 1%면 0.161, 10%면 0.679로 크게 바뀐다. 양성이 두 번 나오면(주황) 곡선이 왼쪽으로 크게 옮겨 가서, 유병률 1%에서도 0.785가 된다2.
정의
\(P(E) > 0\), \(P(H) > 0\)이면
\[P(H \mid E) = \frac{P(E \mid H)\,P(H)}{P(E)}.\]원인 후보 \(H_1, \dots, H_n\)이 \(\Omega\)의 분할이면 분모를 전확률 공식으로 쓴다.
\[P(H_i \mid E) = \frac{P(E \mid H_i)\,P(H_i)}{\sum_j P(E \mid H_j)\,P(H_j)}.\]용어는 이렇다. \(P(H)\)는 증거를 보기 전의 사전확률, \(P(E \mid H)\)는 원인 \(H\)에서 증거가 나올 가능도, \(P(H \mid E)\)는 증거를 본 뒤의 사후확률이다3.
오즈 꼴. 오즈(odds)는 \(\frac{P(H)}{P(H^c)}\), “될 확률 대 안 될 확률”이다. 정리를 \(H\)와 \(H^c\)에 각각 쓰고 나누면 분모 \(P(E)\)가 지워진다.
\[\underbrace{\frac{P(H \mid E)}{P(H^c \mid E)}}_{\text{사후 오즈}} = \underbrace{\frac{P(H)}{P(H^c)}}_{\text{사전 오즈}} \times \underbrace{\frac{P(E \mid H)}{P(E \mid H^c)}}_{\text{가능도비}}.\]예시에서 사전 오즈 \(1 : 99\), 가능도비 \(\frac{0.95}{0.05} = 19\)라 사후 오즈 \(19 : 99\), 확률로 \(\frac{19}{118} \approx 0.161\)이다.
가정과 그 필요성.
| 가정 | 빠지면 |
|---|---|
| \(P(E) > 0\) | 일어날 수 없는 증거로는 조건을 걸 수 없다(조건부 확률이 정의되지 않음) |
| 분모의 \(H_j\)들이 분할(겹치지 않고 전체를 덮음) | 원인 후보를 하나 빠뜨리면 분모가 작아져 사후확률이 부풀려진다. 사전확률 0.5·0.3·0.2, 가능도 0.1·0.4·0.9인 원인 A·B·C에서 C를 빼고 계산하면, A의 사후확률이 0.14 대신 0.29로 두 배가 넘게 나온다 |
| 증거를 여러 번 쓸 때 조건부 독립 | 같은 검사를 두 번 해도 오류 원인이 같으면(같은 교차 반응) 두 번째 양성은 새 정보가 적다. 곱해서 갱신하면 과신한다 |
증명 펼치기
- 곱셈 법칙을 두 방향으로: \(P(H \cap E) = P(H \mid E)\,P(E)\)이고 \(P(H \cap E) = P(E \mid H)\,P(H)\)다.
- 같게 놓기: 두 식의 좌변이 같으므로 \(P(H \mid E)\,P(E) = P(E \mid H)\,P(H)\).
- 나누기: \(P(E) > 0\)이므로 양변을 \(P(E)\)로 나눈다.
- 분모 펼치기: \(H_j\)들이 분할이면 전확률 공식으로 \(P(E) = \sum_j P(E \mid H_j)P(H_j)\). ∎
스스로 설명해 보기
1. 증명 1단계의 두 식은 각각 무엇에서 나오는가?
조건부 확률의 정의 \(P(A \mid B) = \frac{P(A \cap B)}{P(B)}\)를 \(B = E\)로, 또 \(B = H\)로 쓰고 양변에 분모를 곱한 것이다. \(H \cap E = E \cap H\)라 좌변이 같다.
2. 오즈 꼴에서 \(P(E)\)가 사라지는 이유는?
\(P(H \mid E)\)와 \(P(H^c \mid E)\)의 분모가 똑같이 \(P(E)\)라 비를 취하면 약분된다. 그래서 가능도비만 알면 전확률을 계산하지 않고도 갱신할 수 있다.
3. 이 정리의 핵심 아이디어는?
“원인 → 증거” 방향의 확률(모델이나 검사 성능으로 알 수 있음)을 “증거 → 원인” 방향(우리가 알고 싶은 것)으로 뒤집는다. 뒤집을 때 사전확률이 곱해진다는 것이 핵심이다.
4. 같은 방법을 쓰는 다른 상황은?
스팸 필터(단어 → 스팸), 고장 진단(증상 → 부품), 음성 인식(소리 → 단어), 통계에서 모수를 추정하는 베이즈 추론. 모두 “원인에서 관측이 나오는 모델”을 뒤집는다.
예제
두 번 연속 양성. 예시의 사람이 같은 성능의 검사를 한 번 더 받았고, 또 양성이다. 두 검사의 오류는 병의 유무가 주어지면 서로 독립이라 하자.
- 새 사전확률: 첫 검사 뒤의 사후확률 \(0.161\)이 두 번째 검사의 사전확률이 된다.
- 분자: \(0.161 \times 0.95 \approx 0.153\).
- 분모: \(0.153 + 0.839 \times 0.05 \approx 0.195\).
- 결론: \(\frac{0.153}{0.195} \approx 0.785\). 증거가 쌓이면 사후확률이 빠르게 움직인다. 오즈 꼴로는 사전 오즈 \(1 : 99\)에 가능도비 19를 두 번 곱한 \(361 : 99\)다.
활용
- 나이브 베이즈 분류. 메일에 나온 단어들 \(w_1, \dots, w_k\)가 스팸 여부가 주어지면 서로 독립이라고 (순진하게) 가정하고, \(P(\text{스팸} \mid w_1, \dots, w_k) \propto P(\text{스팸})\prod_i P(w_i \mid \text{스팸})\)로 계산한다. 가정은 틀리지만 실제 스팸 필터에서 잘 작동해 널리 쓰였다4.
- 검사와 경보의 해석. 침입 탐지, 사기 탐지처럼 실제 사건이 드문 곳에서는 위양성이 진양성보다 많기 쉽다. 경보의 정밀도는 검출률만이 아니라 기저율에 달려 있다.
- 흔한 실수. 기저율 무시, 원인 후보 빠뜨리기, 같은 원인을 공유하는 증거를 독립으로 곱하기.
- 연습: 베이즈 정리 예제 사다리
연결
- 선수: 조건부 확률(곱셈 법칙, 전확률 공식)
- 이어지는 개념: 확률변수 전체에 대한 베이즈 추론과 MAP
자주 하는 오해
틀렸다. 검사 성능 \(P(\text{양성} \mid \text{병})\)과 알고 싶은 \(P(\text{병} \mid \text{양성})\)을 같은 것으로 본 것이다. 성능은 병이 있는 사람들 안에서의 비율이라 기저율과 무관해 보인다. 하지만 양성인 사람들 중에는 병 없는 사람의 위양성이 섞이고, 병이 드물수록 그 비중이 커진다. 유병률 0.1%, 민감도 99%, 위양성률 1%라면 양성일 때 병일 확률은 약 9%다. 1만 명(또는 10만 명) 표를 그려 확인한다.
확인 문제
C1 유병률 0.1%, 민감도 99%, 위양성률 1%인 검사에서 양성이 나왔다. 병이 있을 확률은?
답: \(\frac{0.99 \times 0.001}{0.99 \times 0.001 + 0.01 \times 0.999} = \frac{0.00099}{0.01098} \approx 0.090\). 10만 명이면 병 100명 중 99명이 양성, 건강한 99,900명 중 999명이 양성이다.
C2 같은 검사라도 유병률이 낮은 집단에서 양성의 의미가 약해지는 이유를 설명하라.
답: 양성의 출처는 진양성과 위양성 두 가지다. 유병률이 낮으면 건강한 사람이 압도적으로 많아, 작은 위양성률을 곱해도 위양성의 수가 진양성의 수를 넘는다. 사후확률은 “양성 중 진양성의 비율”이라 작아진다.
C3 오즈 꼴로 예시의 사후확률을 구하라(유병률 1%, 민감도 95%, 위양성률 5%).
답: 사전 오즈 \(\frac{0.01}{0.99} = 1 : 99\). 가능도비 \(\frac{0.95}{0.05} = 19\). 사후 오즈 \(19 : 99\), 확률 \(\frac{19}{19 + 99} = \frac{19}{118} \approx 0.161\).
C4 다음 중 검사 회사가 광고하는 값과 환자가 알고 싶은 값은 각각 무엇인가? (가) \(P(\text{양성} \mid \text{병})\) (나) \(P(\text{병} \mid \text{양성})\) (다) \(P(\text{음성} \mid \text{건강})\)
답: 검사 회사는 (가) 민감도와 (다) 특이도를 광고한다. 둘 다 기저율과 무관한 검사의 성질이다. 환자가 알고 싶은 것은 (나) 양성 예측도이고, 이것은 기저율에 따라 달라진다.
-
이 문서 예시의 1만 명 표를 원인 → 증거 순서의 확률 나무로 옮겼다. 근거는 Blitzstein·Hwang 2판 2.3절의 검사 예제다. ↩
-
06_bayes-theorem_plot.py로 그렸고, 그림에 쓴 값(유병률 1%에서 0.161과 0.785, 10%에서 0.679)을 같은 코드로 확인했다. ↩
-
Blitzstein, Hwang, Introduction to Probability 2판, 2.3절 “Bayes’ rule and the law of total probability”(정리, 오즈 꼴, 검사 예제), 2.6절 “Coherency of Bayes’ rule”(증거를 한꺼번에 또는 차례로 반영해도 같다), 2.8절 “Pitfalls and paradoxes”(검사 오류 혼동). ↩
-
나이브 베이즈 스팸 필터는 Paul Graham의 글 “A Plan for Spam”(2002)으로 널리 알려졌다. 조건부 독립 가정이 틀려도 분류 성능이 좋은 이유는 이 과정의 범위 밖이다. ↩