실제 분포를 따르는 기호를, 잘못 믿은 다른 분포에 맞춰 만든 부호로 보내면 평균 비트가 엔트로피보다 늘어난다. 그 평균 비트가 교차 엔트로피이고, 늘어난 만큼이 KL 발산이다. KL 발산은 “믿은 분포가 실제와 얼마나 다른가”를 재는 대표적인 수라서, 분류 모델은 예측 분포와 정답 분포의 교차 엔트로피를 줄이도록 학습한다. 이것은 최대가능도와 같은 계산이다. 다만 거리처럼 쓰이지만 두 분포의 순서를 바꾸면 값이 달라지고, 믿은 분포가 불가능하다고 한 일이 실제로 일어나면 무한대가 된다.
예시로 보기
엔트로피의 예시처럼 로그 상태가 \(p = \left(\frac12, \frac14, \frac18, \frac18\right)\)로 나온다. 최적 부호는 평균 1.75비트다. 분포를 모르고 넷이 똑같다고(균등분포 \(q\)) 가정해 모든 상태에 2비트를 주면 평균 2비트를 쓴다.
- 교차 엔트로피 \(H(p, q) = 2\)비트: 틀린 분포에 맞춘 부호의 평균 길이.
- 엔트로피 \(H(p) = 1.75\)비트: 맞는 분포에 맞춘 부호의 평균 길이.
- KL 발산 \(D(p \Vert q) = 2 - 1.75 = 0.25\)(\(\lVert\cdot\rVert\)는 벡터의 길이)비트: 틀린 가정 때문에 기호마다 낭비한 비트.
\(p\)가 아래 식의 실제 분포, \(q\)가 모델이 믿는 분포다.
정의
같은 값들 위의 분포 \(p\), \(q\)에 대해
\[H(p, q) = -\sum_x p(x)\log_2 q(x),\qquad D(p \,\Vert \, q) = \sum_x p(x)\log_2\frac{p(x)}{q(x)} = H(p, q) - H(p)\]를 각각 교차 엔트로피, KL 발산(상대 엔트로피)이라 한다. \(p(x) > 0\)인데 \(q(x) = 0\)인 \(x\)가 있으면 둘 다 \(+\infty\)다1.
flowchart LR
    p["실제 분포 p"] --> H["엔트로피 H(p): 맞는 부호의 평균 비트"]
    p --> X["교차 엔트로피 H(p, q): q에 맞춘 부호의 평균 비트"]
    q["모델이 믿는 분포 q"] --> X
    X -->|"H(p)를 뺌"| D["KL 발산 D(p ‖ q): 낭비한 비트"]
    H --> D
교차 엔트로피에서 엔트로피를 빼면 KL 발산이 남는다. \(p\)와 \(q\)가 둘 다 들어가는 칸은 교차 엔트로피와 KL 발산뿐이다.2
\(D(p \Vert q) \ge 0\)이고, 등호는 \(p = q\)일 때만이다. 곧 \(H(p, q) \ge H(p)\)다.
증명 펼치기
- 자연로그로: \(-D(p\Vert q)\ln 2 = \sum_x p(x)\ln\frac{q(x)}{p(x)}\) (합은 \(p(x) > 0\)인 \(x\)).
- \(\ln t \le t - 1\): \(\ln\)은 오목하고 \(t = 1\)에서의 접선이 \(t - 1\)이라 늘 그 아래다(볼록성의 접선 부등식). 등호는 \(t = 1\)일 때만.
- 대입: \(\sum_x p(x)\ln\frac{q(x)}{p(x)} \le \sum_x p(x)\left(\frac{q(x)}{p(x)} - 1\right) = \sum_x q(x) - 1 \le 0\).
- 결론: \(D(p\Vert q) \ge 0\). 등호는 모든 \(x\)에서 \(q(x) = p(x)\)일 때다. ∎
거리가 아니다. \(p = (0.9, 0.1)\), \(q = (0.5, 0.5)\)이면 \(D(p\Vert q) \approx 0.531\), \(D(q\Vert p) \approx 0.737\)비트로 다르다. 삼각부등식도 맞지 않는다. 그래서 “거리”가 아니라 “발산”이라 부른다.
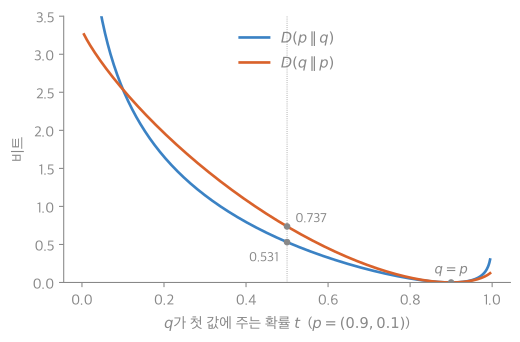
\(p = (0.9, 0.1)\)을 고정하고 \(q = (t, 1 - t)\)를 움직였다. 두 곡선은 \(t = 0.9\), 곧 \(q = p\)일 때만 함께 0이 되고, 다른 곳에서는 값이 다르다. \(t\)가 0이나 1로 가면 \(D(p \Vert q)\)만 끝없이 커진다. 실제로 일어나는 값에 \(q\)가 확률을 거의 주지 않기 때문이다3.
예제
분류 모델의 손실. 모델이 입력마다 정답 부류의 확률 \(q_\theta(y_i \mid \mathbf{x}_i)\)를 내놓는다. 자료 \(n\)개의 평균 교차 엔트로피 손실(자연로그)은
\[\mathcal{L}(\theta) = -\frac1n\sum_{i=1}^{n}\ln q_\theta(y_i \mid \mathbf{x}_i).\]- 정답 분포: 자료 \(i\)의 정답 분포는 정답 부류에 1, 나머지에 0(원-핫)이라, 교차 엔트로피가 \(-\ln q_\theta(\text{정답})\) 한 항만 남는다.
- 손실의 크기: 정답에 0.9를 주면 손실 \(-\ln 0.9 \approx 0.105\), 0.1을 주면 \(-\ln 0.1 \approx 2.303\)이다. 확신하고 틀리면 크게 벌받는다.
- 최대가능도와 같음: \(\mathcal{L}\)은 음의 로그 가능도를 \(n\)으로 나눈 것이라, \(\mathcal{L}\) 최소화 = 가능도 최대화다.
- 확인: 가장 단순한 모델(모든 입력에 같은 확률 \(t\)로 “1”이라 예측)에서 손실을 최소로 하는 \(t\)는 자료 속 1의 비율과 정확히 같다(자료 1,000개, 격자 탐색). 베르누이 MLE \(\frac kn\) 그대로다.
활용
- 분류 모델의 손실 함수. 로지스틱 회귀와 신경망 분류기는 교차 엔트로피를 최소화한다. 소프트맥스와 함께 쓰면 기울기가 “예측 확률 − 정답”으로 간단해진다(행렬 미분의 로지스틱 회귀 기울기)4.
- 분포 맞추기와 생성 모델. 모델 분포 \(q\)를 데이터 분포 \(p\)에 가깝게 하는 것을 \(D(p\Vert q)\) 최소화로 쓴다. 변분 오토인코더는 KL 항을 손실에 넣는다.
- 흔한 실수. 예측 확률에 정확히 0을 두어 손실이 무한대가 되는 것. 구현에서는 확률을 아주 작은 값으로 자르거나 로그-소프트맥스로 계산한다.
연결
과목별 관점
데이터 과학 (3-2학기). 두 확률분포가 얼마나 다른지 재는 척도로 소개한다. \(p(x)\)는 데이터의 “참” 분포, \(q(x)\)는 학습시키려는 모델이고, \(D_{KL}(p \Vert q) = \sum_x p(x)\ln\frac{p(x)}{q(x)}\)는 \(q\)로 \(p\)를 흉내 낼 때 잃는 정보다. 0 이상이고 \(p = q\)일 때만 0이지만, \(D_{KL}(p\Vert q) \ne D_{KL}(q\Vert p)\)라 거리(distance)가 아니다. 데이터 과학에서는 같은 “비슷함 재기” 단원에서 민코프스키 거리, 코사인 유사도와 함께 다룬다. 거리는 대칭과 삼각부등식을 지켜야 하는데 KL 발산은 대칭부터 깨진다.
확인 문제
C1 실제 분포 \(p = \left(\frac12, \frac14, \frac18, \frac18\right)\)을 균등분포 \(q\)에 맞춘 부호(기호마다 2비트)로 보낼 때 교차 엔트로피와 KL 발산은?
답: \(H(p, q) = 2\)비트, \(H(p) = 1.75\)비트라 \(D(p\Vert q) = 0.25\)비트. 기호마다 평균 0.25비트를 낭비한다.
C2 분류 모델에서 평균 교차 엔트로피를 최소화하는 것이 최대가능도 추정과 같은 이유는?
답: 정답 분포가 원-핫이라 자료 하나의 교차 엔트로피는 \(-\ln q_\theta(\text{정답})\)이다. 이를 평균 낸 것은 로그 가능도 \(\sum\ln q_\theta(y_i \mid \mathbf{x}_i)\)에 \(-\frac1n\)을 곱한 것이라, 최소화와 최대화가 같은 \(\theta\)를 준다.
C3 KL 발산이 대칭이 아님을 보이는 예를 계산하라. 무한대가 되는 경우도 들어라.
답: \(p = (0.9, 0.1)\), \(q = (0.5, 0.5)\)면 \(D(p\Vert q) \approx 0.531\), \(D(q\Vert p) \approx 0.737\)비트. \(p = (0.5, 0.5)\), \(q = (1, 0)\)이면 \(p\)가 둘째 값에 확률을 주는데 \(q\)는 0이라 \(D(p\Vert q) = \infty\)다(반대 방향 \(D(q\Vert p) = 1\)비트는 유한).
-
Cover, Thomas, Elements of Information Theory 2판, 2장(상대 엔트로피의 정의, 정보 부등식 \(D(p\Vert q) \ge 0\), 틀린 분포로 부호화할 때의 추가 길이). ↩
-
이 문서 예시(2비트, 1.75비트, 0.25비트)와 정의의 관계식 \(D(p\Vert q) = H(p, q) - H(p)\)를 그렸다. ↩
-
38_cross-entropy-kl_plot.py로 그렸고, 그림에 쓴 값(\(t = 0.5\)에서 0.531과 0.737, \(D(p \Vert p) = 0\), 예시의 KL 0.25)을 같은 코드로 확인했다. ↩
-
Goodfellow, Bengio, Courville, Deep Learning, 3.13절(KL 발산과 교차 엔트로피), 5.5절(최대가능도와 교차 엔트로피의 관계). ↩