키를 cm로 적느냐 m로 적느냐에 따라 거리 계산 결과가 뒤집힌다. 정규화는 속성마다 값을 같은 크기의 범위로 옮겨서 단위의 영향을 없앤다. 가장 작은 값을 0, 가장 큰 값을 1로 맞추는 방법은 간단하지만, 튀는 값 하나가 나머지를 한쪽 구석에 몰아넣는다. 평균을 0, 표준편차를 1로 맞추는 방법은 튀는 값에 덜 흔들리지만, 분포의 모양까지 바꿔 주지는 않는다.
예시로 보기
민코프스키 거리로 사람들의 비슷함을 재면, 값이 큰 속성이 거리를 독차지한다. 같은 사람들의 키와 몸무게도 (cm, g), (cm, kg), (m, kg) 가운데 어느 단위로 적느냐에 따라 그래프 위에서 전혀 다른 기울기로 보인다.
세 사람의 (나이, 연봉 만원)이 A(25, 3000), B(26, 5000), C(60, 3100)이다. 그대로 거리를 재면 연봉 차이가 거리를 정해서, 나이가 35살 많은 C가 A와 가장 가깝다. 나이 범위를 20~60, 연봉 범위를 2,000~10,000으로 보고 0~1로 옮기면 A(0.125, 0.125), B(0.15, 0.375), C(1, 0.1375)다. 이제 A와 B의 거리 0.25, A와 C의 거리 0.88로 B가 가깝다1.
정의
최소-최대 정규화는 값에서 최솟값을 빼고(최솟값에서 얼마나 떨어졌나), 실제 값의 범위로 나눈다. 결과는 0~1 사이다.
\[x_{\text{scaled}} = \frac{x - x_{\min}}{x_{\max} - x_{\min}}\]예: 소득 범위가 12,000~98,000일 때 73,600은 \(\frac{61{,}600}{86{,}000} \approx 0.716\)이다2.
한계는 둘이다.
- 실제 최솟값·최댓값을 모르면 쓸 수 없다. 나중에 범위 밖의 값이 들어오면 0~1을 벗어난다.
- 최솟값과 최댓값이 이상치이면 결과가 크게 흔들린다.
z-점수 정규화(평균 0 정규화)는 속성 \(A\)의 값 \(v_i\)에서 평균 \(\bar A\)를 빼고 표준편차 \(\sigma_A\)로 나눈다.
\[v'_i = \frac{v_i - \bar A}{\sigma_A}\]결과는 “평균에서 표준편차 몇 개만큼 떨어졌나”다. 바꾼 값들은 평균 0, 표준편차 1이 된다. 실제 최솟값·최댓값을 모르거나 이상치가 있을 때 쓸모 있다. 예: 평균 54,000, 표준편차 16,000이면 73,600은 \(\frac{19{,}600}{16{,}000} = 1.225\)다2.
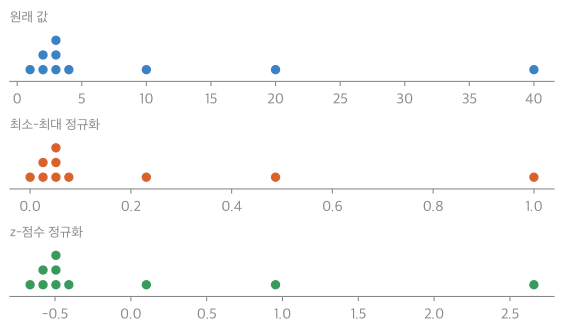
꼬리가 긴 자료 10개를 두 방법으로 바꿨다. 눈금 숫자만 바뀌고 점들의 배치는 세 줄 모두 똑같다. 두 방법 모두 모든 값에서 같은 수를 빼고 같은 수로 나누기 때문이다3.
연결
자주 하는 오해
아니다. z-점수는 모든 값에서 같은 수를 빼고 같은 수로 나누는 직선 변환이라, 위치와 폭만 바꾸고 모양은 그대로 둔다. 오른쪽으로 꼬리가 긴 자료는 정규화 뒤에도 꼬리가 길다. 정규화 전후를 종 모양 두 개로 나란히 그린 그림을 자주 보기 때문에 그렇게 믿기 쉽다. 확인하는 법: 치우친 자료의 왜도(치우침을 재는 값)를 정규화 전후로 계산하면 같다(검증 코드에서 1.85 그대로).
과목별 관점
자료와 정보 (2-1학기). 정규화를 “속성이 여럿인 자료에서 속성끼리 크기를 맞추는 법”으로 소개하고, 우리말로는 모두 ‘정규화’로 옮기기 쉬운 영어 낱말 셋을 가른다.
| 낱말 | 무엇을 다루나 | 하는 일 | 이 문서에서 |
|---|---|---|---|
| Normalization | 자료 | 값의 범위를 0~1로 옮긴다 | 최소-최대 정규화 |
| Standardization | 확률 분포 | 평균 0, 분산 1이 되게 값을 바꾼다 | z-점수 정규화 |
| Regularization | 머신 러닝 | 모델이 가진 자료에만 지나치게 맞춰지는 일(과적합)을 막으려고 벌점을 매긴다 | 다루지 않는다 |
standardization을 “자료를 정규분포의 확률변수로 보고” 하는 일이라고 설명하기도 한다. 식 \(z = \frac{x - \mu}{\sigma}\)는 자료가 어떤 분포든 쓸 수 있고, 바꾼 값의 평균은 0, 표준편차는 1이 된다. 바꾼 값이 표준정규분포를 따르려면 원래 자료가 정규분포여야 한다. 위 오해 항목과 같은 이야기다4. 표준정규분포는 정규분포에 있다.
확인 문제
C1 값 \(20, 30, 50, 100\)을 최소-최대 정규화하라. 여기에 1,000이 하나 더 들어오면 50은 얼마가 되는가?
답: 범위 20~100이라 \(0, 0.125, 0.375, 1\). 1,000이 들어오면 범위가 20~1,000이 되어 50은 \(\frac{30}{980} \approx 0.031\)이다. 이상치 하나가 나머지를 0 근처로 몰아넣는다1.
C2 다음 상황에서 최소-최대와 z-점수 중 무엇이 알맞은가? ① 픽셀 밝기 0~255를 0~1로 ② 앞으로 들어올 센서 값의 범위를 모른다 ③ 연봉 자료에 수십억 원 연봉이 몇 개 섞였다
답: ① 최소-최대. 범위가 정해져 있다. ② z-점수. 실제 최솟값·최댓값을 몰라도 된다. ③ z-점수가 최소-최대보다 덜 흔들린다. (평균과 표준편차도 이상치에 영향을 받으므로, 더 견고하게 하려면 중앙값과 IQR로 나누는 방법을 쓴다1.)
C3 세 사람 A(25세, 3,000만 원), B(26세, 5,000만 원), C(60세, 3,100만 원)에서 A와 가장 가까운 사람이 정규화 전후로 바뀌는 이유를 설명하라.
답: 정규화 전에는 연봉 차이(수천)가 나이 차이(수십)보다 훨씬 커서 연봉이 비슷한 C가 가깝다. 정규화하면 두 속성이 같은 0~1 범위에서 겨루므로, 나이 차이 35살이 크게 반영되어 B가 가까워진다(0.25 < 0.88).
C4 다음은 각각 normalization, standardization, regularization 가운데 무엇인가? ① 시험 점수에서 평균을 빼고 표준편차로 나눈다 ② 예측 모델이 훈련 자료에만 지나치게 맞지 않도록, 모델이 복잡해질수록 벌점을 준다 ③ 센서 값 0~1,023을 0~1로 옮긴다
답: ① standardization ② regularization ③ normalization.
이유: ①과 ③은 자료의 값을 바꾼다. ①은 평균 0, 분산 1로, ③은 범위 0~1로 맞춘다. ②는 자료를 건드리지 않고 모델을 배우는 방법을 바꾼다. 셋 다 ‘정규화’로 옮기는 일이 있어 낱말만 보고는 가를 수 없다4.