같은 훈련 자료에서 복원 추출로 조금씩 다른 자료 여러 벌을 만들고, 벌마다 모델을 따로 훈련해 예측을 투표나 평균으로 모은다. 자료가 조금씩 달라 모델들도 조금씩 달라지고, 그 차이가 평균으로 상쇄되어 흔들림(분산)이 준다. 랜덤 포레스트는 결정 트리로 배깅을 하면서 나무마다 쓸 속성까지 무작위로 골라, 나무들을 더 서로 다르게 만든다. 다만 모델들이 공통으로 틀리는 부분(편향)은 줄지 않는다.
예시로 보기
앙상블은 모델들이 서로 다를수록 효과가 크다. 그런데 자료가 한 벌뿐이면 어떻게 서로 다른 모델을 만들까?
자료 40개에서 복원 추출로 40개를 뽑아 한 벌을 만든다. 어떤 자료는 두세 번, 어떤 자료는 한 번도 안 뽑힌다. 한 벌에는 서로 다른 원래 자료가 평균 약 63.7%만 들어 있다. 이렇게 50벌을 만들어 벌마다 “가장 가까운 이웃 하나의 값을 그대로 답하는” 모델(분산이 큰 모델)을 만들고 예측을 평균 냈다1.
| 모델 하나 | 배깅 (50개 평균) | |
|---|---|---|
| 예측의 분산 | 0.089 | 0.043 |
| 편향² | 0.0003 | 0.0004 |
분산은 절반으로 줄고 편향은 그대로다.
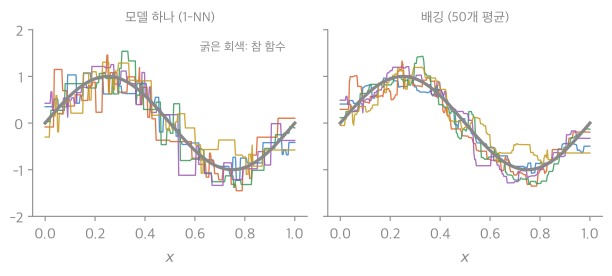
같은 참 함수(굵은 회색)에서 훈련 자료를 다섯 번 새로 뽑아 모델을 만들었다. 왼쪽 1-NN 예측은 자료마다 들쭉날쭉 크게 다르다. 오른쪽 배깅 예측은 다섯 선이 서로 더 가깝게 붙는다2.
정의
배깅(Bootstrap Aggregating)은 부트스트랩 표본으로 여러 모델을 훈련한다.
배깅(훈련 자료 D, 모델 수 k):
    for i = 1..k:
        D_i ← D에서 복원 추출로 |D|개를 뽑은 부트스트랩 표본
        M_i ← D_i로 훈련한 모델
    새 점 x의 예측: 분류면 M_1(x), ..., M_k(x)의 다수결, 회귀면 평균
복원 추출이 자료 벌들을 서로 다르게 만든다. 각 모델의 편향과 분산은 비슷하고, 모아서 분산이 준다.
flowchart LR
    D["훈련 자료 D"] --> D1["표본 D1"]
    D --> D2["표본 D2"]
    D --> Dk["표본 Dk"]
    D1 --> M1["모델 M1"]
    D2 --> M2["모델 M2"]
    Dk --> Mk["모델 Mk"]
    M1 --> V["다수결 또는 평균"]
    M2 --> V
    Mk --> V
    V --> P["최종 예측"]
세 줄은 서로 이어지지 않는다. 표본도 모델도 서로를 보지 않고 따로 만들어지고, 맨 끝에서만 한데 모인다.
랜덤 포레스트는 분산이 큰 결정 트리에 쓰는 배깅이다.
- 자료 뽑기: 훈련 자료에서 복원 추출로 훈련 자료 \(k\)벌을 만든다.
- 속성 뽑기: 나무마다(보통은 마디마다) 속성 \(n\)개 중 \(m\)개만 무작위로 골라 쓴다.
- 다수결: 나무들의 예측을 투표로 모은다.
속성 뽑기는 나무들 사이의 상관을 낮춘다. 아주 강한 속성 하나가 있으면 모든 나무가 맨 위에서 그 속성으로 갈라 비슷해지는데, 그 속성을 못 쓰는 나무가 생기기 때문이다. 앙상블의 분산 공식에서 \(\rho\)가 줄면 분산이 준다1.
복잡도
모델 \(k\)개를 따로 훈련하므로 훈련 시간은 모델 하나의 약 \(k\)배다. 모델끼리 기다릴 필요가 없어 동시에(병렬로) 훈련할 수 있다1.
활용
- 사이킷런의
BaggingClassifier,RandomForestClassifier(max_features가 \(m\))가 이 방법이다1. - 한 번도 안 뽑힌 자료(OOB, 약 36.8%)로 그 모델을 평가하면 따로 시험 집합을 떼지 않아도 된다1.
- 편향이 큰 모델(아주 얕은 나무, 직선 모델)에는 효과가 작다. 줄일 분산이 적기 때문이다.
연결
- 선수: 앙상블 학습, 표본 추출(복원 추출)
- 차례로 실수를 고치는 다른 앙상블: 부스팅과 AdaBoost
- 비교: 배깅과 부스팅 비교
확인 문제
C1 배깅의 세 단계를 쓰고, 랜덤 포레스트가 배깅에 더하는 것을 말하라.
답: ① 복원 추출로 부트스트랩 표본 여러 벌을 만든다 ② 벌마다 모델을 훈련한다 ③ 투표나 평균으로 모은다. 랜덤 포레스트는 결정 트리를 쓰고, 나무마다 속성 \(n\)개 중 \(m\)개만 무작위로 골라 쓴다.
C2 랜덤 포레스트에서 속성을 무작위로 고르면 각 나무는 조금 약해지는데, 숲 전체는 오히려 좋아질 수 있는 이유를 앙상블의 분산 공식으로 설명하라.
답: 분산 \(\frac{\sigma^2}{k} + \frac{k-1}{k}\rho\sigma^2\)에서 \(k\)가 크면 \(\rho\sigma^2\)가 남는다. 속성을 무작위로 고르면 나무들이 같은 강한 속성에 의존하지 않아 \(\rho\)가 준다. 나무 하나의 \(\sigma^2\)가 조금 늘어도 \(\rho\)가 충분히 줄면 전체 분산이 준다.
C3 의사코드의 D_i ← D에서 복원 추출로 |D|개를 뽑은 부트스트랩 표본 줄이 하는 일을 한 문장으로 쓰라.
답: 원래 자료와 크기는 같지만 일부가 겹치고 일부가 빠진, 조금씩 다른 훈련 자료를 만들어 모델들이 서로 달라지게 한다.