성별과 좋아하는 책 장르처럼 이름표로 된 두 속성이 서로 관련 있는지 잰다. 두 속성이 아무 관련이 없다면 칸마다 몇 명이 나올지 미리 계산할 수 있다. 실제로 센 수가 그 예상에서 많이 벗어날수록 값이 커지고, 크면 “관련이 있다”고 판단한다. 다만 관련의 방향이나 원인은 알려 주지 않고, 칸의 예상 인원이 너무 적으면 믿기 어렵다.
예시로 보기
숫자 속성이면 공분산으로 “함께 오르내리는가”를 잰다. 그런데 성별이나 장르는 오르내릴 숫자가 없다. 그래서 “몇 명씩 섞여 있는가”를 센다.
1,500명에게 성별과 좋아하는 책을 물었다.
| 남 | 여 | 합 | |
|---|---|---|---|
| 소설 | 250 (90) | 200 (360) | 450 |
| 비소설 | 50 (210) | 1000 (840) | 1050 |
| 합 | 300 | 1200 | 1500 |
이렇게 두 속성의 값마다 센 표를 분할표라 부른다. 괄호 안은 “성별과 장르가 관련 없다면 나올 인원”이다. 전체의 \(\frac{300}{1500} = 20\%\)가 남자이고 \(\frac{450}{1500} = 30\%\)가 소설을 좋아하니, 관련이 없다면 남자이면서 소설을 좋아하는 사람은 \(1500 \times 0.2 \times 0.3 = 90\)명이어야 한다. 실제로는 250명이다. 차이가 크다.
칸마다 (실제 − 예상)²을 예상으로 나눠 더한다.
\[\chi^2 = \frac{(250 - 90)^2}{90} + \frac{(50 - 210)^2}{210} + \frac{(200 - 360)^2}{360} + \frac{(1000 - 840)^2}{840} = 284.44 + 121.90 + 71.11 + 30.48 = 507.93\]값이 아주 커서 성별과 장르는 관련이 있다고 본다.
정의
명목 속성 \(A\)가 \(c\)가지 값 \(a_1, \dots, a_c\)를, \(B\)가 \(r\)가지 값 \(b_1, \dots, b_r\)을 가진다. 자료 \(n\)개를 두 값의 짝마다 세어 분할표를 만든다.
칸 \((i, j)\)의 기대 빈도는 “\(A = a_i\)인 개수 × \(B = b_j\)인 개수 ÷ 전체 개수”다. 두 속성이 독립이면 나올 개수다.
\[e_{ij} = \frac{\operatorname{count}(A = a_i) \times \operatorname{count}(B = b_j)}{n}\]\(o_{ij}\)(칸 \((i, j)\)에서 실제로 센 개수)와 비교해 모든 칸을 더한다.
\[\chi^2 = \sum_{i=1}^{c}\sum_{j=1}^{r}\frac{(o_{ij} - e_{ij})^2}{e_{ij}}\]\(\chi^2\)이 클수록 독립이라는 가정에서 멀다. 얼마나 커야 “관련 있다”고 할지는 자유도 \((r - 1)(c - 1)\)인 카이제곱 분포의 임계값과 비교해 정한다1. 위 예는 자유도가 \((2 - 1)(2 - 1) = 1\)이고, 유의수준 0.001의 임계값이 10.828이라 507.93은 훨씬 크다. 이 비교는 가설검정의 한 경우다.
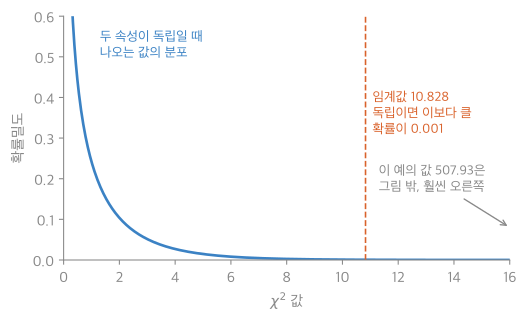
두 속성이 정말 관련 없다면 \(\chi^2\) 값은 대부분 0~4 근처에 머문다. 10.828보다 클 확률은 0.001뿐이고, 이 예의 507.93은 그보다 훨씬 오른쪽에 있다2.
활용
- 중복 속성 찾기. 데이터를 합칠 때, 한 명목 속성이 다른 명목 속성을 거의 결정하면 중복일 수 있다. 데이터 통합에서 숫자 속성에는 상관계수를, 명목 속성에는 \(\chi^2\)을 쓴다.
- 흔한 실수: \(\chi^2\)의 크기로 관련의 세기를 비교하는 것. \(\chi^2\)은 자료 수에 비례해 커진다. 표 전체를 3배 하면 \(\chi^2\)도 3배가 된다1.
- 기대 빈도가 너무 작은 칸(보통 5 미만)이 많으면 카이제곱 분포 근사가 맞지 않는다1.
연결
확인 문제
C1 분할표의 기대 빈도 \(e_{ij}\)를 구하는 식을 쓰고, 그것이 무엇을 가정한 개수인지 말하라.
답: \(e_{ij} = \frac{(\text{행 } i \text{ 합}) \times (\text{열 } j \text{ 합})}{n}\). 두 속성이 독립이라고 가정할 때 그 칸에 나올 개수다. 독립이면 \(P(a_i, b_j) = P(a_i)P(b_j)\)이므로 \(n \cdot \frac{\text{행 합}}{n} \cdot \frac{\text{열 합}}{n}\)이다.
C2 2×2 분할표 \(\begin{pmatrix} 30 & 20 \\ 20 & 30 \end{pmatrix}\)의 \(\chi^2\)을 구하라.
답: 행 합과 열 합이 모두 50, \(n = 100\)이라 모든 칸의 기대 빈도는 25다. \(\chi^2 = 4 \times \frac{5^2}{25} = 4\)1.
C3 설문 인원을 10배로 늘렸더니 칸의 비율은 같은데 \(\chi^2\)이 10배가 되었다. 관련이 10배 강해진 것인가?
답: 아니다. 비율이 같으니 관련의 세기는 같다. \(\chi^2\)은 \((o - e)^2 / e\)의 합이라 모든 개수가 \(k\)배면 \(k^2 / k = k\)배가 된다. 자료가 많아져 “우연이 아니다”라는 확신이 커졌을 뿐이다. 세기를 비교하려면 \(n\)으로 나눠 크기를 맞춘 지표를 쓴다. 예: 크라메르 V \(= \sqrt{\chi^2 / (n(\min(r, c) - 1))}\)1.