변수가 여럿이면 각자의 흩어짐과 둘씩의 공분산을 한 행렬에 모은다. 다변량 정규분포는 평균 벡터와 이 공분산 행렬만으로 정해지는 여러 차원의 종 모양이다. 밀도가 같은 점들은 타원을 그리는데, 타원의 축 방향과 길이가 공분산 행렬의 고유벡터와 고윳값에서 나온다. 한 변수가 다른 변수들의 일차 결합이라 공분산 행렬이 뒤집히지 않으면 밀도 식을 그대로 쓸 수 없다.
예시로 보기
두 센서의 오차 \((X_1, X_2)\)가 평균 \((1, -2)\), 공분산 행렬
\[\Sigma = \begin{pmatrix}4 & 2\\ 2 & 3\end{pmatrix}\]인 다변량 정규분포를 따른다. 대각선 4와 3은 각자의 분산, 2는 둘의 공분산이다(상관계수 \(\frac{2}{2\sqrt3} \approx 0.58\)). 표본을 20만 개 뽑아 찍으면 점들이 오른쪽 위로 기운 타원 모양 구름을 이룬다. 타원의 긴 축은 \(\Sigma\)의 큰 고윳값 \(\frac{7 + \sqrt{17}}{2} \approx 5.56\)의 고유벡터 방향, 짧은 축은 작은 고윳값 \(\approx 1.44\)의 방향이다.
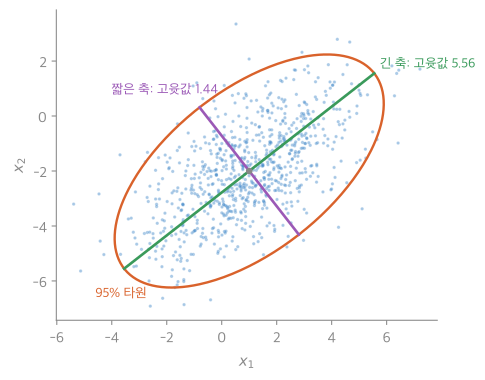
점은 이 분포에서 뽑은 표본 800개다. 주황 타원 안에 약 95%가 들어가고, 초록과 보라 선분이 타원의 긴 축과 짧은 축이다. 두 축의 길이 비는 \(\sqrt{5.56 / 1.44} \approx 2\)다1.
정의
확률벡터 \(\mathbf{X} = (X_1, \dots, X_n)^\top\)(\(^\top\)는 행과 열을 바꾸는 전치)의 공분산 행렬은 \(\Sigma = \mathbb{E}\big[(\mathbf{X} - \boldsymbol\mu)(\mathbf{X} - \boldsymbol\mu)^\top\big]\), 곧 \(\Sigma_{ij} = \operatorname{Cov}(X_i, X_j)\)다. \(\Sigma\)가 양의 정부호일 때 다변량 정규분포 \(\mathcal{N}(\boldsymbol\mu, \Sigma)\)의 밀도는
\[f(\mathbf{x}) = \frac{1}{(2\pi)^{n/2}\sqrt{\det\Sigma}}\exp\left(-\frac12(\mathbf{x} - \boldsymbol\mu)^\top\Sigma^{-1}(\mathbf{x} - \boldsymbol\mu)\right)\]이다2.
성질.
- \(\Sigma\)는 대칭이고 양의 준정부호다. 어떤 방향 \(\mathbf{v}\)로 쏜 값 \(\mathbf{v}^\top\mathbf{X}\)의 분산이 \(\mathbf{v}^\top\Sigma\mathbf{v}\)이고, 분산은 음수일 수 없기 때문이다.
- 일차 변환: \(\operatorname{Cov}(A\mathbf{X} + \mathbf{b}) = A\Sigma A^\top\). 다변량 정규의 일차 변환은 다시 다변량 정규다.
- 결합 정규일 때는 공분산 0이 곧 독립이다. \(\Sigma\)가 대각이면 지수 안의 이차형식이 변수별 합으로 갈라져 밀도가 곱이 된다.
지수 안의 \((\mathbf{x} - \boldsymbol\mu)^\top\Sigma^{-1}(\mathbf{x} - \boldsymbol\mu)\)를 마할라노비스 거리의 제곱이라 한다. 방향마다의 흩어짐으로 나눠 잰 거리라, 이 값이 같은 점들이 밀도가 같은 타원을 이룬다. 2차원에서 이 값이 \(c\) 이하일 확률은 \(1 - e^{-c/2}\)라, \(c = 5.991\)인 타원에 95%가 들어간다.
예제
상관된 표본 만들기. 표준정규 난수는 서로 독립인 것만 쉽게 만들 수 있다. 예시의 \(\Sigma\)를 따르는 표본은?
- 분해: \(\Sigma = LL^\top\)인 아래삼각 \(L\)을 구한다(숄레스키 분해). \(L = \begin{pmatrix}2 & 0\\ 1 & \sqrt2\end{pmatrix}\).
- 변환: 독립 표준정규 \(\mathbf{Z} = (Z_1, Z_2)\)로 \(\mathbf{X} = \boldsymbol\mu + L\mathbf{Z}\).
- 확인: 성질 2로 \(\operatorname{Cov}(\mathbf{X}) = L I L^\top = \Sigma\). 20만 개 표본의 공분산이 \(\Sigma\)와 0.05 이내로 맞는다.
고윳값 분해 \(\Sigma = Q\Lambda Q^\top\)에서 \(L = Q\Lambda^{1/2}\)을 써도 된다. 이쪽은 “축마다 \(\sqrt{\lambda_i}\)로 늘린 뒤 회전한다”는 타원 그림과 바로 맞는다.
활용
- 이상 탐지. 정상 데이터의 평균과 공분산을 구하고, 마할라노비스 거리가 큰 점을 이상치로 본다. 변수끼리 상관이 있어도 방향마다 알맞게 잰다.
- 칼만 필터와 가우스 과정. 상태의 불확실성을 평균 벡터와 공분산 행렬로 들고 다니며, 일차 변환(성질 2)과 조건부 분포로 갱신한다.
- 차원 축소. 공분산 행렬의 고유벡터가 데이터가 가장 퍼진 방향이다. 이것이 주성분 분석이다.
- 흔한 실수. 각 변수가 정규분포이면 함께도 다변량 정규라고 여기는 것. \(X \sim \mathcal{N}(0, 1)\)과 무작위 부호 \(S = \pm1\)로 만든 \(Y = SX\)는 둘 다 표준정규이고 공분산도 0이지만 \(\vert Y\vert = \vert X\vert\)라 독립이 아니다. 결합이 정규일 때만 성질 3이 맞는다.
연결
과목별 관점
자료와 정보 (2-1학기). 센서 여러 개로 잰 자료처럼 속성이 여럿인 자료를 평균 벡터와 공분산 행렬 두 가지로 줄여 적는 모델로 쓴다. 공분산 행렬의 수가 바뀌면 종 모양이 어떻게 달라지는지를 주로 그림으로 본다.
-
표기. 자료를 \(N\)행 \(d\)열의 표 \(\mathbf X\)로 적는다. 한 줄이 관측 하나, 한 칸이 속성 하나이고, \(x_j^{(i)}\)는 \(i\)번째 관측의 \(j\)번째 속성이다. 차원은 \(d\)(\(D\)로 쓰기도 한다), 밀도는 \(p(\mathbf x)\)로 쓴다. 이 문서의 \(n\), \(f(\mathbf x)\)와 같다. 상관계수는 공분산을 두 표준편차의 곱으로 나눈 \(\rho_{ij} = \frac{\sigma_{ij}}{\sigma_i\sigma_j}\)로 적는다. 2차원이면 \(\boldsymbol\mu = \begin{pmatrix}\mu_X\\ \mu_Y\end{pmatrix}\), \(\Sigma = \begin{pmatrix}\sigma_X^2 & \rho\sigma_X\sigma_Y\\ \rho\sigma_X\sigma_Y & \sigma_Y^2\end{pmatrix}\)이다.
공분산 행렬의 식에서는 곱하는 순서를 조심한다. \(\mathbf x\)를 세운 벡터(열벡터)로 두면 \((\mathbf x - \boldsymbol\mu)(\mathbf x - \boldsymbol\mu)^\top\)이 \(d \times d\) 행렬이다. 순서를 바꾼 \((\mathbf x - \boldsymbol\mu)^\top(\mathbf x - \boldsymbol\mu)\)는 수 하나다. 그 평균은 속성마다의 분산을 모두 더한 값이라, 이 문서 예시의 \(\Sigma\)에서는 \(4 + 3 = 7\)이다. 자료 한 줄을 눕힌 벡터(행벡터)로 두면 순서가 거꾸로 된다. 밀도 식의 지수 안에 있는 \(\frac12\)도 빠뜨리기 쉽다. 빠뜨리면 넓이가 1이 아니다. \(d = 2\), \(\Sigma = I\)에서는 넓이가 0.5가 된다3.
- 키와 몸무게. 키의 평균 \(\mu_x\)와 몸무게의 평균 \(\mu_y\)를 묶은 \((\mu_x, \mu_y)\)가 2차원 자료의 대표값이다. 18~24세 남자의 키와 몸무게를 찍어 보면 상관계수가 0.42이고, 점 구름이 오른쪽 위로 비스듬한 타원 모양이다.
-
공분산 행렬에 따른 모양. 공분산 행렬을 바꾸면 밀도가 같은 점을 이은 선이 이렇게 바뀐다.
바꾼 것 밀도가 같은 점을 이은 선 \(\Sigma = I\), \(0.5\,I\), \(2\,I\) 모두 원이다. \(0.5\,I\)면 원이 작아지고 봉우리가 높아진다. \(2\,I\)면 원이 커지고 봉우리가 낮아진다 두 분산이 같다, \(x_1\) 쪽이 크다, \(x_2\) 쪽이 크다 원, 가로로 긴 타원, 세로로 긴 타원 공분산 0, 0.5, 0.8(분산은 둘 다 1) 원에서 시작해 오른쪽 위로 기운 타원이 점점 가늘어진다 공분산이 0, 양수, 음수 원, 오른쪽 위로 기운 타원, 오른쪽 아래로 기운 타원 수로 확인하면 봉우리 높이는 \(\Sigma = I\)에서 0.159, \(0.5\,I\)에서 0.318, \(2\,I\)에서 0.080이다. 공분산이 0.5면 타원의 긴 축이 짧은 축의 약 1.73배, 0.8이면 3배다4.
- 마할라노비스 거리. \((\mathbf x - \boldsymbol\mu_k)^\top\Sigma^{-1}(\mathbf x - \boldsymbol\mu_k)\)를 그대로 거리라고 부르기도 한다. 속성마다 다른 분산과 속성끼리의 상관을 고르게 맞춰 잰 거리라는 뜻이다. 위 정의에서 말한 대로 엄밀히는 이 값이 거리의 제곱이다. 자세한 것은 마할라노비스 거리에 있다.
확인 문제
C1 공분산 행렬이 \(\begin{pmatrix}4 & 2\\ 2 & 3\end{pmatrix}\)일 때 \(\operatorname{Var}[X_1 + X_2]\)는?
답: \(A = (1\ 1)\)이라 \(A\Sigma A^\top = 4 + 3 + 2 \times 2 = 11\).
C2 공분산 행렬이 늘 양의 준정부호인 이유를 설명하라.
답: 어떤 벡터 \(\mathbf{v}\)에 대해서도 \(\mathbf{v}^\top\Sigma\mathbf{v} = \operatorname{Var}[\mathbf{v}^\top\mathbf{X}]\)이고, 분산은 제곱의 평균이라 음수가 될 수 없다.
C3 독립 표준정규 난수만 만들 수 있을 때, 공분산이 \(\Sigma = \begin{pmatrix}4 & 2\\ 2 & 3\end{pmatrix}\)인 2차원 정규 표본을 만드는 절차를 식으로 쓰라.
답: \(\Sigma = LL^\top\), \(L = \begin{pmatrix}2 & 0\\ 1 & \sqrt2\end{pmatrix}\)로 분해하고 \(\mathbf{X} = \boldsymbol\mu + L\mathbf{Z}\). 곧 \(X_1 = \mu_1 + 2Z_1\), \(X_2 = \mu_2 + Z_1 + \sqrt2 Z_2\). 검산: \(\operatorname{Var}[X_2] = 1 + 2 = 3\), \(\operatorname{Cov} = 2 \cdot 1 = 2\).
C4 평균이 \((0, 0)\)인 2차원 정규분포에서 공분산 행렬이 (가) \(0.5\,I\) (나) \(\begin{pmatrix}1 & 0.8\\ 0.8 & 1\end{pmatrix}\) (다) \(\begin{pmatrix}1 & -0.8\\ -0.8 & 1\end{pmatrix}\)일 때, 밀도가 같은 점을 이은 선의 모양을 각각 말하라. (나)에서 긴 축은 짧은 축의 몇 배인가?
답: (가) 원이다. \(\Sigma = I\)일 때보다 작고 봉우리는 두 배 높다. (나) 오른쪽 위로 기운 가는 타원이다. 긴 축이 짧은 축의 3배다. (다) 같은 타원이 오른쪽 아래로 기운다.
이유: 타원의 축 길이는 고윳값의 제곱근에 비례한다. (나)와 (다)의 고윳값은 \(1 + 0.8 = 1.8\)과 \(1 - 0.8 = 0.2\)라서 비가 \(\sqrt{1.8 / 0.2} = 3\)이다. 공분산이 양수면 두 값이 함께 커지는 방향 \((1, 1)\)이 긴 축이고, 음수면 한쪽이 커질 때 다른 쪽이 작아지는 방향 \((1, -1)\)이 긴 축이다. (가)는 두 방향의 분산이 같아 원이고, 분산이 절반이라 좁게 모인다4.
-
19_multivariate-normal_plot.py로 그렸고, 그림에 쓴 값(고윳값 \(\frac{7 \pm \sqrt{17}}{2}\), 숄레스키 인수 \(L\), 타원 안 비율 95%(±1.5%p))을 같은 코드로 확인했다. ↩
-
Blitzstein, Hwang, Introduction to Probability 2판, 7.5절 “Multivariate Normal”(정의, 일차 변환, 결합 정규에서 무상관 = 독립, 각자 정규여도 결합이 정규가 아닌 예). ↩
-
2차원 밀도를 격자로 수치 적분한 값(1.0과 0.5)과 표본 20만 개로 계산한 \(\mathbb{E}[(\mathbf x - \boldsymbol\mu)^\top(\mathbf x - \boldsymbol\mu)] \approx 7\)을 파이썬으로 확인했다. ↩
-
밀도 식에 \(\mathbf x = \boldsymbol\mu\)를 넣은 값 \(\frac{1}{2\pi\sqrt{\det\Sigma}}\)와 고윳값 \(1 \pm \rho\)를 파이썬으로 계산해 확인했다. ↩ ↩2