사용자 × 아이템 평점표를 “사용자의 숨은 취향 몇 가지”와 “아이템의 숨은 특징 몇 가지”의 곱으로 나눈다. 사용자의 취향 목록과 아이템의 특징 목록을 곱해 맞춰 보면, 아직 보지 않은 아이템의 평점을 짐작할 수 있다. 여기에 “이 사람은 원래 후하다”, “이 영화는 원래 인기가 많다” 같은 버릇(편향)과, 무엇을 봤다는 사실 자체를 더하면 더 정확해진다. 다만 빈칸을 무엇으로 볼지에 따라 결과가 크게 달라진다.
예시로 보기
평점 행렬 \(R\)을 사용자 숨은 행렬 \(P\)와 아이템 숨은 행렬 \(Q^\top\)의 곱으로 나눈다. 사용자 \(u\)의 아이템 \(i\) 평점은 두 숨은 벡터의 내적 \(\mathbf p_u^\top\mathbf q_i\)로 짐작한다.
이것이 왜 “협업” 필터링인가? \(\mathbf p_u\)는 사용자 \(u\)가 상호작용한 아이템들로 배우는데, 그 아이템 벡터 \(\mathbf q_i\)는 여러 사용자가 함께 쓴다. 반대로 \(\mathbf q_i\)도 아이템 \(i\)와 상호작용한 사용자들로 배우고, 그 사용자 벡터는 여러 아이템이 함께 쓴다. 따로 배우지 않고 함께 배운다.
사용자 셋의 평점 성향이 후함·보통·짬으로 다른 자료로 편향 MF를 학습했다. 전체 평균 3.09, 사용자 편향은 0.83, −0.08, −0.87로 성향을 그대로 잡았고, 훈련 오차는 0.640에서 0.006으로 줄었다1.
정의
행렬 분해 추천은 평점 행렬을 두 행렬로 나눈다: \(R \approx PQ^\top\).
PureSVD
특잇값 분해 \(R \approx U\Sigma V^\top\)(\(U \in \mathbb{R}^{n \times d}\), \(\Sigma \in \mathbb{R}^{d \times d}\), \(V \in \mathbb{R}^{m \times d}\))를 쓴다.
- \(U\)는 \(RR^\top\)(\(= U\Sigma^2U^\top\))의 고유벡터들이다. \(RR^\top\)의 칸 \(\mathbf r_i \cdot \mathbf r_j\)는 두 사용자의 공동 구매 패턴, 곧 사용자-사용자 유사도다. 그래서 \(U\)는 사용자들의 구매 패턴을 담는 축이다.
- \(V\)는 \(R^\top R\)(\(= V\Sigma^2V^\top\))의 고유벡터들이다. 아이템-아이템 유사도의 축이다.
- 사용자와 아이템이 상호작용을 바탕으로 숨은 공간에 잘 놓이기 때문에 추천에 통한다.
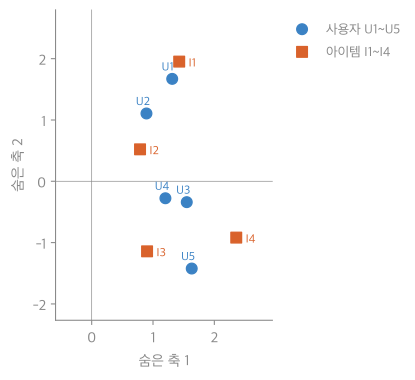
사용자 5명 × 아이템 4개 평점표(U1 = (5, 3, 0, 1), U2 = (4, 0, 0, 1), U3 = (1, 1, 0, 5), U4 = (1, 0, 0, 4), U5 = (0, 1, 5, 4), 0은 빈칸)를 PureSVD로 2차원에 놓았다. 아이템 1을 좋아한 U1, U2는 I1과 함께 위쪽에, 아이템 3·4를 좋아한 U3, U4, U5는 I3, I4와 함께 아래쪽에 놓인다. 사용자 점과 아이템 점의 내적이 예측 평점이다2.
추천 순서: ① \(R\)의 빈칸을 모두 0으로 채운다(특잇값 분해는 빈칸 없는 행렬에만 쓸 수 있다) ② 특잇값 분해한다(닫힌 해, 학습 과정 없음) ③ 위 \(d\)개만 남겨 \(\hat R\)을 다시 만든다 ④ \(\hat R\)에서 점수가 높은 아이템을 추천한다.
PureSVD의 한계: 평점 행렬 전체의 낮은 계수 구조(전역 패턴)만 잡아 개인화가 약하다. 사용자마다 평점을 주는 버릇이 다른 것을 반영하지 못한다. 또 빈칸을 모두 강한 “싫어함”으로 다룬다. 빈칸은 몰라서, 본 적이 없어서, 아직 안 써서일 수 있다.
편향 MF와 SVD++
사용자·아이템 벡터를 고정된 행렬의 분해가 아니라, 관측된 평점에 맞게 직접 학습한다. 실제 평점은 숨은 표현만이 아니라 사용자 편향(후하게·짜게 주는 버릇), 아이템 편향(누구에게나 인기 있거나 없는 것), 암묵적 피드백(과거 상호작용)에도 영향을 받는다.
\[\text{편향 MF:}\quad \hat r_{ui} = \mu + b_u + b_i + \mathbf p_u^\top\mathbf q_i\]\(\mu\)는 전체 평균 평점, \(b_u\)는 사용자가 평균보다 얼마나 후한지, \(b_i\)는 아이템이 평균보다 얼마나 높게 평가되는지다.
\[\text{SVD++:}\quad \hat r_{ui} = \mu + b_u + b_i + \left(\mathbf p_u + \frac{1}{\sqrt{\vert N(u)\vert }}\sum_{j \in N(u)}\mathbf y_j\right)^\top\mathbf q_i\]\(N(u)\)는 사용자 \(u\)가 상호작용한 아이템들, \(\mathbf y_j\)는 아이템 \(j\)의 학습 가능한 암묵적 표현이다. 무엇을 봤는지 자체가 취향의 신호라, 그것을 사용자 표현에 더한다.
목적 함수는 관측된 칸 \(\mathcal O\)에서의 제곱 오차와 정칙화다.
\[\min\sum_{(u,i) \in \mathcal O}\left(r_{ui} - \mu - b_u - b_i - \mathbf p_u^\top\mathbf q_i\right)^2 + \lambda\left(b_u^2 + b_i^2 + \Vert \mathbf p_u\Vert ^2 + \Vert \mathbf q_i\Vert ^2\right)\]세 방법을 견주면 이렇다.
| 자료 | 개인화 | 학습 | 손실 | 목표 | |
|---|---|---|---|---|---|
| PureSVD | 명시적 평점 | 약함(닫힌 해) | 없음 | — | 전역 재구성 |
| 편향 MF | 명시적 평점 | 있음 | 점별 | MSE | 평점 예측 |
| SVD++ | 명시적 + 암묵적 | 있음 | 점별 | MSE | 평점 예측 |
활용
- 구현: 44_mf-recommendation_impl.py(PureSVD는 \(R^\top R\)의 고유분해로, 편향 MF는 확률적 경사 하강으로)
- 편향 MF와 SVD++는 넷플릭스 상금 대회에서 널리 알려진 방법이다(Koren, KDD 2008)1.
- 흔한 실수: 빈칸을 포함한 모든 칸에서 MSE를 줄이는 것. 편향 MF는 관측된 칸만 쓴다. 빈칸까지 0으로 맞추면 PureSVD와 같은 문제(빈칸 = 싫어함)가 생긴다.
연결
- 선수: 협업 필터링, 특잇값 분해, 행렬 분해 군집화(같은 \(X \approx WH\))
- 평점 대신 상호작용 여부로: 단일 클래스 협업 필터링
- 같은 고유분해: 주성분 분석
확인 문제
C1 편향 MF의 예측식을 쓰고 각 항의 뜻을 말하라. SVD++는 무엇을 더하는가?
답: \(\hat r_{ui} = \mu + b_u + b_i + \mathbf p_u^\top\mathbf q_i\). 전체 평균, 사용자가 후한 정도, 아이템이 높게 평가되는 정도, 사용자 취향과 아이템 특징의 상호작용. SVD++는 사용자가 상호작용한 아이템들의 암묵적 표현 평균 \(\frac{1}{\sqrt{\vert N(u)\vert }}\sum_{j \in N(u)}\mathbf y_j\)를 사용자 벡터에 더한다.
C2 전체 평균 3.5, 사용자 편향 0.5, 아이템 편향 −0.3, 숨은 벡터 내적 0.4일 때 편향 MF의 예측 평점은?
답: \(3.5 + 0.5 - 0.3 + 0.4 = 4.1\).
C3 PureSVD가 “빈칸을 강한 싫어함으로 다룬다”는 말의 뜻과 그것이 문제인 이유를 설명하라.
답: 특잇값 분해를 하려고 빈칸을 0(가장 낮은 평점보다도 낮은 값)으로 채우므로, 재구성이 빈칸을 0에 가깝게 맞추려 한다. 그런데 빈칸 대부분은 싫어서가 아니라 몰라서·아직 안 봐서 비어 있다. 그래서 좋아할 만한 아이템의 점수까지 끌어내린다(검증 코드에서 평점이 모두 5인 사용자의 빈칸 예측이 2.47).
C4 목적 함수의 \(\lambda(b_u^2 + b_i^2 + \Vert \mathbf p_u\Vert ^2 + \Vert \mathbf q_i\Vert ^2)\) 항이 하는 일을 한 문장으로 쓰라.
답: 학습할 값들이 지나치게 커지지 않게 벌을 줘서, 관측된 몇 개의 평점에 과적합하는 것을 막는다.
-
44_mf-recommendation_plot.py로 그렸다. 평점표는 구현 코드의 예이고, 사용자 점 \(\mathbf p_u = U_2\Sigma_2^{1/2}\)의 행, 아이템 점 \(\mathbf q_i = V_2\Sigma_2^{1/2}\)의 행으로 놓았다. 내적이 2차원 재구성과 같음, 재구성 오차 56.428, 17.624, 3.382, U2의 재구성 (3.43, 1.28, −0.46, 1.09)가 구현 코드와 같음을 같은 코드로 확인했다. ↩