이름표로 된 속성끼리는 빼기를 할 수 없으니, 두 대상이 몇 칸에서 같은 값을 가졌는지 세어 비슷함을 잰다. 다른 칸이 많을수록 덜 비슷하다. 그런데 “둘 다 없음”까지 같다고 세면 문제가 생긴다. 드문 병의 검사처럼 0이 대부분인 자료에서는 거의 모든 사람이 서로 비슷하게 나오므로, 그런 자료에서는 “둘 다 0”인 칸을 빼고 센다(자카드 계수).
예시로 보기
군집화나 이상치 찾기는 “두 대상이 얼마나 다른가”를 수로 잴 수 있어야 시작할 수 있다. 숫자 속성이면 빼서 재지만, 머리색이나 학년은 뺄 수 없다.
두 학생(객체 2, 객체 3)을 속성 7개로 비교한다.
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | |
|---|---|---|---|---|---|---|---|
| 객체 2 | Black | Student | A | B | C | D | E |
| 객체 3 | Black | Student | A | V | C | D | F |
같은 칸이 5개, 다른 칸이 2개다. 그래서 비유사도는 \(\frac{7 - 5}{7} = \frac27\), 유사도는 \(1 - \frac27 = \frac57\)이다.
이번에는 검사 6개(1 = 양성)를 받은 두 환자를 비교한다. 대부분의 검사가 둘 다 음성이다.
| 열 | 기침 | 검사 1 | 검사 2 | 검사 3 | 검사 4 | |
|---|---|---|---|---|---|---|
| Jack | 1 | 0 | 1 | 0 | 0 | 0 |
| Jim | 1 | 1 | 0 | 0 | 0 | 0 |
모든 칸을 똑같이 세면 6칸 중 2칸이 달라 비유사도가 \(\frac26\)이다. 그런데 둘이 같은 이유의 대부분은 “둘 다 그 병이 없다”는 것이다. 건강한 두 사람은 이 방식으로 완전히 같다고 나온다. “둘 다 음성”인 3칸을 빼면 비유사도는 \(\frac23\)이 된다1.
정의
\(n\)개 대상을 \(p\)개 속성으로 적은 표(대상 × 속성)를 데이터 행렬이라 한다. 모든 대상 쌍의 비유사도 \(d(i, j)\)를 모은 표(대상 × 대상)를 비유사도 행렬이라 한다. 두 대상이 비슷할수록 \(d(i, j)\)는 0에 가깝고, \(d(i, j) = d(j, i)\)라 행렬은 대칭이다. 유사도는 \(\operatorname{sim}(i, j) = 1 - d(i, j)\)로 쓴다.
명목 속성. \(p\)(속성 수) 중 \(m\)(같은 값을 가진 속성 수)을 뺀 비율이다.
\[d(i, j) = \frac{p - m}{p}\]이진 속성. 두 대상의 값을 네 가지로 센다.
| \(j\)가 1 | \(j\)가 0 | |
|---|---|---|
| \(i\)가 1 | \(q\) (둘 다 1) | \(r\) |
| \(i\)가 0 | \(s\) | \(t\) (둘 다 0) |
- 대칭 이진: 두 상태가 같은 무게다. 다른 칸의 비율이다.
- 비대칭 이진: 1이 더 중요하다. 둘 다 1인 일치(\(q\))는 의미가 크고, 둘 다 0인 일치(\(t\))는 별 의미가 없다. 그래서 분모에서 \(t\)를 뺀다.
뒤의 유사도를 자카드 계수라 부른다. 1인 칸을 집합으로 보면 “둘 다 가진 것 ÷ 둘 중 하나라도 가진 것”, 즉 \(\frac{\vert X \cap Y\vert }{\vert X \cup Y\vert }\)다1.
flowchart TD
    S["두 대상을 비교한다"] --> K{"속성 종류는?"}
    K -->|"명목"| N["다른 칸 수 ÷ 전체 칸 수"]
    K -->|"이진"| W{"두 상태의 무게가 같은가?"}
    W -->|"같다"| SY["대칭: 다른 칸 ÷ 모든 칸"]
    W -->|"1이 더 중요하다"| AS["비대칭: 둘 다 0인 칸을 빼고 센다"]
    AS --> J["1 − 비유사도 = 자카드 계수"]
먼저 속성 종류로 갈리고, 이진이면 두 상태의 무게로 한 번 더 갈린다. 비대칭 쪽만 둘 다 0인 칸을 셈에서 뺀다2.
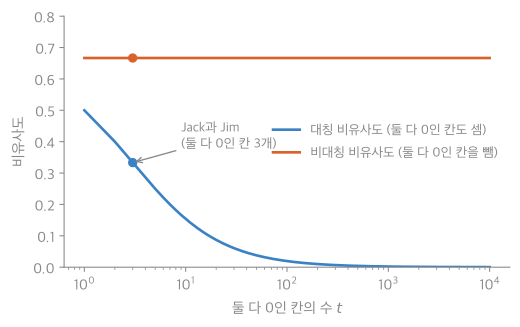
Jack과 Jim에게 ‘둘 다 음성’인 검사를 계속 더했다. 대칭 비유사도는 0으로 내려가 두 사람이 점점 똑같아 보인다. 비대칭 비유사도는 \(\frac23\)에서 움직이지 않는다3.
활용
- 장바구니처럼 “산 것”만 의미가 있는 자료는 비대칭 이진이다. 상품 수만 개 중 두 사람이 둘 다 안 산 상품은 수만 개라, 대칭 방식이면 모든 사람이 거의 같아 보인다. 추천과 문서 비교에서 자카드 계수를 쓰는 이유다1.
- 속성 종류가 섞인 자료는 속성마다 이 문서의 방법과 민코프스키 거리를 따로 계산해 합친다1.
연결
과목별 관점
자료와 정보 (2-1학기). 같은 것을 비유사도 대신 유사도로, “부호 공간의 유사도”라는 이름으로 다룬다. 속성 \(k\)개마다 유사도 \(s(x_i, y_i)\)를 매기고 무게 \(w_i = \frac1k\)로 평균 낸다.
\[\mathrm{sim}(\mathbf x, \mathbf y) = \sum_{i=1}^{k} w_i\, s(x_i, y_i)\]- 겹침 유사도. 값이 같으면 \(s = 1\), 다르면 0이다. 같은 속성의 비율이 되어, 위 명목 속성의 식으로는 \(\frac{m}{p} = 1 - d(i, j)\)다.
- 빈도를 넣은 유사도. 같은 값이라도 흔한 값이 같은 것보다 드문 값이 같은 것이 더 닮았다고 본다. 값 \(x_i\)가 자료 \(n\)개 중 나온 비율을 \(p_i(x_i)\)라 할 때, 같으면 \(s = 1 - p_i^2(x_i)\), 다르면 0이다.
예로 반려동물 여섯 마리를 성별, 색, 성격으로 적어 비교한다. 암컷이 6마리 중 4마리라 \(p(\text{F}) = \frac23\), 빨강도 \(\frac23\), 얌전함(tame)은 \(\frac13\)이다. Bella–Molly는 성별과 색이 같고, Bella–Teddy는 색과 성격이 같다. 겹침 유사도는 둘 다 \(\frac23\)이다. 빈도를 넣으면 Bella–Molly는 \(\frac13\left(\frac59 + \frac59\right) = \frac{10}{27}\), Bella–Teddy는 \(\frac13\left(\frac59 + \frac89\right) = \frac{13}{27}\)이다. 드문 성격이 같은 쪽이 더 닮았다고 나온다.
이진 부호의 거리. 길이 \(n\)의 두 이진 부호에서는 다른 자리의 수를 센다. 이것이 해밍 거리이고, 0과 1에 대한 \(L_1\) 거리 \(\sum_i \vert x_i - y_i\vert\)와 같다. 위 표의 기호로는 \(r + s\)다. 예를 들어 010010010과 100001011은 다섯 자리가 달라 해밍 거리가 5다.
자카드 지수. 두 집합 \(\mathbf x, \mathbf y\)에서 \(J(\mathbf x, \mathbf y) = \frac{\vert \mathbf x \cap \mathbf y\vert }{\vert \mathbf x \cup \mathbf y\vert }\)이다. 위의 \(\frac{q}{q + r + s}\)와 같은 식이다. 해밍 거리가 못 가르는 두 경우가 있다.
| 경우 1 | 경우 2 | |
|---|---|---|
| 두 집합 | 원소 1,000개씩, 995개가 같다 | 원소 5개씩, 같은 것이 없다 |
| 해밍 거리 | 10 | 10 |
| 자카드 | \(\frac{995}{1005} \approx 0.99\) | 0 |
해밍 거리는 다른 것의 수만 세고 같은 것이 얼마나 많은지는 보지 않는다. 그래서 거의 똑같은 두 집합과 완전히 다른 두 집합에 같은 값을 준다. 자카드는 합친 크기로 나누어 둘을 가른다. 문자열의 낱말 집합에 쓰는 같은 식은 문자열 유사도에 있다.
확인 문제
C1 대칭 이진 비유사도와 비대칭 이진 비유사도의 식을 \(q, r, s, t\)로 쓰고, 둘이 다른 이유를 말하라.
답: 대칭은 \(\frac{r + s}{q + r + s + t}\), 비대칭은 \(\frac{r + s}{q + r + s}\). 비대칭에서는 둘 다 0인 일치(\(t\))가 별 의미가 없어서 분모에서 뺀다.
C2 상품 6개 중 두 고객이 둘 다 산 것 1개, 한 사람만 산 것 2개, 둘 다 안 산 것 3개다. 대칭 비유사도, 비대칭 비유사도, 자카드 계수를 구하라.
답: \(q = 1\), \(r + s = 2\), \(t = 3\). 대칭 \(\frac{2}{6} = \frac13\), 비대칭 \(\frac{2}{3}\), 자카드 \(\frac13\).
C3 상품이 1만 개인 쇼핑몰에서 두 고객의 구매 기록을 대칭 이진 비유사도로 비교하면 어떤 일이 생기는가?
답: 거의 모든 상품이 둘 다 안 산 것(\(t\))이라 분모가 1만에 가깝고, 비유사도가 거의 0이 된다. 모든 고객이 서로 비슷해 보여 구별하지 못한다. 둘 다 0인 칸을 빼는 비대칭 비유사도(자카드)를 써야 한다.
C4 성별·색·성격 세 속성으로 적은 여섯 마리 가운데 암컷 4마리, 은색 2마리가 있다. Coco(F, silver, cool)와 Max(M, silver, brave)의 겹침 유사도와 빈도를 넣은 유사도를 구하라. 암컷과 빨강이 같은 Bella–Molly(\(\frac{10}{27}\))와 비교하면?
답: 색만 같아 겹침 유사도 \(\frac13\). 은색의 비율이 \(\frac26 = \frac13\)이라 빈도 유사도는 \(\frac13\left(1 - \frac19\right) = \frac{8}{27}\).
이유: 같은 속성은 하나뿐인데 Bella–Molly(둘이 같음)의 \(\frac{10}{27}\)에 바짝 붙는다. 은색이 드문 값이라 한 번 같은 것이 \(\frac89\)로 크게 쳐지고, Bella–Molly의 흔한 값 둘은 각각 \(\frac59\)밖에 못 받기 때문이다4.