약한 모델을 하나씩 차례로 만들되, 새 모델은 앞 모델들이 틀린 자료에 더 신경 쓰게 한다. 틀린 자료의 무게를 키우고 맞힌 자료의 무게를 줄여 다음 모델을 훈련하는 일을 되풀이하고, 마지막에 잘 맞힌 모델의 목소리를 더 크게 해서 모두의 의견을 합친다. 혼자서는 겨우 찍기보다 나은 모델들로 강한 모델을 만든다. 대신 어려운 자료에 계속 집중하므로 잘못 붙은 정답(잡음)에도 끝까지 매달려 잡음에 약하다.
예시로 보기
배깅은 모델들을 따로따로 만든다. 그런데 앞 모델이 어디서 틀렸는지 알면, 다음 모델이 그곳을 고치게 할 수 있지 않을까?
점 10개 \(x = 1, \dots, 10\)의 정답이 +, +, +, −, −, −, +, +, +, −다. 약한 모델은 한 곳에서 자르는 규칙(“\(x \le t\)면 +, 아니면 −” 또는 그 반대), 즉 결정 그루터기다1.
| 라운드 | 고른 규칙 | 틀린 점 | 가중 오류 \(\epsilon\) | 모델 가중치 \(\alpha\) |
|---|---|---|---|---|
| 1 | \(x \le 3.5\)면 + | 7, 8, 9 | 0.300 | 0.424 |
| 2 | \(x \le 9.5\)면 + | 4, 5, 6 | 0.214 | 0.650 |
| 3 | \(x \le 6.5\)면 −, 아니면 + | 1, 2, 3, 10 | 0.182 | 0.752 |
1라운드 뒤 틀린 7, 8, 9의 무게는 \(\frac{1}{10}\)에서 \(\frac16\)으로 커지고, 맞힌 점들은 \(\frac{1}{14}\)로 작아진다. 틀린 세 점의 무게 합이 정확히 \(\frac12\)이 된다. 그래서 2라운드 모델은 7, 8, 9를 꼭 맞히는 규칙을 고른다.
세 모델의 가중 투표 \(0.424h_1 + 0.650h_2 + 0.752h_3\)의 부호는 10개 점을 모두 맞힌다. 모델 하나하나는 3~4개씩 틀리는데도 그렇다.
flowchart LR
    W1["무게 w: 모두 1/10"] --> H1["h1: x ≤ 3.5면 +"]
    H1 --> W2["7, 8, 9의 무게를 키운다"]
    W2 --> H2["h2: x ≤ 9.5면 +"]
    H2 --> W3["4, 5, 6의 무게를 키운다"]
    W3 --> H3["h3: x ≤ 6.5면 −"]
    H1 -->|"α 0.424"| F["가중 투표의 부호"]
    H2 -->|"α 0.650"| F
    H3 -->|"α 0.752"| F
모델은 한 줄로 이어져 있다. 각 모델이 틀린 점의 무게가 다음 모델의 훈련 자료를 바꾼다. 마지막 투표에서는 가중 오류가 작았던 모델일수록 큰 무게를 받는다.
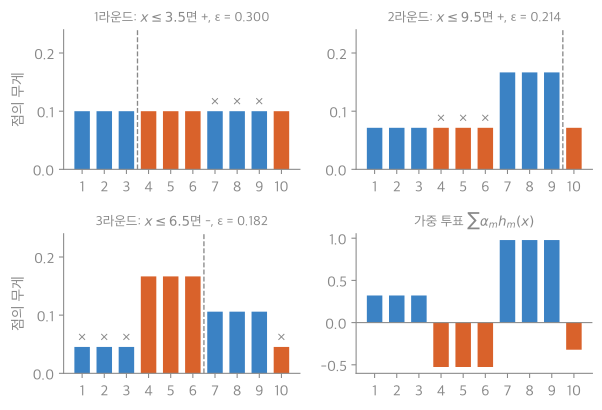
막대는 점의 무게다. 파란색은 정답이 +, 주황색은 정답이 −인 점이다. ×는 그 라운드의 규칙(점선에서 자름)이 틀린 점이다. 틀린 점은 다음 라운드에서 막대가 커지고, 마지막 그림의 가중 투표는 10개 점 모두에서 정답과 부호가 같다2.
정의
부스팅은 모델을 차례로 훈련하며 앞 모델의 실수에 집중하게 하는 앙상블이다. 새 모델은 앞 모델들의 오류를 고치려 하고, 최종 예측은 모델들의 가중 결합이다. 모델이 앞 모델에 기대어 만들어지므로 서로 독립이 아니다. 그래서 분산을 줄이기보다 어려운 예제의 성능을 점점 높여 편향을 줄이는 데 초점이 있다.
AdaBoost(적응형 부스팅)는 이것을 다음 식으로 한다. 자료는 \((x_i, y_i)\), \(y_i \in \{+1, -1\}\), \(i = 1, \dots, N\)이다.
w_i ← 1/N (모든 i)                              # 처음엔 무게가 같다
for m = 1..M:
    f_m ← 가중치 w로 훈련한 약한 모델
    ε_m ← (틀린 점들의 w 합) / (w 전체 합)        # 가중 오류
    α_m ← ½ ln((1 - ε_m) / ε_m)                  # 모델 가중치
    w_i ← w_i · exp(-α_m · y_i · f_m(x_i))       # 맞히면 줄고 틀리면 커진다
    w_i ← w_i / Σ_j w_j                          # 합을 1로
최종 모델 F(x) = sign(Σ_m α_m f_m(x))
식으로 쓰면 다음과 같다.
\[\epsilon_m = \frac{\sum_{i=1}^{N} w_i^{(m)}\mathbf 1(y_i \ne f_m(x_i))}{\sum_{i=1}^{N} w_i^{(m)}}, \qquad \alpha_m = \frac12\log\frac{1 - \epsilon_m}{\epsilon_m}\]\(\mathbf 1(\cdot)\)은 괄호 안이 참이면 1, 거짓이면 0이다. 맞히면 \(y_i f_m(x_i) = +1\)이라 가중치에 \(e^{-\alpha_m}\)이 곱해져 줄고, 틀리면 \(-1\)이라 \(e^{\alpha_m}\)이 곱해져 커진다. 오류가 작은 모델일수록 \(\alpha_m\)이 커서 최종 투표에서 목소리가 크다.
\(\alpha_m\)의 식에서 \(\epsilon_m < \frac12\)(찍기보다 낫다)이면 \(\alpha_m > 0\)이고, \(\epsilon_m = \frac12\)이면 \(\alpha_m = 0\)이라 그 모델은 투표에 아무 영향이 없다1.
활용
- 모델을 차례로 만들어야 해서 병렬로 훈련하기 어렵다.
- 잘못 붙은 정답이 있으면 그 점을 계속 “어려운 예제”로 여겨 가중치를 키운다. 그래서 잡음에 민감하다.
- 사이킷런
AdaBoostClassifier가 이것이다. 같은 생각을 오차의 기울기로 넓힌 그래디언트 부스팅(XGBoost, LightGBM)이 표 형식 자료에서 널리 쓰인다1.
연결
- 선수: 앙상블 학습
- 비교: 배깅과 부스팅 비교
- \(\alpha\) 식의 로그: 로그
확인 문제
C1 AdaBoost에서 가중 오류 \(\epsilon_m\), 모델 가중치 \(\alpha_m\), 자료 가중치 갱신, 최종 모델의 식을 쓰라.
답: \(\epsilon_m = \frac{\sum w_i\mathbf 1(y_i \ne f_m(x_i))}{\sum w_i}\), \(\alpha_m = \frac12\ln\frac{1 - \epsilon_m}{\epsilon_m}\), \(w_i \leftarrow w_i e^{-\alpha_m y_i f_m(x_i)}\) 뒤 합이 1이 되게 나눈다. \(F(x) = \operatorname{sign}\left(\sum_m \alpha_m f_m(x)\right)\).
C2 점 10개의 처음 가중치가 모두 0.1이고, 1라운드 모델이 3개를 틀렸다. \(\epsilon_1\), \(\alpha_1\)과, 갱신·정규화 뒤 틀린 점과 맞힌 점의 가중치를 구하라.
답: \(\epsilon_1 = 0.3\), \(\alpha_1 = \frac12\ln\frac{0.7}{0.3} \approx 0.424\). 틀린 점은 \(0.1 e^{0.424}\), 맞힌 점은 \(0.1 e^{-0.424}\)가 되고, 정규화하면 틀린 점 \(\frac16\), 맞힌 점 \(\frac1{14}\)이다. 틀린 점들의 합이 \(\frac12\)이 된다.
C3 가중 오류가 0.5인 모델의 \(\alpha\)는? 그 모델이 최종 투표에 미치는 영향은?
답: \(\alpha = \frac12\ln 1 = 0\). 동전 던지기와 같은 모델이라 투표에 아무 영향을 주지 않는다.
C4 의사코드의 w_i ← w_i · exp(-α_m · y_i · f_m(x_i)) 줄이 하는 일을 한 문장으로 쓰라.
답: 이번 모델이 맞힌 자료의 무게는 줄이고 틀린 자료의 무게는 키워, 다음 모델이 틀린 자료에 더 집중하게 한다.
-
22_boosting-adaboost_plot.py로 그렸고, 세 라운드의 \(\epsilon\) 0.300, 0.214, 0.182와 \(\alpha\) 0.424, 0.650, 0.752, 1라운드 뒤 무게 \(\frac16\)과 \(\frac1{14}\), 가중 투표의 부호를 같은 코드로 확인했다. ↩