균등분포는 구간 안 어디든 똑같이 그럴듯한 값이다. 컴퓨터의 기본 난수가 이 분포이고, 여기에 알맞은 함수를 씌우면 다른 어떤 분포의 난수도 만들 수 있다. 지수분포는 드물게 일어나는 일을 기다리는 시간이다. 요청이 무작위로 오면 다음 요청까지의 간격이 이 분포를 따르고, 평균 발생률의 역수가 평균 대기 시간이다. 지수분포는 기하분포처럼 기억이 없어서, 오래 쓴 부품일수록 잘 고장 나는 “노화”를 나타내지 못한다.
예시로 보기
버스가 10분 간격으로 오는데 도착 시각을 모르고 정류장에 간다. 대기 시간은 0~10분 사이 균등분포다. 7분 넘게 기다릴 확률은 남은 구간 길이의 비율 \(\frac{3}{10}\), 평균 대기는 5분이다.
이번에는 서버에 요청이 1초에 평균 3개씩 무작위로(포아송 과정으로) 들어온다. 다음 요청까지 1초 넘게 기다릴 확률은 “1초 동안 요청이 0개일 확률”과 같아 포아송 분포로 \(e^{-3} \approx 0.05\)다. 평균 간격은 \(\frac13\)초다. 첫 사례가 아래의 \(\mathrm{Unif}(0, 10)\), 둘째가 \(\mathrm{Exp}(3)\)이다.
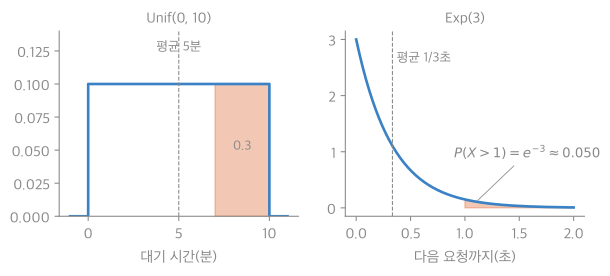
색칠한 넓이가 두 예시의 확률이다. 균등분포는 높이가 평평해서 넓이가 구간 길이에 비례한다. 지수분포는 0 근처가 가장 높고, 오른쪽으로 갈수록 빠르게 낮아진다1.
정의
균등분포 \(\mathrm{Unif}(a, b)\)는 \(a < x < b\)에서 밀도 \(\frac{1}{b - a}\), 밖에서 0이다. 평균 \(\frac{a + b}{2}\), 분산 \(\frac{(b - a)^2}{12}\).
지수분포 \(\mathrm{Exp}(\lambda)\)(\(\lambda > 0\))는 \(x \ge 0\)에서 밀도 \(\lambda e^{-\lambda x}\)이다. CDF \(1 - e^{-\lambda x}\), 평균 \(\frac1\lambda\), 분산 \(\frac{1}{\lambda^2}\), 중앙값 \(\frac{\ln 2}{\lambda}\)2.
지수분포의 \(\lambda\)는 “단위 시간당 발생률”이다. 발생률이 3이면 평균 대기는 \(\frac13\)이다. 책에 따라 평균 \(\beta = \frac1\lambda\)를 모수로 쓰기도 하니 확인한다.
- 무기억성: \(P(X > s + t \mid X > s) = P(X > t)\). 이 성질을 가진 연속 분포는 지수분포뿐이다.
- 포아송 과정과의 관계: 발생률 \(\lambda\)인 포아송 과정에서 사건 사이의 간격은 서로 독립인 \(\mathrm{Exp}(\lambda)\)다.
- 최솟값: 독립인 \(X_i \sim \mathrm{Exp}(\lambda_i)\)의 최솟값은 \(\mathrm{Exp}(\lambda_1 + \cdots + \lambda_n)\)이다.
- 역변환: \(U \sim \mathrm{Unif}(0, 1)\)이면 \(-\frac{\ln(1 - U)}{\lambda} \sim \mathrm{Exp}(\lambda)\)다.
증명 펼치기
- 무기억성: \(P(X > x) = e^{-\lambda x}\)라 \(\frac{e^{-\lambda(s + t)}}{e^{-\lambda s}} = e^{-\lambda t}\). 기하분포와 같은 계산이다.
- 포아송 과정: 첫 사건이 \(t\)보다 늦을 확률은 “\([0, t]\)에 사건이 0개”일 확률 \(e^{-\lambda t}\)이다. 이것이 \(\mathrm{Exp}(\lambda)\)의 꼬리 확률이다. 독립성은 겹치지 않는 구간의 사건 수가 독립이라는 포아송 과정의 정의에서 나온다 [증명 스케치].
- 최솟값: 모두 \(t\)보다 커야 최솟값이 \(t\)보다 크므로, 독립이라 \(P(\min > t) = \prod_i e^{-\lambda_i t} = e^{-(\sum\lambda_i)t}\).
- 역변환: \(P\left(-\frac{\ln(1 - U)}{\lambda} \le x\right) = P(U \le 1 - e^{-\lambda x}) = 1 - e^{-\lambda x}\). 일반적으로 \(F^{-1}(U)\)의 CDF는 \(F\)다(균등분포의 보편성). ∎
flowchart LR
    PP["발생률 λ인 포아송 과정"] -->|"단위 시간의 사건 수"| Po["포아송 Pois(λ)"]
    PP -->|"사건 사이 간격"| Ex["지수 Exp(λ)"]
    Ge["기하분포"] -.->|"연속 시간판"| Ex
    U["균등 난수 U, Unif(0, 1)"] -->|"-ln(1-U)/λ"| Ex
같은 포아송 과정을 개수로 세면 포아송 분포, 간격으로 재면 지수분포다. 아래의 균등 난수는 역변환을 거쳐 지수분포 표본이 된다.3
예제
복제본 중 첫 고장. 서버 세 대가 독립으로 고장 나고, 각 고장까지의 시간이 \(\mathrm{Exp}(0.01)\)(시간 단위, 평균 100시간)이다.
- 첫 고장: 성질 3으로 첫 고장까지의 시간은 \(\mathrm{Exp}(0.03)\).
- 평균: \(\frac{1}{0.03} \approx 33.3\)시간. 서버가 세 배 많으면 첫 고장은 세 배 빨리 온다.
- 50시간 무고장: \(e^{-0.03 \times 50} = e^{-1.5} \approx 0.22\).
활용
- 시뮬레이션의 출발점. 언어가 주는 기본 난수는 0~1 균등분포다. 역변환으로 지수분포를, 박스–뮬러 변환으로 정규분포를 만든다.
- 대기행렬과 신뢰성. 도착 간격과 처리 시간을 지수분포로 두면 대기행렬 모델이 풀리기 쉬워진다. 고장까지의 시간을 지수분포로 두면 “고장률이 일정하다”는 가정이 된다.
- 맞지 않는 경우. 오래 쓸수록 잘 고장 나는 기계 부품, 처음에 잘 고장 나는 불량품처럼 고장률이 시간에 따라 바뀌면 지수분포가 틀린다. 무기억성이 맞는지부터 따진다.
- 알고리즘에서: 나올 수 있는 값이 유한 개인 분포는 누적 확률표에서 ‘누적 확률이 0~1 균등 난수 \(U\)보다 큰 첫 값’을 이분 탐색으로 찾아 뽑는다. 가중치를 준 파이썬
random.choices가 이 방식이다.
연결
- 선수: 연속 확률변수와 확률밀도
- 이산판: 기하분포(지수분포는 연속 시간의 기하분포), 포아송 분포(같은 과정의 개수)
확인 문제
C1 버스 대기 시간이 \(\mathrm{Unif}(0, 10)\)분일 때 7분 넘게 기다릴 확률, 평균, 분산은?
답: \(\frac{10 - 7}{10} = 0.3\), 평균 5분, 분산 \(\frac{100}{12} \approx 8.33\)분².
C2 요청 도착 간격이 \(\mathrm{Exp}(3)\)(초)일 때 간격이 1초를 넘을 확률과 간격의 중앙값은?
답: \(P(X > 1) = e^{-3} \approx 0.050\). 중앙값 \(\frac{\ln 2}{3} \approx 0.231\)초. 평균 \(\frac13 \approx 0.333\)초보다 작다. 긴 간격이 드물게 섞여 평균을 끌어올리기 때문이다.
C3 독립인 부품 세 개의 수명이 각각 \(\mathrm{Exp}(0.01)\)일 때, 첫 고장까지의 시간이 왜 \(\mathrm{Exp}(0.03)\)인지 설명하고 평균을 구하라.
답: 첫 고장이 \(t\)보다 늦으려면 셋 모두 \(t\)보다 오래 버텨야 한다. 독립이라 \(P(\min > t) = e^{-0.01t} \cdot e^{-0.01t} \cdot e^{-0.01t} = e^{-0.03t}\)이고, 이것이 \(\mathrm{Exp}(0.03)\)의 꼬리 확률이다. 발생률이 더해지는 셈이라 평균은 \(\frac{1}{0.03} \approx 33.3\)시간.
-
15_uniform-exponential_plot.py로 그렸고, 그림에 쓴 값(\(\frac{3}{10}\), 수치 적분한 \(P(X > 1) = e^{-3} \approx 0.050\))을 같은 코드로 확인했다. ↩
-
Blitzstein, Hwang, Introduction to Probability 2판, 5.2절 “Uniform”, 5.3절 “Universality of the Uniform”(역변환), 5.5절 “Exponential”(무기억성, 최솟값), 5.6절 “Poisson processes”(도착 간격). ↩
-
이 문서 정리의 성질 2·4와 연결 절(기하분포의 연속판)을 그렸다. ↩