표본에서 계산한 평균 같은 값은 표본을 다시 뽑으면 달라지는 확률변수다. 그래서 “이 계산법이 얼마나 좋은가”를 과녁 맞히기처럼 따진다. 평균적으로 과녁 중심에서 비껴 있는가(편향), 화살이 얼마나 흩어지는가(분산), 둘을 합쳐 중심에서 평균적으로 얼마나 먼가(평균제곱오차). 표본분산을 표본 수가 아니라 하나 적은 수로 나누는 것은 편향을 없애기 위해서지만, 편향이 없는 계산법이 늘 가장 정확한 것은 아니다.
예시로 보기
주사위를 4번 던져 평균을 내는 실험을 10만 번 되풀이하면, 표본평균은 매번 다르다. 그 값들의 평균은 3.5, 분산은 \(\frac{35/12}{4} \approx 0.73\)이다. 한 번의 표본평균은 이 분포에서 뽑힌 하나의 값이다.
표본평균이 따르는 이 분포가 아래의 표본분포이고, “4번 던져 평균 내기”라는 규칙이 추정량 \(\hat\theta\), 3.5가 추정하려는 모수 \(\theta\)다.
정의
모수 \(\theta\)를 표본 \(X_1, \dots, X_n\)으로 어림하는 규칙 \(\hat\theta = g(X_1, \dots, X_n)\)을 추정량이라 하고, 그 분포를 표본분포라 한다1.
- 편향: \(\operatorname{bias}(\hat\theta) = \mathbb{E}[\hat\theta] - \theta\)(\(\mathbb{E}[\cdot]\)은 평균(기댓값)). 0이면 불편.
- 표준오차: \(\operatorname{SD}(\hat\theta)\).
- 평균제곱오차: \(\operatorname{MSE}(\hat\theta) = \mathbb{E}[(\hat\theta - \theta)^2]\).
- 일치성: \(n \to \infty\)일 때 모든 \(\varepsilon > 0\)에서 \(P(\vert \hat\theta - \theta\vert > \varepsilon) \to 0\).
flowchart LR
    P["모집단: 모수 θ"] -->|"뽑기"| S["표본 X1, …, Xn"]
    S -->|"규칙 g"| E["추정값 θ̂ 하나"]
    E -.->|"뽑기를 되풀이"| D["표본분포: θ̂ 값들의 분포"]
    D --> B["편향: 평균이 θ에서 비낀 정도"]
    D --> V["표준오차: 흩어진 정도"]
표본 한 번은 추정값 하나만 준다. 점선처럼 뽑기를 되풀이해야 표본분포가 보이고, 편향과 표준오차는 그 분포에서 읽는다.2
\(\operatorname{MSE}(\hat\theta) = \operatorname{bias}(\hat\theta)^2 + \operatorname{Var}(\hat\theta)\)(\(\operatorname{Var}\)는 분산).
증명 펼치기
\(\mu = \mathbb{E}[\hat\theta]\)로 두고 \(\hat\theta - \theta = (\hat\theta - \mu) + (\mu - \theta)\)로 쪼갠다. 제곱해 기댓값을 취하면 교차항 \(2(\mu - \theta)\mathbb{E}[\hat\theta - \mu]\)는 \(\mathbb{E}[\hat\theta - \mu] = 0\)이라 사라진다. 남는 것이 \(\operatorname{Var}(\hat\theta) + (\mu - \theta)^2\)이다. ∎
표본평균. \(\bar X\)는 불편이고 분산 \(\frac{\sigma^2}{n}\)이라 일치 추정량이다(큰 수의 법칙). \(n\)이 크면 표본분포가 정규분포에 가깝다(중심극한정리).
\(n - 1\)로 나누는 이유. \(\mathbb{E}\left[\sum(X_i - \bar X)^2\right] = (n - 1)\sigma^2\)(\(\sum\)은 차례로 모두 더한다는 기호)이다. 편차를 참 평균 \(\mu\)가 아니라 자료에 가장 가깝게 맞춘 \(\bar X\)로 재서 제곱합이 조금 작게 나온다. 그만큼 나누는 수를 줄여 보정한다.
\((n - 1)\sigma^2\)의 유도
- 쪼개기: \(\sum(X_i - \bar X)^2 = \sum(X_i - \mu)^2 - n(\bar X - \mu)^2\)(전개하면 교차항이 \(-2n(\bar X - \mu)^2\)로 모인다).
- 기댓값: 첫 합의 기댓값은 \(n\sigma^2\), 둘째 항은 \(n \cdot \operatorname{Var}(\bar X) = n \cdot \frac{\sigma^2}{n} = \sigma^2\).
- 결론: \(n\sigma^2 - \sigma^2 = (n - 1)\sigma^2\). ∎
예제
불편이 최선은 아니다. 정규분포에서 표본 5개로 분산 \(\sigma^2\)를 어림한다.
- 두 후보: 불편 \(S^2_{n-1} = \frac{1}{4}\sum(X_i - \bar X)^2\), 편향된 \(S^2_n = \frac15\sum(X_i - \bar X)^2\).
- 불편 추정량의 MSE: 편향 0, 분산 \(\frac{2\sigma^4}{n - 1} = 0.5\sigma^4\).
- 편향된 추정량의 MSE: 편향 \(-\frac{\sigma^2}{5}\), 분산이 더 작아 합이 \(\frac{2n - 1}{n^2}\sigma^4 = 0.36\sigma^4\).
- 결론: 조금 치우쳐도 덜 흩어지는 쪽이 평균적으로 더 정확하다. 이 편향-분산 줄다리기가 과적합과 정칙화의 핵심이다3.
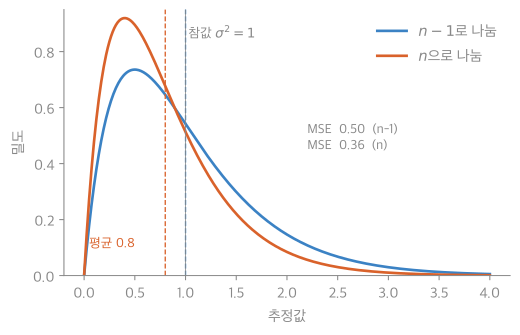
참 분산이 1인 정규분포에서 표본 5개로 두 추정량을 계산한 값의 분포다. 파랑(\(n - 1\)로 나눔)은 평균이 정확히 1이지만 오른쪽으로 넓게 퍼진다. 주황(\(n\)으로 나눔)은 평균이 0.8로 비껴 있지만 덜 퍼져서, 평균제곱오차가 더 작다4.
활용
- 측정 설계. 벤치마크를 몇 번 돌릴지는 표준오차 \(\frac{\sigma}{\sqrt n}\)을 원하는 크기로 줄이는 \(n\)으로 정한다.
- 기계학습. 모델의 예측 오차도 편향(모델이 너무 단순)과 분산(데이터에 너무 민감)으로 나뉜다. 정칙화는 편향을 조금 받아들이고 분산을 크게 줄이는 선택이다.
연결
과목별 관점
자료와 정보 (2-1학기). \(n - 1\) 이야기를 최대가능도 추정 쪽에서 다시 만난다(MLE 바이어스). 정규분포의 분산을 최대가능도로 구하면 편차 제곱의 합을 표본 수 \(N\)으로 나눈 \(\hat\theta_2 = \frac1N \sum_{k=0}^{N-1} (x_k - \hat\theta_1)^2\)이 나온다(\(\hat\theta_1\)은 표본평균). 이 식을 \(N - 1\)로 나눈 식과 나란히 놓으면 두 물음이 생긴다. 최대가능도 추정값은 한쪽으로 치우쳐 있는가? 그렇다면 어떻게 고치는가?
위의 \((n - 1)\sigma^2\) 유도가 그 답이다. 편차 제곱합의 평균이 \((N - 1)\sigma^2\)이므로 \(N\)으로 나눈 값은 평균적으로 참 분산의 \(\frac{N - 1}{N}\)배다. 표본이 4개면 \(\frac34\), 10개면 0.9, 100개면 0.99다. 늘 작은 쪽으로 치우치지만 표본이 많아지면 치우침이 사라진다. \(N - 1\)로 나누면(같은 말로, \(\frac{N}{N - 1}\)을 곱하면) 평균이 정확히 \(\sigma^2\)이 된다5. 평균의 추정값 \(\hat\theta_1\)은 표본평균 그대로라 치우침이 없다.
확인 문제
C1 어떤 추정량의 편향이 2, 분산이 5다. 평균제곱오차는?
답: \(2^2 + 5 = 9\).
C2 표본분산을 \(n\)이 아니라 \(n - 1\)로 나누는 이유를 설명하라.
답: 편차를 참 평균 대신 표본평균으로 재는데, 표본평균은 그 자료의 제곱합을 가장 작게 만드는 값이다. 그래서 \(\sum(X_i - \bar X)^2\)의 기댓값이 \(n\sigma^2\)이 아니라 \((n - 1)\sigma^2\)이다. \(n - 1\)로 나눠야 기댓값이 \(\sigma^2\)이 된다.
C3 불편 추정량보다 평균제곱오차가 작은 편향 추정량의 예를 들어라.
답: 정규분포, 표본 5개에서 분산을 \(\frac15\sum(X_i - \bar X)^2\)로 어림하면 MSE가 \(0.36\sigma^4\)로, 불편인 \(\frac14\sum(\cdots)\)의 \(0.5\sigma^4\)보다 작다. 편향이 조금 생기지만 분산이 더 크게 준다.
C4 표본 10개로 정규분포의 분산을 최대가능도 추정하면, 그 값은 평균적으로 참 분산의 몇 배인가? 치우침을 없애려면 무엇을 곱하는가?
답: \(\frac{10 - 1}{10} = 0.9\)배. \(\frac{10}{9}\)를 곱한다. 곧 10 대신 9로 나눈다.
이유: 최대가능도 추정값은 편차 제곱합을 \(N\)으로 나눈 것이고, 편차 제곱합의 평균은 \((N - 1)\sigma^2\)이다. 표본평균이 자료에 가장 가깝게 맞춘 값이라 제곱합이 조금 작게 나온다5.
-
Wasserman, All of Statistics, “Models, Statistical Inference and Learning” 장(점추정, 편향, 표준오차, MSE의 편향-분산 분해, 일치성). Blitzstein, Hwang, Introduction to Probability 2판, 6.3절 “Sample moments”(표본분산의 기댓값). ↩
-
이 문서 예시(주사위 4번의 평균을 10만 번 되풀이)와 정의를 순서대로 그렸다. ↩
-
정규분포에서 \(\operatorname{Var}(S^2_{n-1}) = \frac{2\sigma^4}{n - 1}\)은 \(\frac{(n-1)S^2}{\sigma^2}\)이 자유도 \(n - 1\)인 카이제곱분포를 따른다는 데서 나온다(Blitzstein·Hwang 10.4절). 두 MSE는 29_estimators_verify.py로 확인했다. ↩
-
29_estimators_plot.py로 그렸고, 그림에 쓴 값(모의실험 20만 회의 평균 1과 0.8, MSE 0.50과 0.36)을 같은 코드로 확인했다. ↩
-
\(\frac{N-1}{N}\)배라는 값과 표본 수별 숫자, 카드 C4는 이 문서의 \((n - 1)\sigma^2\) 유도에서 바로 나오고, 검증 코드로 확인했다. ↩ ↩2