정확히 계산하기 어려운 값을, 무작위로 뽑은 표본으로 실험해 평균을 내서 어림하는 방법이다. 정사각형에 모래를 뿌려 원 안에 떨어진 비율로 원의 넓이를 재는 식이다. 오차는 표본 수의 제곱근에 반비례하고 차원 수와 상관없어서, 변수가 수십 개인 적분이나 복잡한 시스템의 확률처럼 다른 방법이 무너지는 곳에서 강하다. 대신 정확도를 한 자리 올리려면 표본이 100배 필요하고, 아주 드문 사건은 표본에 거의 걸리지 않아 그대로는 어림하기 어렵다.
예시로 보기
한 변이 1인 정사각형 안에 점을 고르게 뿌리고, 원점에서 거리 1 안(사분원)에 떨어진 비율에 4를 곱하면 \(\pi\)의 어림값이다. 사분원의 넓이가 \(\frac\pi4\)이기 때문이다.
| 표본 수 | 1,000 | 4,000 | 16,000 |
|---|---|---|---|
| 오차의 크기(제곱평균) | 약 0.05 | 약 0.026 | 약 0.013 |
표본을 4배로 늘릴 때마다 오차가 절반이 된다. 점 하나가 “사분원 안이면 4, 밖이면 0”인 확률변수 \(Y\)이고, 비율에 4를 곱한 값이 아래 정의의 표본평균이다.
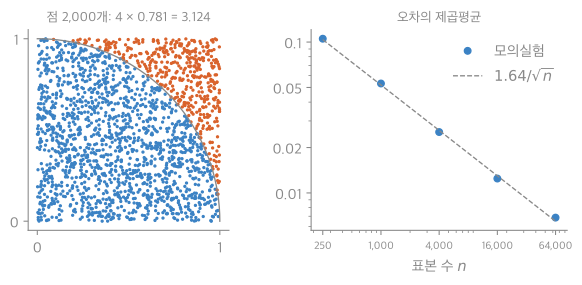
왼쪽은 점 2,000개를 뿌린 한 번의 실험이다. 오른쪽은 표본 수마다 실험을 400번 되풀이해 오차의 제곱평균을 잰 것이다. 로그 눈금에서 점들이 직선 \(\frac{1.64}{\sqrt n}\) 위에 놓인다. 1.64는 \(Y\)의 표준편차 \(\sqrt{\pi(4 - \pi)}\)다1.
정의
구하려는 값을 어떤 확률변수의 기댓값 \(\theta = \mathbb{E}[Y]\)(\(\mathbb{E}[\cdot]\)은 평균(기댓값))로 쓴다. 독립인 표본 \(Y_1, \dots, Y_n\)을 만들어
\[\hat\theta_n = \frac1n\sum_{i=1}^{n}Y_i\]로 어림한다. 큰 수의 법칙으로 \(\hat\theta_n \to \theta\)이고, 중심극한정리로 오차는 대략 \(\mathcal{N}\left(0, \frac{\sigma^2}{n}\right)\)을 따른다(\(\sigma^2 = \operatorname{Var}[Y]\)). 그래서 95% 오차 막대는 \(\hat\theta_n \pm 1.96\frac{\hat\sigma}{\sqrt n}\)이다(\(\hat\sigma\)는 표본 표준편차)2.
적분으로 쓰기. \(\int_D g(\mathbf{x})\,d\mathbf{x}\)(\(\int\)는 넓이를 구하는 적분 기호)는 \(D\) 위 균등분포의 \(\mathbf{X}\)에 대해 \(\vert D\vert \cdot \mathbb{E}[g(\mathbf{X})]\)다. 확률 \(P(A)\)는 지시 확률변수의 기댓값 \(\mathbb{E}[I_A]\)다.
flowchart LR
    T["구하려는 값 θ"] --> E["기댓값 E[Y]로 쓰기"]
    E --> S["독립 표본 Y1, …, Yn 만들기"]
    S --> A["표본평균 θ̂n"]
    A --> B["오차 막대 ±1.96 σ̂/√n"]
모든 몬테카를로 계산이 이 네 칸을 차례로 지난다. 문제마다 달라지는 곳은 첫 칸, 곧 구하려는 값을 어떤 확률변수의 기댓값으로 쓰느냐다.3
알아보는 신호. 적분 차원이 높다, 식으로 풀기 어려운 시스템의 확률이나 기댓값이다, 난수로 시스템을 흉내 낼 수는 있다.
차원과 무관한 오차. \([0, 1]^d\)에서 \(\sum x_i^2\)의 평균(참값 \(\frac d3\))을 표본 1만 개로 어림하면 \(d = 2, 10, 50\) 모두 상대 오차가 1% 안이다. 같은 정확도를 격자로 얻으려면 축마다 \(k\)칸씩 \(k^d\)개 점이 들어, \(d = 50\)에서는 불가능하다.
예제
드문 사건: 중요도 샘플링. 표준정규 \(Z\)에 대해 \(P(Z > 4) \approx 3.17 \times 10^{-5}\)를 어림한다.
- 단순한 방법: 표본 10만 개 중 4를 넘는 것은 평균 3개쯤이다. 20번 되풀이하면 상대 오차가 평균 약 47%로 쓸모가 없다.
- 필요한 표본 수: 확률 \(p\)를 상대 오차 \(r\)로 어림하려면 대략 \(n \approx \frac{1}{pr^2}\)개가 든다. \(p = 10^{-6}\), \(r = 10\%\)면 \(10^8\)개다.
- 중요도 샘플링: 사건이 잘 일어나는 분포 \(\mathcal{N}(4, 1)\)에서 뽑고, 원래 분포와의 밀도 비 \(\frac{\varphi(y)}{\varphi(y - 4)} = e^{-4y + 8}\)를 곱해 보정한다. 기댓값은 그대로이고 분산이 크게 준다.
- 결과: 같은 10만 개로 20번 모두 상대 오차 2% 안이다. 드문 사건이 자주 나오게 뽑고 무게로 되돌리는 것이 핵심이다4.
활용
- 렌더링. 경로 추적은 빛이 튀는 경로를 무작위로 뽑아 조명 적분을 어림한다(몬테카를로 적분).
- 알고리즘 검증. 무작위 입력 수천 개로 구현을 느린 정답 구현과 비교하는 무작위 테스트가 몬테카를로다. 이 지식베이스의 검증 코드도 그렇게 주장을 확인한다. 실험 통과는 증명이 아니고, 틀릴 확률을 줄일 뿐이다.
- 시스템 분석. 대기열 길이, 장애가 겹칠 확률, 금융 위험처럼 식으로 풀기 어려운 양을 시뮬레이션으로 구한다.
- 흔한 실수. 오차 막대 없이 한 번의 결과만 보고하는 것, 난수 씨앗을 고정하지 않아 재현이 안 되는 것.
- 알고리즘에서: 느린 정답 구현으로는 작은 입력에서 경우를 모두 확인하는 완전탐색을 주로 쓴다. 틀리는 입력이 드물면 무작위 입력에 잘 걸리지 않으니, 빈 입력이나 길이 1 같은 경계는 따로 넣는다.
연결
확인 문제
C1 사분원 방법으로 \(\pi\)를 ±0.01 안으로(95%) 어림하려면 점이 대략 몇 개 필요한가?
답: 점 하나의 값 \(Y\)는 확률 \(p = \frac\pi4\)로 4, 아니면 0이라 \(\sigma = 4\sqrt{p(1 - p)} \approx 1.642\). \(1.96\frac{\sigma}{\sqrt n} \le 0.01\)에서 \(n \ge \left(\frac{1.96 \times 1.642}{0.01}\right)^2 \approx 103{,}600\).
C2 몬테카를로의 오차가 차원 수와 상관없는 이유는?
답: 오차는 \(\frac{\sigma}{\sqrt n}\)으로, 표본 하나의 흔들림 \(\sigma\)와 표본 수 \(n\)만으로 정해진다. 표본 하나를 뽑는 데 좌표가 몇 개 필요한지는 식에 들어가지 않는다. 격자 방법은 공간을 빈틈없이 덮어야 해서 점 수가 차원에 따라 거듭제곱으로 늘어난다.
C3 확률이 약 \(10^{-6}\)인 사건을 상대 오차 10%로 단순 몬테카를로로 어림하려면 표본이 대략 몇 개 필요한가?
답: 사건 수는 약 \(np\)개이고 상대 오차는 약 \(\frac{1}{\sqrt{np}}\)다. \(\frac{1}{\sqrt{np}} = 0.1\)에서 \(np = 100\), \(n = 10^8\). 그래서 드문 사건에는 중요도 샘플링 같은 분산 감소 기법을 쓴다.
-
27_monte-carlo_plot.py로 그렸고, 그림에 쓴 값(\(\frac{1.64}{\sqrt n}\)이 1,000·4,000·16,000에서 0.052·0.026·0.013, 모의실험과 12% 안)을 같은 코드로 확인했다. ↩
-
Blitzstein, Hwang, Introduction to Probability 2판, 10.2절(큰 수의 법칙과 몬테카를로), 10.3절(중심극한정리와 오차의 크기). ↩
-
이 문서 정의 절의 식(표본평균과 95% 오차 막대)과 적분으로 쓰기를 순서대로 그렸다. ↩
-
Owen, Monte Carlo Theory, Methods and Examples(온라인 교재), 중요도 샘플링 장. 수치는 27_monte-carlo_verify.py로 확인했다. ↩