서로 독립인 값을 많이 더하거나 평균 내면, 원래 값들이 어떤 모양의 분포를 따르든 합의 분포는 종 모양(정규분포)에 가까워진다. 주사위 하나는 납작한 모양이지만 100개의 합은 거의 완벽한 종이다. 그래서 평균의 오차를 정규분포로 계산할 수 있고, 오차 막대·신뢰구간·A/B 테스트가 모두 이 위에 서 있다. 다만 값들의 분산이 유한해야 하고, 한쪽으로 치우친 분포나 먼 꼬리의 확률은 꽤 많이 더해야 정규 근사가 맞는다.
예시로 보기
주사위 \(n\)개의 합을 표준화해(\(\frac{\text{합} - \text{평균}}{\text{표준편차}}\)) 표준정규분포와 비교한다. 두 CDF의 가장 큰 차이는 이렇게 준다.
| 주사위 수 \(n\) | 1 | 2 | 10 | 100 |
|---|---|---|---|---|
| 정규분포와의 최대 CDF 차이 | 0.054 | 0.016 | 0.0026 | 0.0003 |
주사위 하나는 1~6이 균등한 납작한 모양인데, 합은 금방 종 모양이 된다. 주사위 하나가 아래 정리의 \(X_i\), 합을 표준화한 것이 \(Z_n\)이다.
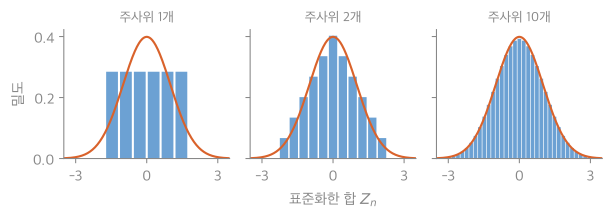
막대는 합을 표준화한 정확한 분포(막대 넓이 = 확률)이고, 주황 곡선은 표준정규분포다. 주사위 2개만 더해도 삼각형 모양이 되고, 10개면 곡선과 거의 겹친다1.
정의
\(X_1, X_2, \dots\)가 서로 독립이고 분포가 같으며, 평균 \(\mu\), 분산 \(0 < \sigma^2 < \infty\)이면, 표준화한 표본평균
\[Z_n = \frac{\bar X_n - \mu}{\sigma/\sqrt n} = \frac{X_1 + \cdots + X_n - n\mu}{\sigma\sqrt n}\]은 모든 실수 \(z\)에서 \(P(Z_n \le z) \to \Phi(z)\) \((n \to \infty)\)를 만족한다2.
실용적으로는 “\(n\)이 크면 \(\bar X_n\)은 대략 \(\mathcal{N}\left(\mu, \frac{\sigma^2}{n}\right)\), 합은 대략 \(\mathcal{N}(n\mu, n\sigma^2)\)“로 쓴다. \(\frac{\sigma}{\sqrt n}\)을 표준오차라 한다. 증명은 적률생성함수로 한다 [증명 생략: Blitzstein·Hwang 10.3절].
\(\sqrt n\)으로 나누는 이유. 큰 수의 법칙에서 \(\bar X_n - \mu\)는 0으로 줄어든다. 그 크기가 \(\frac{\sigma}{\sqrt n}\) 정도라서, 이만큼 확대해야 0으로 뭉개지지도 무한히 퍼지지도 않는 모양이 보인다. 중심극한정리는 그 확대된 모양이 늘 정규분포라는 말이다.
가정과 그 필요성.
| 가정 | 빠지면 |
|---|---|
| 분산 유한 | 코시 분포는 500개를 평균 내도 다시 코시 분포라, \(\lvert\bar X\rvert > 3\)일 확률이 약 0.2로 남는다. 정규분포로 모이지 않는다 |
| 독립 | 동전 하나를 500번 복사해 더하면 합은 0 아니면 500이다. 몇 개를 더해도 두 값뿐이다 |
| 같은 분포 | 완화할 수 있다. 분포가 달라도 어느 하나가 합을 좌우하지만 않으면 정규분포로 간다(린데베르크 조건)3 |
수렴 속도. 치우친 분포일수록 느리다. 지수분포 \(n\)개의 평균이 “표준편차 2개 위”를 넘을 확률의 참값은 \(n = 5, 50, 500\)에서 0.041, 0.030, 0.025로, 정규분포의 0.0228에 천천히 다가간다. 주사위(대칭)보다 훨씬 느리다.
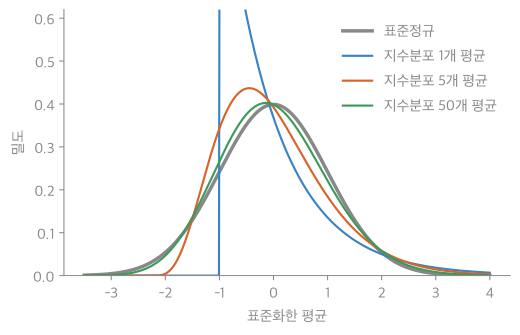
지수분포 하나(파랑)는 오른쪽으로 꼬리가 길게 치우쳐 있다. 5개를 평균 내도 봉우리가 왼쪽으로 쏠려 있고, 50개쯤 되어야 회색 정규 곡선에 가까워진다1.
스스로 설명해 보기
1. \(Z_n\)의 두 표현이 같은 이유는?
\(\bar X_n - \mu = \frac{(X_1 + \cdots + X_n) - n\mu}{n}\)이다. 이것을 \(\frac{\sigma}{\sqrt n}\)으로 나누면 분모가 \(n \cdot \frac{\sigma}{\sqrt n} = \sigma\sqrt n\)이 된다.
2. \(Z_n\)의 평균과 분산은 \(n\)과 상관없이 얼마인가? 왜 그렇게 맞추는가?
평균 0, 분산 1이다. 합의 평균 \(n\mu\)를 빼고 표준편차 \(\sigma\sqrt n\)으로 나눴기 때문이다. 크기를 고정해야 모양만 비교할 수 있다.
3. 이 정리의 핵심 아이디어는?
독립인 것들을 더하면 각자의 개성(치우침, 뾰족함)은 서로 상쇄되어 사라지고, 평균과 분산만 남는다. 평균과 분산만으로 정해지는 모양이 정규분포다.
4. 같은 현상이 다른 과목에서는 어떻게 보이는가?
독립인 확률변수의 합의 밀도는 밀도들의 합성곱이다. 어떤 함수든 자기 자신과 여러 번 합성곱하면 가우스 모양으로 번진다. 이미지를 작은 흐림 필터로 여러 번 흐리면 가우스 흐림이 되는 것과 같은 현상이다.
예제
주사위 100개의 합이 380 이상일 확률.
- 평균과 표준편차: 주사위 하나는 평균 3.5, 분산 \(\frac{35}{12}\). 합은 평균 350, 표준편차 \(\sqrt{100 \times \frac{35}{12}} \approx 17.08\).
- 연속성 보정: 합은 정수라 “380 이상”을 연속 분포에서는 “379.5 이상”으로 본다.
- 표준화: \(z = \frac{379.5 - 350}{17.08} \approx 1.73\), \(1 - \Phi(1.73) \approx 0.0421\).
- 검산: 합의 정확한 분포(합성곱 100번)로 계산하면 0.04203이다. 근사가 소수 넷째 자리까지 맞는다.
활용
- 오차 막대와 신뢰구간. 표본평균 ± \(1.96 \times\) 표준오차가 약 95%의 확률로 참 평균을 담는다(신뢰구간).
- A/B 테스트. 두 그룹의 전환율 차이가 우연으로 설명될 크기인지를, 차이의 표준오차로 표준화해 정규분포로 판단한다(가설검정).
- 이항분포의 정규 근사. \(\mathrm{Bin}(100, 0.5)\)에서 \(P(X \ge 60)\)은 정확히 0.0284, 연속성 보정 정규 근사로 0.0287이다.
- 몬테카를로의 오차. 표본 \(n\)개의 평균으로 어림한 값의 오차는 약 \(\frac{\sigma}{\sqrt n}\)이다. 오차를 10분의 1로 줄이려면 표본이 100배 필요하다.
연결
자주 하는 오해
틀렸다. “표본이 크면 정규분포”라는 말만 기억하면 이렇게 오해하기 쉽다. 중심극한정리는 합과 평균의 분포에 대한 말이다. 지수분포에서 20만 개를 뽑아도 자료의 히스토그램은 여전히 한쪽으로 치우친 지수분포 모양이다(왜도 약 2). 정규분포에 가까워지는 것은 “그런 자료의 평균을 여러 번 구했을 때 평균들의 분포”다.
확인 문제
C1 주사위 100개의 합이 380 이상일 확률을 정규 근사로 구하라.
답: 평균 350, 표준편차 \(\sqrt{100 \times 35/12} \approx 17.08\). 연속성 보정으로 \(z = \frac{379.5 - 350}{17.08} \approx 1.73\), \(1 - \Phi(1.73) \approx 0.042\). 정확한 값 0.04203과 거의 같다.
C2 공정한 동전 100번에서 앞면이 60번 이상일 확률을 정규 근사로 구하라.
답: 평균 50, 표준편차 5. \(z = \frac{59.5 - 50}{5} = 1.9\), \(1 - \Phi(1.9) \approx 0.0287\). 정확한 값은 0.0284.
C3 표본평균의 오차가 \(\frac{1}{n}\)이 아니라 \(\frac{1}{\sqrt n}\)에 비례하는 이유는?
답: 독립인 \(n\)개의 합은 분산이 \(n\)배라 표준편차가 \(\sqrt n\)배다. 평균은 합을 \(n\)으로 나누므로 표준편차가 \(\frac{\sqrt n}{n} = \frac{1}{\sqrt n}\)배가 된다. 독립인 오차들이 서로 일부만 상쇄되기 때문이다.
C4 중심극한정리의 가정 중 하나를 빼서 합이 정규분포로 가지 않는 예를 들어라.
답: (가) 분산 무한: 코시 분포의 평균은 몇 개를 모아도 같은 코시 분포다. (나) 독립이 아님: 동전 하나를 \(n\)번 복사한 합은 0 아니면 \(n\)의 두 값뿐이다.
-
22_clt_plot.py로 그렸고, 그림에 쓴 값(예시 표의 최대 CDF 차이, 지수분포 평균의 꼬리 확률 0.041·0.030·0.025)을 같은 코드로 확인했다. ↩ ↩2
-
Blitzstein, Hwang, Introduction to Probability 2판, 10.3절 “Central limit theorem”(진술, 적률생성함수를 이용한 증명, 이항분포의 정규 근사와 연속성 보정). ↩
-
분포가 같지 않은 독립 합의 중심극한정리(린데베르크–펠러 정리)는 측도론적 확률 교재, 예를 들어 Billingsley, Probability and Measure의 중심극한정리 절에서 다룬다. 이 과정에서는 진술만 소개한다. ↩