추정값 하나만 말하지 않고, “참값은 아마 이 범위 안에 있다”는 구간으로 불확실성을 함께 보고하는 방법이다. 표본이 많을수록 구간이 좁아지는데, 폭은 표본 수의 제곱근에 반비례한다. 95% 신뢰구간이란 같은 방법으로 구간을 여러 번 만들면 그중 95%가 참값을 담는다는 뜻이다. 이미 만든 구간 하나에 참값이 있을 확률이 95%라는 뜻이 아니라서, 흔히 잘못 읽는다.
예시로 보기
평균 50, 표준편차 8인 정규분포에서 30개씩 표본을 뽑아 “표본평균 ± \(1.96 \times \frac{8}{\sqrt{30}}\)” 구간을 1,000번 만든다. 구간마다 위치가 다르고, 그중 약 950개가 50을 담는다. 50을 놓친 구간도 만든 사람은 그 사실을 모른다.
“± 뒤의 값”이 아래 정의의 오차 한계, 95%가 신뢰수준 \(1 - \alpha\)다.
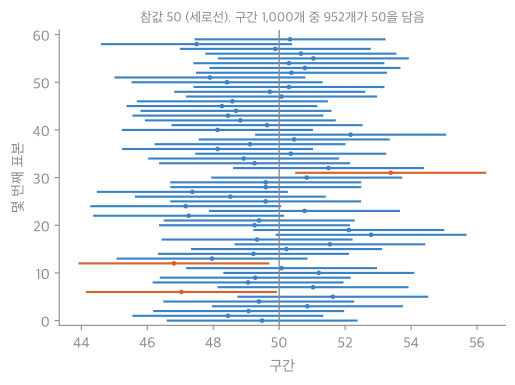
구간 1,000개 중 앞의 60개를 그렸다. 세로선이 참값 50이고, 주황 구간이 50을 놓친 것이다. 놓친 구간도 겉보기에는 다른 구간과 다를 바 없다1.
정의
자료로 계산한 구간 \((L, U)\)가 모수 \(\theta\)의 신뢰수준 \(1 - \alpha\) 신뢰구간이라는 것은, 모든 \(\theta\)에서
\[P_\theta(L \le \theta \le U) \ge 1 - \alpha\]라는 뜻이다. 확률은 무작위인 \(L, U\)에 대한 것이고 \(\theta\)는 고정된 수다2.
자주 쓰는 구간.
| 상황 | 구간 |
|---|---|
| 평균, \(\sigma\)를 앎 | \(\bar x \pm z_{\alpha/2}\frac{\sigma}{\sqrt n}\) (95%면 \(z = 1.96\)) |
| 평균, \(\sigma\)를 모르고 \(n\)이 큼 | \(\bar x \pm 1.96\frac{s}{\sqrt n}\) (중심극한정리) |
| 평균, \(\sigma\) 모름, \(n\) 작음, 정규 모집단 | \(\bar x \pm t_{n-1,\,\alpha/2}\frac{s}{\sqrt n}\) (\(t\)분포 분위수) |
| 비율 | \(\hat p \pm 1.96\sqrt{\frac{\hat p(1 - \hat p)}{n}}\) (\(n\)이 크고 \(\hat p\)가 0이나 1에 가깝지 않을 때) |
\(\sigma\) 대신 표본 표준편차 \(s\)를 쓰면 \(s\)도 흔들리는 만큼 구간을 넓혀야 한다. 그 보정이 \(t\)분포다3. 표본 5개에서 1.96을 쓰면 적중률이 95%가 아니라 약 88%로 떨어지고, \(t_{4} = 2.776\)을 쓰면 95%가 맞는다.
flowchart TD
    S["표본 n개에서 표본평균 x̄ 계산"] --> Q1{"모집단 σ를 아는가"}
    Q1 -->|"예"| Z["z 분위수와 σ/√n"]
    Q1 -->|"아니오"| Q2{"n이 큰가"}
    Q2 -->|"예"| Z2["1.96과 s/√n"]
    Q2 -->|"아니오, 모집단이 정규"| T["자유도 n-1인 t 분위수와 s/√n"]
    Z --> I["x̄ ± 분위수 × 표준오차"]
    Z2 --> I
    T --> I
질문 두 개로 분위수와 표준오차를 고른 뒤, 마지막 칸의 같은 모양으로 구간을 만든다.4
예제
벤치마크 결과 보고. 실행 시간을 25번 재서 평균 120 ms, 표본 표준편차 10 ms를 얻었다.
- 표준오차: \(\frac{10}{\sqrt{25}} = 2\) ms.
- 정규 근사 구간: \(120 \pm 1.96 \times 2 = [116.1, 123.9]\) ms.
- \(t\) 구간: 자유도 24의 97.5% 분위수 \(t \approx 2.064\)로 \([115.9, 124.1]\) ms. 조금 넓다.
- 보고: “120 ± 4 ms(95% 신뢰구간, 25회)”. 반복을 100회로 늘리면 폭이 절반이 된다.
활용
- 실험 결과 보고. 성능 측정, A/B 테스트의 전환율 차이는 점 하나가 아니라 구간으로 보고한다. 두 구간이 크게 겹치면 차이를 장담할 수 없다(가설검정).
- 표본 크기 정하기. 원하는 오차 한계 \(m\)에서 \(n = \left(\frac{1.96\sigma}{m}\right)^2\)로 필요한 측정 횟수를 거꾸로 구한다.
연결
자주 하는 오해
틀렸다(빈도주의 해석에서). 계산이 끝난 구간은 고정된 두 수이고, 참 평균도 고정된 수라서, 들어 있거나 아니거나 둘 중 하나다. 95%는 구간을 만드는 방법의 성질이다. 이 방법을 되풀이하면 구간의 95%가 참값을 담는다. “참값이 이 구간에 있을 확률”을 말하고 싶으면 사전 분포를 두는 베이즈 신용구간을 써야 한다.
확인 문제
C1 사용자 400명 중 80명이 버튼을 눌렀다. 클릭률의 95% 신뢰구간은?
답: \(\hat p = 0.2\), 표준오차 \(\sqrt{\frac{0.2 \times 0.8}{400}} = 0.02\). \(0.2 \pm 1.96 \times 0.02 = [0.161, 0.239]\).
C2 “신뢰수준 95%”를 올바르게 설명하라.
답: 같은 방법으로 새 표본을 뽑아 구간을 계속 만들면, 그렇게 만든 구간들의 95%가 참값을 포함한다는 뜻이다. 확률은 구간(표본에 따라 바뀜)에 걸린 것이지 고정된 참값에 걸린 것이 아니다.
C3 표준편차가 약 10 ms인 측정에서 95% 오차 한계를 ±1 ms로 하려면 몇 번 재야 하는가?
답: \(1.96 \times \frac{10}{\sqrt n} \le 1\)에서 \(n \ge 384.16\), 곧 385번.
-
31_confidence-intervals_plot.py로 그렸고, 그림에 쓴 값(오차 한계 2.863, 구간 1,000개 중 952개가 50을 담음)을 같은 코드로 확인했다. ↩
-
Wasserman, All of Statistics, “Models, Statistical Inference and Learning” 장(신뢰집합의 정의와 해석, 정규 근사 구간). ↩
-
Blitzstein, Hwang, Introduction to Probability 2판, 10.4절 “Chi-Square and Student-t”(\(t\)분포). ↩
-
이 문서의 ‘자주 쓰는 구간’ 표 가운데 평균의 세 줄을 고르는 순서로 그렸다. ↩