두꺼운 사전에서 단어를 찾을 때 가운데를 펼쳐 앞쪽인지 뒤쪽인지 보고, 절반을 통째로 버리는 것과 같다. 한 번 볼 때마다 찾을 곳이 절반으로 줄어서 100만 개 중에서도 20번이면 찾는다. 대신 정렬된 곳에서만 쓸 수 있다. 그리고 끝을 넣을지 뺄지, 같을 때 어느 쪽으로 갈지를 조금만 잘못 잡아도 한 칸 어긋나거나 끝나지 않는다.
예시로 보기
정렬된 [2, 4, 4, 7, 9, 12, 15, 20]에서 “7 이상인 첫 위치”를 찾는다. 찾는 구간을 [lo, hi)로 둔다. lo는 구간의 첫 번호, hi는 구간 바로 뒤 번호다.
| 단계 | lo | hi | mid | a[mid] | a[mid] < 7? | 다음 |
|---|---|---|---|---|---|---|
| 1 | 0 | 8 | 4 | 9 | 아니오 | hi = 4 (답은 4 이하) |
| 2 | 0 | 4 | 2 | 4 | 예 | lo = 3 (답은 3 이상) |
| 3 | 3 | 4 | 3 | 7 | 아니오 | hi = 3 |
| 끝 | 3 | 3 | lo == hi → 답 3 |
a[3] = 7이다. 8칸짜리를 세 번 만에 찾았다. 7이 없고 6을 찾았다면 같은 과정으로 “6 이상인 첫 위치” 3을 돌려준다. 그러면 “6보다 작은 수가 3개 있다”는 뜻도 된다.
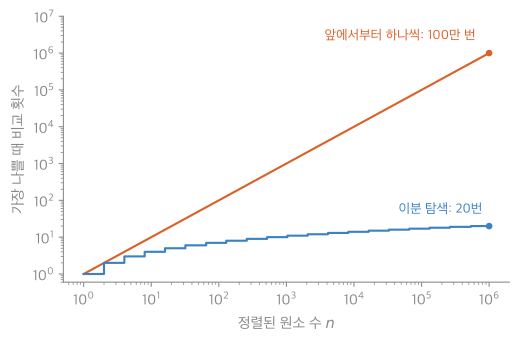
가로·세로 모두 10배마다 한 칸인 눈금이다. 원소가 10배 늘면 처음부터 훑는 방법은 비교도 10배 늘지만, 이분 탐색은 3~4번만 는다. 100만 개에서 하나씩 보면 100만 번, 이분 탐색은 20번이다1.
정의
- 입력: 오름차순으로 정렬된 리스트 \(a[0..n-1]\) (\(n \ge 0\))와 값 \(x\).
- 출력: \(a[i] \ge x\)인 가장 작은 번호 \(i\). 그런 번호가 없으면 \(n\). 이 값은 “x보다 작은 원소의 개수”와 같다(lower bound).
lower_bound(a, x):
    lo ← 0, hi ← n
    while lo < hi:
        mid ← ⌊(lo + hi) / 2⌋
        if a[mid] < x: lo ← mid + 1
        else:          hi ← mid
    return lo
증명
전략은 루프 불변식이다. 매 바퀴 시작마다 참인 성질을 하나 정하고, 처음에 참이고(초기화), 한 바퀴를 돌아도 참으로 남으며(유지), 끝날 때 답을 알려 줌(종료)을 보인다2.
매 바퀴 시작에 다음이 참이다: \(a[0..lo-1]\)의 원소는 모두 \(x\)보다 작고, \(a[hi..n-1]\)의 원소는 모두 \(x\) 이상이며, \(0 \le lo \le hi \le n\)이다.
 번호   0         lo-1   lo        hi-1   hi        n-1
       +-------------+------------------+-------------+
       | 모두 x 미만 |    아직 모른다   | 모두 x 이상 |
       +-------------+------------------+-------------+
                     ^                  ^
                    lo                 hi
가운데 “아직 모른다” 구간만 매 바퀴 절반쯤으로 줄고, 양쪽 구간은 늘기만 한다. 가운데가 비면(lo == hi) 두 구간의 경계 lo가 답이다3.
증명 펼치기
- 초기화: lo = 0, hi = n이면 \(a[0..-1]\)과 \(a[n..n-1]\)은 빈 구간이라 조건이 저절로 참이다.
- 유지: lo < hi이면 \(lo \le mid < hi\)다(정수 나눗셈이 내림이기 때문).
- \(a[mid] < x\)이면: 정렬되어 있으니 \(a[lo..mid]\)는 모두 \(a[mid]\) 이하, 곧 \(x\)보다 작다. lo를 mid + 1로 옮겨도 “왼쪽은 모두 \(x\) 미만”이 지켜진다.
- \(a[mid] \ge x\)이면: 정렬되어 있으니 \(a[mid..hi-1]\)은 모두 \(x\) 이상이다. hi를 mid로 옮겨도 “오른쪽은 모두 \(x\) 이상”이 지켜진다.
- 끝난다: 매 바퀴 hi − lo가 적어도 1 줄어든다(mid + 1 > lo, mid < hi). 그래서 언젠가 lo == hi가 된다.
- 종료: lo == hi이면 불변식에 따라 \(a[0..lo-1]\)은 모두 \(x\) 미만, \(a[lo..n-1]\)은 모두 \(x\) 이상이다. 그래서 lo가 “\(x\) 이상인 첫 번호”다. ∎
스스로 설명해 보기
1. hi = mid에서 mid + 1이 아니라 mid인 까닭은?
a[mid] ≥ x이면 mid 자체가 답일 수 있다. hi는 “여기부터는 모두 x 이상”이라는 경계라서, 답 후보인 mid를 버리지 않으려면 hi = mid로 둔다.
2. lo = mid + 1에서 mid가 아니라 mid + 1인 까닭은?
a[mid] < x이면 mid는 답이 될 수 없다. 그래서 mid까지 버린다. 만약 lo = mid로 두면 hi = lo + 1일 때 mid = lo라서 lo가 그대로여서 끝나지 않는다.
3. 반복이 약 log₂ n번인 까닭은?
한 바퀴마다 구간 hi − lo가 절반 이하로 준다. n을 절반씩 줄여 1 아래로 가려면 로그의 뜻 그대로 약 log₂ n번이면 된다. 정확히는 많아야 ⌈log₂(n + 1)⌉번이다.
이 증명의 핵심 아이디어는?
“왼쪽은 모두 작다, 오른쪽은 모두 크거나 같다”는 두 경계를 지키며 가운데를 좁힌다. 좁힐 때 버리는 쪽에 답이 없다는 것을 정렬이 보장한다.
같은 방법을 쓸 수 있는 다른 상황은?
“어떤 값 이상에서는 늘 참, 그 아래에서는 늘 거짓”인 성질이면 무엇이든 경계를 찾을 수 있다. 답 자체를 이 방식으로 찾는 것이 매개변수 탐색이다.
파이썬의 bisect
파이썬에는 이 함수가 이미 있다4.
| 코드 | 돌려주는 값 | 뜻 |
|---|---|---|
bisect_left(a, x) |
x 이상인 첫 번호 | x보다 작은 원소 수 |
bisect_right(a, x) |
x 초과인 첫 번호 | x 이하인 원소 수 |
bisect_right(a, x) - bisect_left(a, x) |
x의 개수 | |
bisect_right(a, R) - bisect_left(a, L) |
L 이상 R 이하인 원소 수 | |
len(a) - bisect_left(a, x) |
x 이상인 원소 수 |
lower_bound를 무작위 정렬 리스트 5,000개(길이 0~40, 겹치는 값 포함)에서 bisect_left와 처음부터 세는 방법과 비교해 모두 같았다. 반복 횟수가 늘 ⌈log₂(n + 1)⌉ 이하임, 예시 표의 lo·hi·mid 값, bisect 표의 공식, 정렬되지 않은 리스트에서 틀리는 반례, lo = mid로 쓰면 끝나지 않는 입력도 확인했다 — 20_binary-search_impl.py활용
- 비용: 위의 방식은 값을 찾아도 중간에 멈추지 않고 늘 약 log₂ n번 돈다. 그래서 최선·평균·최악 모두 \(O(\log n)\)이고, 추가 공간은 \(O(1)\)이다. 정렬이 안 되어 있으면 먼저 정렬해야 하니 \(O(n \log n)\)이 한 번 든다. 질문이 많을수록 이득이다.
- 쓰는 곳: 정렬된 목록에서 “x 이상이 몇 개”, “구간 안에 몇 개”, 사전순으로 가장 가까운 단어, 데이터베이스 색인(B-트리의 각 노드 안),
git bisect(어느 커밋부터 버그가 생겼나). - 고르는 기준: “있나 없나”만 물으면 집합이 더 간단하고 빠르다. “몇 개가 x 이상인가”, “가장 가까운 값”처럼 크기 순서가 필요하면 정렬 + 이분 탐색이다.
- 흔한 실수: 정렬하지 않고 쓴다.
while lo <= hi와hi = mid처럼 서로 다른 방식을 섞어 끝나지 않는다. 답이 없을 때(n을 돌려줄 때)a[lo]를 바로 꺼내 범위를 넘는다.
연결
- 선수: 정렬과 정렬 기준, 로그
- 비교: 정렬된 두 수의 합은 투 포인터로도 찾는다. 한 번의 질문에는 이분 탐색, 한 번 훑으며 여러 짝을 찾을 때는 투 포인터가 알맞다.
- 연습: 순위 검색, 가사 검색
- 예·아니오 비교로 찾는 방법은 이분 탐색보다 적게 물을 수 없다. 답이 될 수 있는 자리는 0 ~ n의 n + 1가지이고, 비교 한 번은 예·아니오 하나다. 그래서 가장 나쁜 경우 ⌈log₂(n + 1)⌉번은 물어야 하고(진법과 자릿수의 정리 2), 이분 탐색은 딱 그만큼 묻는다. 자리마다 답일 가능성이 같으면 평균으로도 log₂(n + 1)번보다 적게 물을 수 없다(엔트로피).
- 루프 불변식 증명은 반복 횟수에 대한 수학적 귀납법이다. 초기화가 기저, 유지가 귀납 단계다. 끝나는지는 귀납이 알려 주지 않아 따로 보인다. hi − lo는 0 이상의 정수라서 매 바퀴 줄면 끝없이 줄 수 없다.
- 방정식의 근을 찾는 이분법도 같은 틀이다. “양 끝 값의 부호가 서로 다르다”를 지키며, 가운데 값의 부호를 보고 절반을 버린다. 다만 정렬은 “버린 쪽에 답이 없다”를 보장하고, 연속은 “남긴 쪽에 근이 있다”만 보장한다(버린 쪽에도 근이 있을 수 있다).
- 정렬한 자료 xs에서
bisect_right(xs, x) / len(xs)는 x 이하인 자료의 비율, 곧 기술통계의 경험적 분포함수다. 거꾸로 쓰면 가중치대로 하나를 무작위로 뽑는다. 가중치의 누적 합에서 0과 합 사이 균등 난수보다 큰 첫 칸을bisect_right로 찾으면 되고, 파이썬random.choices가 이렇게 한다. 비율이 맞는 까닭은 균등분포와 지수분포의 역변환이다. - 함께 보면 좋은 수학: 분할 정복 점화식과 마스터 정리(한 바퀴에 절반만 남기는 비용을 점화식으로 쓰면 T(n) = T(n/2) + O(1)이다)
- 브리지: 수학적 귀납법 ↔ 루프 불변식
자주 하는 오해
lo = mid로 옮겨도 결국 좁혀진다”틀렸다. mid = ⌊(lo + hi) / 2⌋라서 hi = lo + 1일 때 mid = lo다. 이때 lo = mid는 lo를 그대로 두어 영원히 돈다. 절반씩 줄어드니 결국 끝날 것 같지만, 정수 나눗셈의 내림 때문에 마지막 두 칸에서 줄지 않는다. 확인하려면 [1, 3]에서 3을 찾아 보면 된다. lo = 0, hi = 1에서 멈추지 않는다. 규칙은 “답이 될 수 없는 쪽은 mid까지 버린다(mid + 1), 답이 될 수 있는 쪽은 mid를 남긴다(mid)”이다.
과목별 관점
데이터베이스 설계 (2-2학기). 이분 탐색이 더 큰 자료구조의 부품으로 쓰이는 예가 B-트리다. B-트리의 노드 하나에는 정렬된 키가 여러 개 들어 있다. 많아야 \(2t - 1\)개이고, \(t\)는 그 트리에서 정해 둔 수(최소 차수)다. 검색은 노드마다 “찾는 키 이상인 첫 키의 자리”를 구해, 그 키가 찾는 키가 아니면 그 자리의 자식으로 내려간다. 이 자리가 위 정의의 lower bound 그대로다.
노드 안을 앞에서부터 하나씩 훑으면 노드 하나에 \(O(t)\)가 든다. 지나는 노드가 \(O(\log_t n)\)개라 검색 전체는 \(O(t \log_t n)\)이다. 여기서 \(n\)은 트리에 담긴 키의 수다. 노드 안에서 이분 탐색을 쓰면 노드 하나에 \(O(\lg t)\)만 든다.
\[O(\lg t \cdot \log_t n) = O\!\left(\lg t \cdot \frac{\lg n}{\lg t}\right) = O(\lg n)\]\(\lg t\)가 약분되어 \(t\)를 얼마로 잡든 \(O(\lg n)\)이다. 줄어드는 것은 주기억장치 안에서 견주는 횟수다. 디스크에서 읽어 오는 노드의 수는 그대로다5. 절차와 실험값은 B-트리 검색에 있다.
확인 문제
C1 [1, 3, 3, 3, 8]에서 bisect_left(a, 3)과 bisect_right(a, 3)의 값, 그리고 3의 개수는?
답: 1과 4, 개수는 4 − 1 = 3개다. 3 이상인 첫 번호가 1, 3 초과인 첫 번호가 4다.
C2 다음 코드가 하는 일을 한 문장으로 말하라.
def f(a, x):
    lo, hi = 0, len(a)
    while lo < hi:
        mid = (lo + hi) // 2
        if a[mid] <= x: lo = mid + 1
        else: hi = mid
    return lo
답: 정렬된 a에서 x보다 큰 첫 번호, 즉 x 이하인 원소의 개수를 돌려준다(bisect_right와 같다). <가 <=로 바뀌어 같은 값도 왼쪽으로 넘긴다.
C3 이분 탐색이 정렬된 곳에서만 맞는 까닭을 불변식으로 설명하라.
답: a[mid] < x일 때 “mid까지 왼쪽은 모두 x보다 작다”고 보고 버린다. 이것은 a[lo..mid]가 a[mid] 이하라는 정렬 성질 덕분이다. 정렬되지 않으면 mid 왼쪽에 x 이상인 수가 있을 수 있어, 버린 쪽에 답이 남는다.
C4 정렬되지 않은 리스트에서 bisect_left가 틀린 답을 내는 예를 들어라.
답: a = [5, 1, 3], x = 5. 답(5 이상인 첫 번호)은 0이다. 하지만 mid = 1에서 a[1] = 1 < 5라 lo = 2로 가고, a[2] = 3 < 5라 lo = 3이 되어 3을 돌려준다.
C5 최소 차수 \(t = 512\)인 B-트리의 한 노드에 정렬된 키가 1,023개 들어 있다. 이 노드에서 “찾는 키 이상인 첫 키의 자리”를 이분 탐색으로 구하면 많아야 몇 번 견주는가? 앞에서부터 하나씩 견주면 많아야 몇 번인가? 이분 탐색으로 바꾸면 디스크를 읽는 횟수도 줄어드는가?
답: 이분 탐색은 많아야 10번, 하나씩 견주면 많아야 1,023번이다. 디스크를 읽는 횟수는 줄지 않는다.
이유: lower_bound는 길이 \(n\)인 리스트에서 많아야 \(\lceil \log_2(n + 1) \rceil\)번 돈다. \(\lceil \log_2 1024 \rceil = 10\)이다. 디스크는 노드를 하나 내려갈 때마다 한 번 읽는데, 노드 안에서 찾는 방법을 바꿔도 지나는 노드는 같다5.
-
20_binary-search_plot.py로 그렸고, n = 1 ~ 2,048에서 답이 될 수 있는 모든 자리를 넣어 본 가장 많은 반복 횟수가 ⌈log₂(n + 1)⌉과 같다는 것, 예시의 8칸에서 3번, 100만 개에서 20번이라는 것을 같은 코드로 확인했다. ↩
-
루프 불변식의 세 단계(초기화·유지·종료)는 Cormen·Leiserson·Rivest·Stein, Introduction to Algorithms 3판, 2.1절의 방식을 따랐다. 이분 탐색 자체는 Laaksonen, Competitive Programmer’s Handbook (2018년 7월판), 3.3 “Binary search”. ↩
-
‘증명’ 절의 루프 불변식과 증명 4단계(종료)를 배열 구간 그림으로 옮겼다. ↩
-
Python 3 표준 라이브러리 문서, “bisect — Array bisection algorithm”의
bisect_left,bisect_right. ↩ -
키 1,023개짜리 노드에서 가장 많이 견준 횟수(이분 탐색 10번, 하나씩 1,023번)는 13_b-tree-search_impl.py로 확인했다. ↩ ↩2