모르는 모수를 하나의 정해진 값이 아니라 “얼마나 그럴듯한가”의 분포로 보고, 데이터를 볼 때마다 베이즈 정리로 그 분포를 갱신한다. 원래 믿음(사전분포)에 데이터의 가능도를 곱하면 새 믿음(사후분포)이 된다. 사후분포의 봉우리(MAP)는 가능도에 벌점 항을 더해 최대화한 것이라, 기계학습의 정칙화와 같은 계산이다. 데이터가 적을 때 극단적인 답을 막아 주지만, 사전분포를 어떻게 잡느냐에 따라 결과가 달라진다.
예시로 보기
새 동전을 세 번 던져 세 번 모두 앞면이 나왔다. 최대가능도는 앞면 확률을 1로 추정한다. “다음에도 반드시 앞면”이라는 답은 믿기 어렵다.
앞면 확률 \(p\)를 모르니 처음에는 0과 1 사이 어디든 같은 정도로 그럴듯하다고 두자(균등 사전분포). 세 번의 앞면을 반영하면 사후분포의 평균은 \(\frac{3 + 1}{3 + 2} = 0.8\)이다. 앞면 쪽으로 기울었지만 1까지 가지는 않는다. 균등분포가 아래의 사전분포 \(\mathrm{Beta}(1, 1)\), 0.8이 사후 평균이다.
정의
적용 조건. 모수에 대한 사전 지식이나 합리적인 기본값이 있고, 모수의 불확실성 자체를 확률로 말하고 싶을 때.
모수 \(\theta\)의 사전분포 \(\pi(\theta)\)와 가능도 \(L(\theta) = f(\text{자료} \mid \theta)\)에서, 베이즈 정리로 사후분포는
\[\pi(\theta \mid \text{자료}) = \frac{L(\theta)\,\pi(\theta)}{\int L(t)\,\pi(t)\,dt} \propto L(\theta)\,\pi(\theta)\]이다. 사후분포의 최빈값 \(\hat\theta_{\text{MAP}} = \arg\max_\theta L(\theta)\pi(\theta)\)를 MAP 추정값이라 한다1.
베타–이항 켤레. 사전분포가 \(\mathrm{Beta}(a, b)\)(밀도 \(\propto p^{a-1}(1 - p)^{b-1}\))이고 \(n\)번 중 \(k\)번 성공하면, 사후분포는 \(\mathrm{Beta}(a + k, b + n - k)\)다. 가능도 \(p^k(1 - p)^{n-k}\)를 곱하면 지수만 더해지기 때문이다. 사전분포와 사후분포가 같은 종류라 켤레라 한다2.
| 요약 | 값 |
|---|---|
| 사후 평균 | \(\frac{a + k}{a + b + n}\) |
| MAP | \(\frac{a + k - 1}{a + b + n - 2}\) |
| MLE(비교) | \(\frac kn\) |
\(a, b\)는 “미리 본 가상의 성공·실패 수”처럼 작동한다. \(n\)이 커지면 \(k\)와 \(n\)이 압도해 사후 평균이 MLE로 다가간다.
flowchart LR
    P["사전분포 Beta(a, b)"] -->|"n번 중 k번 성공의 가능도를 곱함"| Q["사후분포 Beta(a + k, b + n - k)"]
    Q --> S["요약: 사후 평균, MAP, 신용구간"]
    Q -.->|"새 자료가 오면 다음 사전분포"| P
점선처럼 오늘의 사후분포가 다음 자료의 사전분포가 된다. 베타 분포 안에서 두 모수에 성공 수와 실패 수만 더하면 된다.3
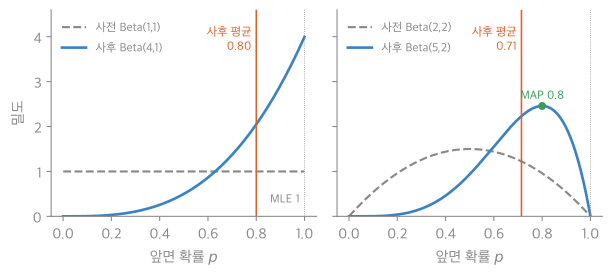
같은 자료(세 번 모두 앞면)를 두 사전분포로 갱신한 결과다. 균등 사전(왼쪽)이면 사후분포의 봉우리는 1이지만 평균은 0.8이다. \(\mathrm{Beta}(2, 2)\) 사전(오른쪽)은 가운데를 더 믿어서, 사후 봉우리(MAP)가 0.8, 평균이 0.71로 1에서 더 멀다4.
신용구간. 사후분포에서 확률 95%를 담는 구간이다. “모수가 이 구간에 있을 확률이 95%”라고 읽어도 된다. 이것이 신뢰구간과의 차이다.
예제
MAP = 릿지 회귀. 선형 모델 \(\mathbf{y} = X\mathbf{w} + \boldsymbol\varepsilon\), 잡음 \(\varepsilon_i \sim \mathcal{N}(0, \sigma^2)\)(\(X \sim\) 분포는 “\(X\)가 그 분포를 따른다”), 가중치의 사전분포 \(w_j \sim \mathcal{N}(0, \tau^2)\)(독립).
- 음의 로그 사후: \(-\ln L - \ln\pi = \frac{1}{2\sigma^2}\Vert \mathbf{y} - X\mathbf{w}\Vert ^2 + \frac{1}{2\tau^2}\Vert \mathbf{w}\Vert ^2 + \text{상수}\)(\(\lVert\cdot\rVert\)는 벡터의 길이).
- MAP: 이것을 최소화하는 것은 \(\Vert \mathbf{y} - X\mathbf{w}\Vert ^2 + \lambda\Vert \mathbf{w}\Vert ^2\), \(\lambda = \frac{\sigma^2}{\tau^2}\)을 최소화하는 것과 같다.
- 해: 행렬 미분의 릿지 해 \((X^\top X + \lambda I)\mathbf{w} = X^\top\mathbf{y}\)(\(^\top\)는 행과 열을 바꾸는 전치).
- 해석: “가중치는 0 근처일 것”이라는 사전 믿음이 벌점 항이 된다. 사전분포가 넓을수록(\(\tau\) 큼) \(\lambda\)가 작아져 보통의 최소제곱에 가까워진다.
활용
- 평활(smoothing). 단어 빈도로 확률을 어림할 때 한 번도 안 나온 단어의 확률을 0으로 두지 않도록, 모든 개수에 1을 더한다(라플라스 평활). 균등 사전분포를 쓴 사후 평균과 같다.
- 정칙화의 해석. L2 정칙화는 정규 사전분포, L1 정칙화(라쏘)는 라플라스 사전분포의 MAP다.
- A/B 테스트의 베이즈판. “B가 A보다 나을 확률”을 사후분포로 직접 계산해 보고한다.
- 흔한 실수. 사전분포를 결과를 본 뒤에 고르는 것, 자료가 적은데 사전분포의 영향을 밝히지 않는 것.
연결
확인 문제
C1 사전분포 \(\mathrm{Beta}(2, 2)\)에서 10번 중 7번 성공을 관측했다. 사후분포, 사후 평균, MAP는?
답: \(\mathrm{Beta}(9, 5)\). 사후 평균 \(\frac{9}{14} \approx 0.643\), MAP \(\frac{8}{12} \approx 0.667\). MLE 0.7보다 0.5 쪽으로 당겨졌다.
C2 정규 사전분포를 둔 MAP가 릿지 회귀와 같은 이유는?
답: MAP는 \(\ln L + \ln\pi\)를 최대화한다. 정규 잡음의 \(\ln L\)은 \(-\frac{1}{2\sigma^2}\) × 제곱 오차이고, 정규 사전분포의 \(\ln\pi\)는 \(-\frac{1}{2\tau^2}\Vert \mathbf{w}\Vert ^2\)이다. 부호를 바꾸면 “제곱 오차 + \(\lambda\) × 가중치 제곱합” 최소화, 곧 릿지다.
C3 “모수가 이 구간에 있을 확률이 95%”라고 말할 수 있는 것은 신뢰구간과 신용구간 중 어느 것인가?
답: 신용구간이다. 베이즈 추론에서는 모수 자체에 확률분포(사후분포)가 있어서 모수에 대한 확률을 말할 수 있다. 신뢰구간의 95%는 구간을 만드는 방법이 되풀이될 때의 적중률이다.
-
Wasserman, All of Statistics, “Bayesian Inference” 장(사전·사후분포, 사후 평균, 신용구간, 빈도주의와의 비교). ↩
-
Blitzstein, Hwang, Introduction to Probability 2판, 8.3절 “Beta”(베타–이항 켤레, 사전분포의 가상 관측 해석). ↩
-
이 문서의 베타–이항 켤레 절을 그렸다. 사후분포를 다음 사전분포로 쓰는 차례 갱신은 베이즈 정리의 두 번 연속 양성 예제와 같은 계산이다(Blitzstein·Hwang 2판 2.6절). ↩
-
33_bayesian-inference_plot.py로 그렸고, 그림에 쓴 값(사후 평균 0.8과 \(\frac57 \approx 0.71\), MAP 0.8, 네 밀도의 넓이 1)을 같은 코드로 확인했다. ↩