해시 테이블, 무작위 퀵정렬, 부하 분산처럼 무작위성을 쓰는 알고리즘의 성능을 확률로 따지는 기법 묶음이다. 도구는 셋이다. 세고 싶은 것을 “있다/없다” 조각으로 쪼개 기댓값을 더하기, 생일 문제식 충돌 계산, 나쁜 일의 확률을 부등식으로 위에서 막기. 이렇게 하면 입력이 아무리 나빠도 알고리즘이 스스로 던진 동전 덕분에 “평균적으로” 또는 “높은 확률로” 빠르다고 보장할 수 있다. 하지만 보장은 확률적이라, 운이 아주 나쁜 실행을 막아 주지는 않는다.
예시로 보기
키 2,000개를 칸 500개짜리 해시 테이블에 넣는다. 해시값이 고르게 무작위로 퍼진다고 가정하면
- 한 칸에 들어가는 키 수의 평균은 \(\frac{2000}{500} = 4\)다(적재율 \(\alpha\)). 키마다 “이 칸에 들어감”의 확률이 \(\frac{1}{500}\)이고 선형성으로 2,000번 더한 것이다.
- 같은 칸에 들어간 키 쌍의 수는 평균 \(\binom{2000}{2}\frac{1}{500} \approx 3{,}998\)(\(\binom{\ }{\ }\)은 위의 수만큼 있는 것에서 아래의 수만큼 고르는 경우의 수)쌍이다. 쌍마다 충돌 확률이 \(\frac{1}{500}\)이다.
첫 계산이 아래의 “지시 확률변수로 기댓값 세기”, 둘째가 “생일 문제식 쌍 세기”다. 어느 쪽도 키들의 관계나 분포 전체를 몰라도 된다.
정의
적용 조건. 알고리즘이 스스로 난수를 쓰거나(무작위 피벗, 무작위 해시 함수), 입력이 무작위라고 가정할 수 있을 때. 결과는 “기대 비용”이나 “실패 확률”로 나온다.
알아보는 신호. “평균 몇 번”, “높은 확률로”, “최악의 경우 대신 기대 시간”, 해시·무작위 피벗·무작위 선택이 나오는 문제.
| 도구 | 쓰는 곳 | 핵심 식 |
|---|---|---|
| 지시 확률변수 + 선형성 | 기대 비교 횟수, 기대 충돌 수 | \(\mathbb{E}\left[\sum I_j\right] = \sum P(A_j)\) |
| 생일 문제(쌍 세기) | 충돌이 없을 조건 | 충돌 쌍의 기댓값 \(\binom{n}{2}\frac1m\), 충돌 없음 \(\approx e^{-n^2/(2m)}\) |
| 합집합 한계 + 체르노프 | 최대 부하, 실패 확률 | \(P(\text{하나라도 나쁨}) \le \sum P(\text{각각 나쁨})\) |
체이닝 해시 테이블. 해시값이 고르고 독립이라 가정하면(단순 균등 해싱) 체인 길이의 기댓값이 \(\alpha = \frac nm\)라, 탐색의 기대 시간은 \(\Theta(1 + \alpha)\)다. 칸 수를 키 수에 비례하게 늘려 \(\alpha\)를 상수로 두면 기대 \(O(1)\)이다1.
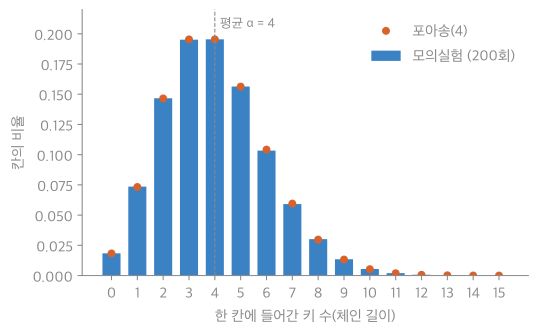
예시처럼 키 2,000개를 칸 500개에 넣는 실험을 200번 되풀이해, 칸마다 키 수를 센 것이다. 평균은 4지만 빈 칸도 2%쯤 있고, 10개 넘게 몰린 칸도 생긴다. 점은 포아송 분포(\(\lambda = 4\))로, 막대와 거의 겹친다2.
예제
무작위 퀵정렬의 기대 비교 횟수. 서로 다른 수 \(n\)개를 피벗을 무작위로 골라 정렬한다. 크기 순으로 \(z_1 < z_2 < \cdots < z_n\)이라 하자.
- 쪼개기: \(X_{ij}\) = “\(z_i\)와 \(z_j\)가 비교됨”(\(i < j\)). 비교는 피벗과 나머지 사이에만 일어나고, 같은 쌍이 두 번 비교되지 않으므로 전체 비교 수는 \(\sum_{i<j}X_{ij}\).
- 한 쌍의 확률: \(z_i, \dots, z_j\) 중 처음으로 피벗이 되는 원소가 \(z_i\)나 \(z_j\)면 둘이 비교되고, 그 사이의 다른 원소면 둘이 갈라져 영영 비교되지 않는다. 처음 피벗은 이 \(j - i + 1\)개 중 똑같은 확률이라 \(P = \frac{2}{j - i + 1}\).
- 더하기: \(\mathbb{E} = \sum_{i<j}\frac{2}{j - i + 1} = 2(n + 1)H_n - 4n\)(\(H_n = 1 + \frac12 + \cdots + \frac1n\)). 약 \(2n\ln n\), 곧 \(O(n\log n)\)이다.
- 검산: \(n = 3\)이면 \(\frac83\), \(n = 1000\)이면 약 10,986번이다. 200번 모의실험의 평균과 1% 안에서 맞는다. 입력 순서와 상관없는 보장이다. 이미 정렬된 입력도 피벗이 무작위라 평균이 같다1.
활용
- 충돌 없는 해시. 키 \(n\)개를 충돌 없이 넣으려면 칸이 대략 \(n^2\)에 비례해야 한다. 키 1,000개의 충돌 확률을 1% 미만으로 하려면 칸이 약 4,970만 개 필요하다. 완전 해싱은 이 사실을 두 단계로 나눠 써서 전체 공간을 \(O(n)\)으로 유지한다1.
- 부하 분산. 요청 \(n\)개를 서버 \(n\)대에 무작위로 보내면 가장 바쁜 서버가 \(\Theta\left(\frac{\ln n}{\ln\ln n}\right)\)개를 받는다. \(n = 10{,}000\)에서 모의실험하면 약 7개다. 서버 두 대를 무작위로 골라 덜 바쁜 쪽에 보내면 약 3개로 확 준다(두 선택의 힘)34.
- 블룸 필터. 비트 배열과 해시 함수 \(k\)개로 “집합에 있는가”를 답하는 자료구조다. 없는 원소를 있다고 할(거짓 양성) 확률은 약 \((1 - e^{-kn/m})^k\)이다. 원소당 비트 10개, 해시 7개면 약 0.8%다. 원소를 저장하지 않아 공간이 작고, 거짓 음성은 없다3.
- 흔한 실수. “기대 시간 \(O(n\log n)\)“을 “항상 \(O(n\log n)\)“으로 읽는 것. 무작위 퀵정렬도 운이 극단적으로 나쁘면 \(O(n^2)\)이 걸린다. 그 확률이 아주 작다는 것은 체르노프 같은 부등식으로 따로 보인다.
- 알고리즘에서: 딕셔너리와 집합의 ‘평균 \(O(1)\)‘도 칸이 차면 칸 수를 늘려 \(\alpha\)를 상수로 두는 데서 나오고, 그 문서는 칸에 매다는 방식을 직접 짜서 체인 길이가 평균 1개 안팎임을 잰다(파이썬
dict자체는 매달지 않고 빈칸을 찾아 넣는다). 값을 무작위 순서로 이진 탐색 트리에 넣으면, 뿌리의 깊이를 0으로 둘 때 깊이 합의 기댓값도 \(2(n + 1)H_n - 4n\)이다. 깊이 합은 조상·자손 쌍의 수이고, \(z_i\)와 \(z_j\)가 조상·자손이 되는 것은 \(z_i, \dots, z_j\) 중 가장 먼저 넣은 값이 둘 중 하나일 때라서 퀵정렬에서 둘이 비교되는 사건과 같다.
연결
- 선수: 기댓값과 선형성, 확률 부등식, 비둘기집 원리(칸보다 키가 많으면 충돌은 확실하다. 확률은 그 전 단계를 다룬다)
- 같은 계산: 생일 문제, 기댓값 선형성 예제 사다리(빈 칸 수)
과목별 관점
자료구조 (1-2학기). 위의 체이닝 결과에 더해, 넘친 키를 표 안의 다음 빈칸에 넣는 선형 탐사도 기댓값을 식으로 쓸 수 있다. 적재율 \(\alpha\)는 키 수를 칸 수로 나눈 값이고 선형 탐사에서는 \(0 \le \alpha \le 1\)이다. 표에 있는 키를 찾을 때 보는 칸 수의 기댓값을 \(S_n\), 없는 키를 찾을 때를 \(U_n\)이라 하면 \(n\)이 클 때
\[S_n \approx \frac12\left(1 + \frac{1}{1 - \alpha}\right), \qquad U_n \approx \frac12\left(1 + \frac{1}{(1 - \alpha)^2}\right)\]이다 [증명 생략: Knuth, The Art of Computer Programming Vol. 3, 6.4절]. \(\alpha\) = 0.5, 0.75, 0.9에서 \((S_n, U_n)\)은 (1.5, 2.5), (2.5, 8.5), (5.5, 50.5)다. 살피는 칸이 고르게 무작위라고 볼 때의 한계 \(\frac{1}{1 - \alpha}\)(딕셔너리와 집합의 값, 0.9에서 10칸)보다 \(U_n\)이 훨씬 큰 것은, 선형 탐사에서는 찬 칸들이 이어 붙어 뭉치를 이루기 때문이다5. 체이닝에서는 \(S_n \approx 1 + \frac\alpha2\), \(U_n \approx \alpha\)이고, 아래 C1의 답 3이 이 \(U_n\)이다. 식을 쓰는 법은 선형 탐사와 적재율로 해시 테이블 크기 정하기에 있다.
확인 문제
C1 키 3,000개를 칸 1,000개의 체이닝 해시 테이블에 넣었다. 없는 키를 찾을 때 훑는 원소 수의 기댓값은?
답: 찾는 키가 들어갈 칸의 체인을 끝까지 훑는다. 체인 길이의 기댓값은 \(\alpha = \frac{3000}{1000} = 3\)이다.
C2 무작위 퀵정렬에서 크기 순 \(i\)번째와 \(j\)번째 원소가 비교될 확률이 \(\frac{2}{j - i + 1}\)인 이유를 설명하라.
답: 두 원소는 둘 중 하나가 피벗일 때만 비교된다. \(z_i\)부터 \(z_j\)까지의 원소들은 그 사이 원소가 피벗으로 뽑히기 전까지 같은 부분 배열에 함께 있다. 이 \(j - i + 1\)개 중 가장 먼저 피벗이 되는 것이 똑같은 확률로 정해지고, 그것이 \(z_i\)나 \(z_j\)(두 경우)일 때만 비교된다.
C3 키 1,000개를 해시할 때 충돌이 하나도 없을 확률을 99% 이상으로 하려면 해시값의 가짓수 \(m\)은 대략 얼마여야 하는가?
답: 충돌 없음 \(\approx e^{-\binom{1000}{2}/m} \ge 0.99\)에서 \(m \ge \frac{499{,}500}{-\ln 0.99} \approx 4.97 \times 10^7\). 키 수의 제곱에 비례하는 공간이 든다.
-
Cormen, Leiserson, Rivest, Stein, Introduction to Algorithms 3판, 5.4절(생일 문제, 공과 통), 7.4절 “Analysis of quicksort”(쌍이 비교될 확률 \(\frac{2}{j - i + 1}\), 기대 비교 횟수 \(O(n\lg n)\)), 11.2절 “Hash tables”(체이닝, 정리 11.1·11.2), 11.5절 “Perfect hashing”. ↩ ↩2 ↩3
-
26_randomized-analysis_plot.py로 그렸고, 그림에 쓴 값(칸당 평균 4, 충돌 쌍의 평균이 \(\binom{2000}{2}\frac{1}{500}\)과 2% 안, 빈 칸 비율 \(e^{-4} \approx 0.018\), 포아송과의 차이 0.01 미만)을 같은 코드로 확인했다. ↩
-
Mitzenmacher, Upfal, Probability and Computing, 5장(공과 통의 최대 부하, 블룸 필터). ↩ ↩2
-
두 선택 중 덜 찬 곳에 넣으면 최대 부하가 \(\frac{\ln\ln n}{\ln 2} + O(1)\)로 준다는 결과는 Azar, Broder, Karlin, Upfal, “Balanced Allocations”, SIAM Journal on Computing 29(1), 1999에 있다. 부하 7과 3, 블룸 필터 0.8%, 퀵정렬 수치는 26_randomized-analysis_verify.py로 확인했다. ↩
-
고르게 무작위일 때의 한계 \(\frac{1}{1 - \alpha}\)는 Cormen 외, Introduction to Algorithms 3판 정리 11.6이다. 칸 20,011개짜리 선형 탐사 표의 모의실험에서 \(\alpha = 0.9\)일 때 없는 키는 평균 47.8칸으로 식의 50.5와 가까웠다(49_linear-probing_verify.py). 실험으로 확인한 값이고 증명이 아니다. ↩