가운데가 가장 높고 양쪽으로 대칭으로 빠르게 낮아지는 종 모양 분포다. 평균과 표준편차 두 수만으로 모양이 완전히 정해지고, 평균에서 표준편차 1배·2배·3배 안에 약 68%·95%·99.7%가 들어간다. 작은 독립 요인이 많이 더해진 양(측정 오차, 합과 평균)은 대개 이 모양에 가까워져서 통계의 기본 도구가 된다. 대신 꼬리가 아주 빨리 얇아져서, 가끔 극단값이 나오는 자료(응답 지연 등)에 쓰면 드문 사건의 확률을 크게 과소평가한다.
예시로 보기
서버 응답 시간이 평균 200 ms, 표준편차 20 ms인 정규분포를 따른다고 하자.
| 범위 | 표준편차로 | 확률 |
|---|---|---|
| 180~220 ms | 평균 ± 1σ | 약 68.3% |
| 160~240 ms | 평균 ± 2σ | 약 95.4% |
| 140~260 ms | 평균 ± 3σ | 약 99.7% |
160 ms 미만일 확률은 “평균보다 표준편차 2개 아래”라 \(\frac{1 - 0.954}{2} \approx 2.3\%\)다. 값을 “평균에서 표준편차 몇 개 떨어졌나”로 바꾸는 이 계산이 아래의 표준화이고, 200이 \(\mu\), 20이 \(\sigma\)다.
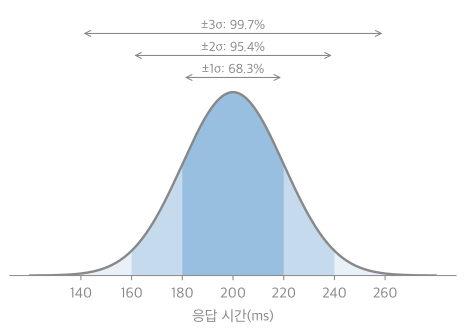
가장 진한 띠가 평균 ± 1σ, 그다음이 ± 2σ와 ± 3σ다. 띠를 한 칸 넓힐 때마다 더해지는 넓이가 빠르게 줄어, ± 3σ 밖에는 0.3%만 남는다1.
정의
평균 \(\mu \in \mathbb{R}\)(\(\in\)은 “~에 속한다”), 분산 \(\sigma^2 > 0\)인 정규분포 \(\mathcal{N}(\mu, \sigma^2)\)의 밀도는
\[f(x) = \frac{1}{\sigma\sqrt{2\pi}}\exp\left(-\frac{(x - \mu)^2}{2\sigma^2}\right)\quad(x \in \mathbb{R})\]이다. \(\mu = 0\), \(\sigma = 1\)인 것이 표준정규분포이고, 그 CDF를 \(\Phi\)로 쓴다2.
\(\Phi\)는 기본 함수로 쓸 수 없어 표나 오차함수로 계산한다. \(\Phi(z) = \frac12\left(1 + \operatorname{erf}\frac{z}{\sqrt2}\right)\)이고, 파이썬에서는 math.erf로 계산한다.
동치인 다른 정의(표준화). \(X \sim \mathcal{N}(\mu, \sigma^2)\) ⇔ \(Z = \frac{X - \mu}{\sigma} \sim \mathcal{N}(0, 1)\). 그래서 모든 정규분포 계산은 \(P(X \le x) = \Phi\left(\frac{x - \mu}{\sigma}\right)\) 하나로 끝난다. \(\frac{x - \mu}{\sigma}\)를 \(z\)점수라 한다.
성질.
- 일차 변환: \(aX + b \sim \mathcal{N}(a\mu + b, a^2\sigma^2)\) (\(a \ne 0\)).
- 독립인 정규분포의 합: \(\mathcal{N}(\mu_1, \sigma_1^2) + \mathcal{N}(\mu_2, \sigma_2^2) = \mathcal{N}(\mu_1 + \mu_2, \sigma_1^2 + \sigma_2^2)\).
- 95%를 담는 대칭 구간은 \(\mu \pm 1.96\sigma\)다.
설계 이유. 지수 안의 \(-\frac{(x - \mu)^2}{2\sigma^2}\)는 평균에서 멀어질수록 거리의 제곱으로 빠르게 줄게 한다. 앞의 \(\frac{1}{\sigma\sqrt{2\pi}}\)는 넓이를 1로 맞추는 상수이고, \(\sqrt{2\pi}\)는 가우스 적분에서 나온다(아래 증명). 이 모양이 특별한 이유는 중심극한정리 때문이다. 독립인 것들의 합은 원래 분포와 상관없이 이 모양으로 모인다.
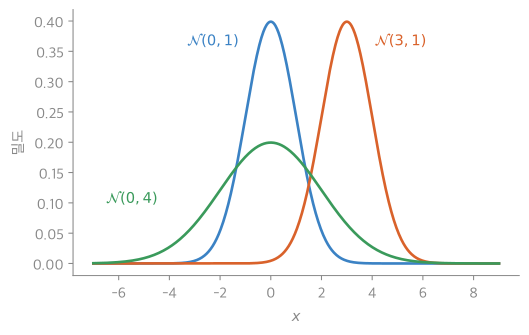
\(\mu\)를 0에서 3으로 바꾸면 종이 모양 그대로 옮겨 간다. \(\sigma\)를 2로 키우면 종이 두 배 넓어지고 높이는 절반이 되어, 넓이 1이 그대로다1.
| 해당함(대략 정규) | 해당하지 않음 |
|---|---|
| 여러 번 잰 측정값의 오차 | 대기 시간(지수분포, 한쪽으로 치우침) |
| 주사위 100개의 합 | 응답 지연, 파일 크기처럼 꼬리가 두꺼운 자료 |
| 많은 사람의 키 |
넓이가 1인 이유
- 치환: \(z = \frac{x - \mu}{\sigma}\)로 두면 \(dx = \sigma\,dz\)이고 \(\int f\,dx = \frac{1}{\sqrt{2\pi}}\int_{-\infty}^{\infty}e^{-z^2/2}dz\).
- 한 번 더 치환: \(z = \sqrt2\,u\)로 두면 \(\int e^{-z^2/2}dz = \sqrt2\int e^{-u^2}du\).
- 가우스 적분: 중적분과 변수변환에서 극좌표로 구한 \(\int_{-\infty}^{\infty}e^{-u^2}du = \sqrt\pi\)를 쓴다.
- 정리: \(\frac{1}{\sqrt{2\pi}} \cdot \sqrt2 \cdot \sqrt\pi = 1\). ∎
스스로 설명해 보기
1. 증명 1단계에서 \(dx = \sigma\,dz\)가 앞의 \(\frac1\sigma\)를 지우는 것은 무엇을 뜻하는가?
가로로 \(\sigma\)배 늘이면 넓이가 \(\sigma\)배가 되므로, 높이를 \(\frac1\sigma\)배 해야 넓이 1이 유지된다. 표준편차가 클수록 종이 낮고 넓은 이유다.
2. 가우스 적분이 없으면 이 증명의 어디가 막히는가?
3단계다. \(e^{-u^2}\)는 원시함수를 기본 함수로 쓸 수 없어 미적분의 기본정리를 쓸 수 없다. 제곱해 이중적분으로 바꾸고 극좌표로 풀어야 값이 나온다.
3. 이 정의의 핵심 아이디어는?
평균과 분산만 정하면 나머지는 “거리 제곱에 대한 지수적 감소”라는 하나의 모양으로 고정된다. 그래서 표준화 한 번으로 모든 정규분포를 표준정규분포 하나로 계산한다.
예제
응답 시간의 기준 잡기. 응답 시간이 \(\mathcal{N}(200, 20^2)\) ms일 때, 요청의 95%가 들어가는 대칭 구간과 160 ms 미만일 확률은?
- 구간: \(200 \pm 1.96 \times 20 = [160.8,\ 239.2]\) ms.
- 표준화: \(z = \frac{160 - 200}{20} = -2\).
- 확률: \(\Phi(-2) \approx 0.0228\).
- 주의: 실제 응답 시간은 오른쪽 꼬리가 길어 정규 가정이 자주 틀린다. 꼬리 지연 기준은 정규 가정 대신 측정한 분위수로 잡는 편이 안전하다.
활용
- 오차 막대와 신뢰구간. 표본평균은 중심극한정리로 정규분포에 가까워서, “평균 ± 1.96 × 표준오차”를 95% 구간으로 쓴다.
- 잡음 모델. 통신과 센서의 열잡음, 회귀 분석의 오차 항을 정규분포로 둔다. 정규 잡음 가정에서 최대가능도 추정은 최소제곱과 같아진다(선형회귀).
- 표본 생성. 박스–뮬러 변환으로 균등 난수 두 개에서 독립인 표준정규 난수 두 개를 만든다.
연결
- 선수: 연속 확률변수와 확률밀도, 분산, 가우스 적분
- 이어지는 개념: 다변량 정규분포, 중심극한정리
자주 하는 오해
정규분포에서만 맞다. 이 규칙이 워낙 유명해 모든 자료에 쓰기 쉽다. 하지만 꼬리가 두꺼운 분포에서는 3σ 밖 확률이 훨씬 크다. 자유도 3인 t분포를 모의실험하면 약 1.3%로 정규분포의 0.27%보다 약 5배다. 지연 시간, 트래픽, 파일 크기처럼 가끔 아주 큰 값이 나오는 자료에 정규 가정을 쓰면 장애를 과소평가한다. 자료의 분위수를 직접 보고 확인한다.
과목별 관점
자료와 정보 (2-1학기). 정규분포를 “자료를 평균과 분산 두 수로 줄여 적는 모델”로 쓴다. 특히 그 두 수가 자료를 잘 대표하지 못하는 경우를 눈여겨본다.
- 표기. 밀도를 \(N(x \mid \mu, \sigma^2)\), 누적분포를 \(\Phi(x \mid \mu, \sigma^2)\)로 쓴다. 세로 막대 뒤에 적은 것이 분포의 모양을 정하는 수다. 이 문서의 \(f(x)\), \(\Phi\left(\frac{x - \mu}{\sigma}\right)\)와 같은 함수다. 표준정규분포는 \(N(0, 1)\), 표준화는 \(z = \frac{x - \mu}{\sigma}\)로 같다.
- average와 mean. 두 낱말을 가르기도 한다. average는 자료 값을 모두 더해 개수로 나눈 값이다. mean은 정규분포 한가운데의 값 \(\mu\)다. 자료가 정규분포를 따르면 둘이 같다고 본다. 앞의 것은 자료에서 계산한 수이고 뒤의 것은 모델에 든 수다. 자료 개수가 유한하면 둘이 딱 같지는 않고, 자료가 많을수록 가까워진다3.
- 평균의 함정. 평균과 분산은 분포가 정규분포라고 가정하고 쓰는 대표값이다. 평균과 분산은 어떤 자료에서도 계산할 수 있다. 다만 그 두 수만으로 자료 전체의 모양이 정해지는 것은 정규분포일 때뿐이다3. 예를 두 가지 들면 이렇다.
- 군인 100명이 강을 건넌다. 군인의 평균 키는 180, 강의 평균 깊이는 150이다. 평균끼리 견주면 모두 건널 수 있어 보인다. 그런데 강의 가장 깊은 곳은 200이고 키가 200을 넘는 군인은 30명뿐이다. 나머지 70명은 가장 깊은 곳에서 머리까지 잠긴다. 평균은 가장 깊은 곳도, 키가 작은 군인도 알려 주지 않는다3.
- 가구소득 분포는 오른쪽으로 꼬리가 길다. 2016년 중위소득은 4,300만 원인데 평균소득은 5,478만 원이다. 2017년은 4,457만 원과 5,705만 원이다. 두 해 모두 평균이 1,200만 원쯤 높다. 소득이 아주 많은 몇몇 가구가 평균만 끌어올려서다3. 이럴 때는 평균(mean), 중앙값(median), 최빈값(mode)이 서로 다른 자리에 놓인다.
- 섞은 것과 더한 것. 가우시안 분포 둘을 합치면 무엇이 될까? 남자 키와 여자 키는 따로 그리면 각각 종 모양이다. 둘을 합쳐 그린 전체 키는 꼭대기가 넓고 평평하다. 위 성질의 “독립인 정규분포의 합”은 값 두 개를 더한 것이고, 전체 키 그림은 두 집단의 자료를 한 통에 섞은 것이다. 섞은 자료는 정규분포가 아니다. 여자 키가 \(\mathcal{N}(160, 6^2)\), 남자 키가 \(\mathcal{N}(173, 6^2)\)이고 반반 섞였다면, 한가운데 166.5 cm의 밀도는 0.037이다. 평균과 분산이 같은 정규분포라면 0.045여야 한다4.
- 표준정규분포의 눈금. 68-95-99.7을 띠 하나씩으로 쪼개면 이렇다. 평균에서 한쪽으로 표준편차 0~1개 사이에 34.13%, 1~2개 사이에 13.59%, 2~3개 사이에 2.14%, 3개 밖에 0.13%가 든다. 왼쪽부터 쌓으면 \(z = -3, -2, -1, 0, 1, 2, 3\)에서 0.1%, 2.3%, 15.9%, 50%, 84.1%, 97.7%, 99.9%다. \(z\)점수를 다른 눈금으로 바꾼 점수도 있다. T점수는 \(z = -3\)부터 \(3\)까지를 20부터 80까지로 옮긴다. 식으로는 \(T = 50 + 10z\)다5.
확인 문제
C1 \(X \sim \mathcal{N}(100, 15^2)\)일 때 \(P(X > 130)\)은?
답: \(z = \frac{130 - 100}{15} = 2\). \(1 - \Phi(2) \approx 0.0228\).
C2 응답 시간이 \(\mathcal{N}(200, 20^2)\) ms일 때 95%가 들어가는 대칭 구간은?
답: \(200 \pm 1.96 \times 20 = [160.8, 239.2]\) ms.
C3 정규분포 밀도의 앞에 \(\frac{1}{\sigma\sqrt{2\pi}}\)가 붙는 이유를 두 부분으로 나눠 설명하라.
답: \(\frac1\sigma\)는 가로로 \(\sigma\)배 넓어진 만큼 높이를 낮춰 넓이를 유지하는 배율이다. \(\frac{1}{\sqrt{2\pi}}\)는 \(\int e^{-z^2/2}dz = \sqrt{2\pi}\)(가우스 적분에서 나옴)를 나눠 넓이를 1로 맞추는 상수다.
C4 68-95-99.7 규칙이 정규분포가 아닌 분포에서 깨지는 예를 계산으로 보여라.
답: \(\mathrm{Exp}(1)\)은 평균 1, 표준편차 1이다. 평균 ± 1σ 안, 곧 \(0 < X < 2\)일 확률은 \(1 - e^{-2} \approx 0.865\)로 0.68과 다르다.
C5 여자 키가 \(\mathcal{N}(160, 6^2)\), 남자 키가 \(\mathcal{N}(173, 6^2)\) cm라고 하자. (가) 여자 한 명과 남자 한 명을 독립으로 뽑아 두 키를 더한 값 (나) 여자와 남자가 반반 섞인 집단에서 한 명을 뽑은 키. 어느 쪽이 정규분포인가? 각각의 평균과 분산은?
답: (가)만 정규분포다. \(\mathcal{N}(333, 72)\)다. (나)는 정규분포가 아니다. 평균은 \(166.5\), 분산은 \(36 + 6.5^2 = 78.25\)(표준편차 약 8.85)이고, 평균에서 표준편차 1개 안에 약 64.7%가 든다. 정규분포라면 68.3%다.
이유: (가)는 확률변수 둘을 더했다. 독립인 정규분포의 합은 정규분포이고 평균과 분산이 각각 더해진다. (나)는 값을 더한 것이 아니라 두 분포 가운데 하나를 골라 뽑았다. 밀도가 두 종 모양의 평균이라 꼭대기가 넓적해진다. 분산은 집단 안의 분산 36에, 집단 평균 160과 173이 전체 평균에서 6.5씩 떨어진 몫 \(6.5^2\)을 더한 값이다4.
-
16_normal-distribution_plot.py로 그렸고, 그림에 쓴 값(68.3%·95.4%·99.7%, \(\Phi(-2) \approx 0.023\), 세 밀도의 넓이 1, \(\sigma = 2\)일 때 꼭대기 높이가 절반)을 같은 코드로 확인했다. ↩ ↩2
-
Blitzstein, Hwang, Introduction to Probability 2판, 5.4절 “Normal”(밀도, 표준화, \(\Phi\), 68-95-99.7 규칙, 정규분포의 일차 변환), 6.6절 “Sums of independent r.v.s via MGFs”(독립인 정규분포의 합). ↩
-
섞은 분포의 밀도 0.037과 정규분포의 0.045, 분산 78.25, 표준편차 1개 안의 확률 64.7%, 더한 값의 평균 333과 분산 72(모의실험 20만 개)를 파이썬으로 계산해 확인했다. ↩ ↩2
-
그림의 눈금 \(z = -3, \dots, 3\)과 T점수 \(20, \dots, 80\)이 이 식과 맞는 것, 구간별 비율과 누적 백분율이 \(\Phi\)로 계산한 값과 맞는 것을 파이썬
math.erf로 확인했다. ↩