전화번호부에서 이름만 알면 번호를 바로 찾듯, 딕셔너리는 이름표(키)로 값을 바로 찾는 표다. 몇십만 개가 들어 있어도 넣기, 찾기, 지우기가 거의 한 번에 끝난다. 집합은 값 없이 이름표만 모은 것이라 “있나 없나”에 바로 답한다. 대신 크기 순으로 늘어서 있지 않아서 “가장 작은 것”이나 “k번째” 같은 질문에는 약하고, 이름표로는 바뀌지 않는 값(숫자, 문자열, 튜플)만 쓸 수 있다.
예시로 보기
과일 이름이 여러 번 나오는 리스트에서, 과일마다 몇 번 나왔는지 센다.
fruits = ["사과", "배", "사과", "귤", "사과"]
count = {}                                  # 빈 딕셔너리
for f in fruits:
    count[f] = count.get(f, 0) + 1          # 없으면 0에서 시작해 1 더한다
# count == {"사과": 3, "배": 1, "귤": 1}
| 꺼낸 과일 | 이번에 한 일 | count |
|---|---|---|
| 사과 | 없으니 0 + 1 | {"사과": 1} |
| 배 | 없으니 0 + 1 | {"사과": 1, "배": 1} |
| 사과 | 있으니 1 + 1 | {"사과": 2, "배": 1} |
| 귤 | 없으니 0 + 1 | {"사과": 2, "배": 1, "귤": 1} |
| 사과 | 있으니 2 + 1 | {"사과": 3, "배": 1, "귤": 1} |
"사과"가 키, 3이 값이다. 리스트로 같은 일을 하면 과일마다 “이 과일을 센 적이 있나”를 처음부터 찾아야 한다. 딕셔너리는 그 찾기가 한 번에 끝난다.
속에서 일어나는 일
딕셔너리는 속에 칸이 여러 개 있는 리스트를 갖고 있다. 키를 넣으면 이렇게 칸을 정한다1.
- 해시 함수가 키를 큰 정수로 바꾼다.
hash("사과")같은 값이다. - 그 정수를 칸 수로 나눈 나머지가 칸 번호다.
- 그 칸에 키와 값을 함께 둔다. 찾을 때도 같은 계산으로 칸을 바로 찾아간다.
"사과" → hash → 5,731,…,203 → 8로 나눈 나머지 3 → 칸 3
칸:  [0] [1] [2] [3: 사과→3] [4] [5: 배→1] [6] [7]
서로 다른 키가 같은 칸에 오는 것을 충돌이라고 한다. 충돌이 나면 다른 빈칸을 찾거나 한 칸에 여러 개를 매달아 둔다. 칸이 너무 차면 칸 수를 두 배쯤으로 늘리고 모두 다시 넣는다. 그래서 칸마다 들어 있는 키 수가 평균 몇 개를 넘지 않고, 넣기·찾기·지우기가 평균 \(O(1)\)이다. 모든 키가 한 칸에 몰리는 아주 나쁜 경우에는 \(O(n)\)까지 느려질 수 있다1.
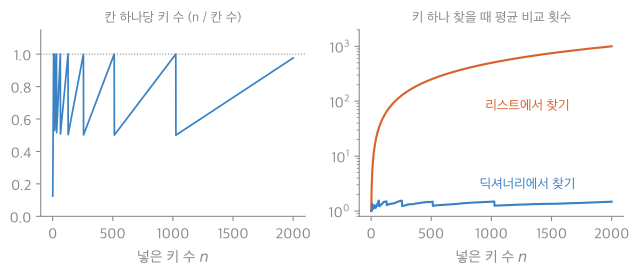
왼쪽은 칸 하나에 키가 평균 몇 개 있는지다. 1을 넘으려는 순간 칸을 두 배로 늘려 절반으로 떨어지므로, 톱니 모양으로 0.5와 1 사이를 오간다. 오른쪽은 들어 있는 키 하나를 찾을 때 평균 비교 횟수다(세로는 10배마다 한 칸). 리스트는 키 수에 비례해 늘지만, 딕셔너리는 2번 아래에 머문다2.
쓰는 법
| 딕셔너리 코드 | 하는 일 | 비용3 |
|---|---|---|
d[k] = v |
넣기. 같은 키가 있으면 값을 바꾼다 | 평균 \(O(1)\) |
d[k] |
꺼내기. 없으면 KeyError |
평균 \(O(1)\) |
d.get(k, 0) |
꺼내기. 없으면 0 | 평균 \(O(1)\) |
k in d |
키가 있나 | 평균 \(O(1)\) |
del d[k] |
지우기 | 평균 \(O(1)\) |
for k, v in d.items(): |
모두 돌기 (넣은 순서대로) | \(O(n)\) |
v in d.values() |
값 중에 있나 | \(O(n)\). 값은 하나씩 본다 |
| 집합 코드 | 하는 일 | 비용 |
|---|---|---|
s = set(), s = {1, 2} |
만들기 (빈 집합은 set(). {}는 빈 딕셔너리) |
|
s.add(x), s.discard(x) |
넣기, 지우기(없어도 괜찮다) | 평균 \(O(1)\) |
x in s |
있나 | 평균 \(O(1)\) |
s \| t, s & t, s - t |
합집합, 교집합, 차집합 | 두 크기에 비례 |
set(리스트) |
겹친 것 없애기 | \(O(n)\) |
지켜지는 약속은 두 가지다. 같은 키는 하나만 있다. 그래서 같은 키로 다시 넣으면 새 값으로 바뀐다. 키는 바뀌지 않는 값이어야 한다. 리스트는 고칠 수 있어서 키가 될 수 없고, 대신 튜플 (1, 2)는 된다.
파이썬 3.7부터 딕셔너리는 넣은 순서를 지키는 것이 언어 규칙이다4. 집합은 순서를 약속하지 않는다.
세기 도구: Counter와 defaultdict
from collections import Counter, defaultdict

c = Counter(["사과", "배", "사과"])   # Counter({'사과': 2, '배': 1})
c["없는것"]                            # 0 (없는 키도 0으로 답한다)
c.most_common(1)                       # [('사과', 2)]  가장 많은 것
Counter("aab") - Counter("ab")         # Counter({'a': 1})  개수 빼기

g = defaultdict(list)                  # 없는 키를 꺼내면 빈 리스트를 만들어 준다
g["과일"].append("사과")               # {'과일': ['사과']}
Counter는 개수 세기 전용 딕셔너리이고, defaultdict(int), defaultdict(list), defaultdict(set)은 처음 보는 키에 0, 빈 리스트, 빈 집합을 넣어 주는 딕셔너리다5.
스스로 설명해 보기
가장 많이 나온 단어를 찾는 코드다. 줄마다 왜 그렇게 썼는지 답해 본다.
def most_frequent(words):
    count = {}
    for w in words:                          # (1)
        count[w] = count.get(w, 0) + 1       # (2)
    return max(count, key=count.get)         # (3)
1. (2)에서 count[w] + 1이 아니라 count.get(w, 0) + 1로 쓴 까닭은?
처음 보는 단어는 아직 표에 없어서 count[w]가 KeyError를 낸다. get(w, 0)은 없을 때 0을 돌려주므로 “처음이면 0에서 시작”을 한 줄로 쓸 수 있다.
2. (3)의 max(count, key=count.get)은 무엇을 돌려주는가?
딕셔너리를 돌면 키가 나온다. key=count.get은 “키끼리 비교할 때 그 키의 개수로 비교하라”는 뜻이다. 그래서 개수가 가장 큰 키(단어)를 돌려준다. 개수가 같으면 먼저 넣은 단어가 나온다.
3. 전체 비용은?
(1)은 n번 돌고, (2)는 평균 \(O(1)\)이다. (3)은 서로 다른 단어 수만큼 본다. 모두 \(O(n)\)이다. 리스트로 개수를 세면 (2)의 찾기가 \(O(n)\)이 되어 \(O(n^2)\)이다.
이 코드의 핵심 아이디어는?
“세어야 할 것을 이름표로 삼아 표에 적어 둔다.” 찾기가 한 번에 끝나서 전체가 한 번 훑는 비용으로 줄어든다.
같은 방법을 쓸 수 있는 다른 상황은?
이름별 점수 합치기, 신고당한 횟수 세기, 두 명단의 차이 찾기, 같은 글자로 된 단어 묶기(정렬한 글자를 키로)처럼 “무엇별로 모으기”가 나오면 거의 다 쓸 수 있다.
TypeError를 내는 것, 넣은 순서가 지켜지는 것도 확인했다 — 04_hash-dict-set_impl.py활용
- “무엇별로 센다”, “있었는지 기억한다”, “이름으로 번호를 찾는다”가 보이면 딕셔너리나 집합이다.
- 파이썬의
dict와set이 바로 해시 테이블이다. 데이터베이스의 해시 색인, 캐시, 중복 제거도 같은 원리다. - 다른 자료구조와 고르는 기준:
| 필요한 것 | 알맞은 구조 |
|---|---|
| 번호로 꺼내기, 순서 유지 | 리스트 |
| 있나 없나, 이름으로 찾기 | 집합, 딕셔너리 (평균 \(O(1)\)) |
| 크기 순서, 가장 작은 것, 범위 찾기 | 정렬한 리스트 + 정렬, 이분 탐색 |
- 자주 하는 실수:
d[k] += 1을 없는 키에 쓰면KeyError가 난다.get이나defaultdict(int),Counter를 쓴다.
연결
- 선수: 리스트와 문자열, 시간 복잡도로 방법 고르기
- 수학에서의 모습: 딕셔너리는 키 집합에서 값으로 가는 함수를 표로 적어 둔 것이다(함수의 성질과 집합의 크기). 서로 다른 키가 같은 칸에 가는 충돌은 키의 종류가 칸 수보다 많으면 비둘기집 원리 때문에 피할 수 없다.
- 칸이 키보다 훨씬 많아도 충돌은 일찍 생긴다. 칸이 \(m\)개면 키를 약 \(\sqrt{2m \ln 2}\)개만 넣어도 충돌이 한 번이라도 날 확률이 절반쯤 된다. 칸이 100만 개면 키 1,178개에서 절반을 넘는다. 생일 문제와 같은 계산이다.
- 평균 \(O(1)\)의 “평균”은 해시값이 칸에 고르게 흩어진다고 볼 때의 기댓값이다. 칸에 매다는 방식으로 키 \(n\)개를 칸 \(m\)개에 넣으면, 한 칸에 매달린 키 수의 기댓값은 \(\frac{n}{m}\)이다. 키마다 “이 칸에 왔나”를 0과 1로 세어 더하면 나온다(해싱과 무작위 알고리즘의 확률).
- 빈칸을 찾아 넣는 방식에서는 전체 칸 중 비율 \(\alpha\)만큼이 차 있을 때, 빈칸을 만날 때까지 보는 칸 수의 기댓값이 \(\frac{1}{1-\alpha}\) 이하다. 칸을 살피는 순서가 고르게 무작위라고 볼 때의 값이다. 반쯤 차면 2칸, 90% 차면 10칸이라 다 차기 전에 미리 칸을 늘린다(기하분포).
- 칸 번호를 정하는 “나눈 나머지”는 나눗셈과 합동의 나눗셈 정리에서 온다. 이 나머지는 늘 0 이상이고 칸 수보다 작다. 파이썬의
%도 이 나머지를 내서, 해시값이 음수여도 쓸 수 있는 칸 번호가 된다. - 함께 보면 좋은 수학: 함수(같은 키로 다시 넣으면 값이 바뀌는 것은 키마다 값이 하나뿐이라는 함수의 조건 때문이다), 집합(
set과 위 표의|,&,-는 수학의 집합과 그 연산을 그대로 옮긴 것이다), 등비급수(칸 수를 두 배씩 늘리면 다시 넣는 횟수를 모두 더해도 넣은 개수의 두 배쯤이라, 가끔 모두 다시 넣어도 평균 \(O(1)\)이다), 동치관계와 분할(정렬한 글자처럼 같은 키를 받는 것끼리 묶으면 서로 겹치지 않는 무리로 나뉜다) - 연습: 완주하지 못한 선수, 성격 유형 검사하기, 신고 결과 받기, 가장 많이 받은 선물
자주 하는 오해
in은 어디에 써도 빠르다”틀렸다. in이 빠른 것은 집합과 딕셔너리의 키에 쓸 때뿐이다. 문법이 똑같이 x in ...이라 모두 같은 비용처럼 보인다. 하지만 리스트, 문자열, d.values()에 쓰면 처음부터 하나씩 비교하는 \(O(n)\)이다. 반복문 안에서 리스트에 in을 쓰면 전체가 \(O(n^2)\)이 된다. 확인하려면 같은 자료를 리스트와 집합에 넣고 in을 여러 번 해서 시간을 재 본다. 시간 복잡도 문서의 측정에서는 약 1,000배 차이가 났다.
옛날 이야기다. 파이썬 3.7부터 딕셔너리는 넣은 순서대로 돈다4. 다만 “크기 순”은 아니다. 키 순서로 돌고 싶으면 sorted(d)로 정렬해서 돈다. 집합은 지금도 순서를 약속하지 않는다.
과목별 관점
자료구조 (1-2학기). 위 ‘속에서 일어나는 일’의 “충돌이 나면 다른 빈칸을 찾거나 한 칸에 여러 개를 매달아 둔다”는 한 문장을, 자료구조에서는 이름을 붙여 C로 하나씩 만든다.
| 이 문서의 말 | 자료구조의 용어 | 다루는 문서 |
|---|---|---|
| 칸 | 버킷(bucket) | 해시 테이블의 홈 버킷과 충돌 |
| 키가 계산대로 가야 할 칸 | 홈 버킷(home bucket) | 같은 문서 |
| 같은 칸으로 계산되는 키들 | 동의어(synonym) | 같은 문서 |
| 갈 칸에 다른 키가 이미 있다 | 충돌(collision) | 같은 문서 |
| 갈 칸에 들어갈 자리가 없다 | 넘침(overflow) | 같은 문서 |
| 다른 빈칸을 찾는다 | 선형 탐사(linear probing) | 선형 탐사 |
| 한 칸에 여러 개를 매단다 | 체이닝(chaining) | 체이닝 |
칸에 쌍이 하나만 들어가면 충돌과 넘침은 함께 일어난다. 선형 탐사는 바로 다음 칸부터 차례로 빈칸을 찾고, 지울 때는 뒤로 밀려난 키를 당겨 와야 찾는 길이 끊기지 않는다. 둘 가운데 무엇을 고를지는 선형 탐사와 체이닝 비교, 칸 수를 소수로 잡는 까닭은 나눗셈 해시 함수, 칸이 얼마나 차면 늘릴지는 적재율로 해시 테이블 크기 정하기에 있다. 이 문서에서 직접 짠 해시 테이블은 체이닝 쪽이고, 파이썬의 dict는 빈칸을 찾는 쪽이다.
확인 문제
C1 다음 코드가 끝난 뒤 d를 넣은 순서대로 적어라.
d = {}
for ch in "banana":
    d[ch] = d.get(ch, 0) + 1
답: {'b': 1, 'a': 3, 'n': 2}. 처음 나온 순서가 b, a, n이고, 같은 키는 값만 늘어난다.
C2 리스트 [1, 2]는 딕셔너리의 키가 될 수 없고 튜플 (1, 2)는 된다. 왜 그런가?
답: 칸 번호는 키의 내용으로 계산한다. 리스트는 넣은 뒤에 내용이 바뀔 수 있고, 그러면 저장한 칸과 다시 계산한 칸이 달라져 찾을 수 없게 된다. 그래서 파이썬은 바뀔 수 있는 값을 키로 받지 않는다(TypeError: unhashable type). 튜플은 바뀌지 않으므로 키가 될 수 있다.
C3 수 10만 개가 있고 “x가 있나?”를 10만 번 묻는다. 리스트 그대로, 집합, 정렬한 리스트 + 이분 탐색 중 무엇을 쓰고, 나머지는 왜 아닌가?
답: 집합이다. 만들기 \(O(n)\)에 질문마다 평균 \(O(1)\)이다. 리스트 그대로는 질문마다 \(O(n)\)이라 모두 10¹⁰번이다. 정렬 + 이분 탐색도 되지만(\(O(n \log n)\) + 질문마다 \(O(\log n)\)), 이 질문에는 집합이 더 간단하고 빠르다. 정렬은 “x보다 작은 수가 몇 개?”처럼 크기 순서가 필요할 때 고른다.
C4 해시 충돌이 무엇이고, 딕셔너리가 충돌이 있어도 평균 O(1)을 지키는 방법 두 가지는?
답: 서로 다른 키가 같은 칸 번호를 받는 것이다. 충돌한 키를 다른 빈칸에 넣거나 한 칸에 매달아 두고, 칸이 너무 차면 칸 수를 늘려 다시 넣어서 칸마다 키가 평균 몇 개를 넘지 않게 한다.
-
Cormen·Leiserson·Rivest·Stein, Introduction to Algorithms 3판, 11장 “Hash Tables”. 11.2절에서 칸에 매다는 방식(chaining)은 “키가 칸에 고르게 흩어진다”는 가정 아래 찾기의 평균 시간이 Θ(1 + α)이고, α는 칸 하나당 평균 키 수(n/m)다. 11.4절이 빈칸을 찾아 넣는 방식(open addressing)이다. 파이썬 dict는 open addressing을 쓴다. [증명 생략: CLRS 11.2] ↩ ↩2
-
04_hash-dict-set_plot.py로 그렸고, 칸을 고르는 규칙은 04_hash-dict-set_impl.py의 TinyDict와 같다(칸에 매달기, 키 수가 칸 수를 넘으면 두 배). 무작위 정수 키 2,000개를 넣는 동안 칸 하나당 키 수가 늘 1 이하이고 처음 8개 뒤로는 0.5보다 크다는 것, 딕셔너리 찾기는 평균 2번 미만이고 리스트는 1,000.5번이라는 것을 같은 코드로 확인했다. ↩
-
Python Wiki, “TimeComplexity”의 dict, set 항목. 평균과 최악 비용을 함께 싣는다. ↩
-
Python 3.7 “What’s New”: 딕셔너리가 넣은 순서를 지키는 것이 언어 명세의 일부가 되었다. 표준 라이브러리 문서 “Mapping Types — dict”에도 순서 보장이 적혀 있다. ↩ ↩2
-
Python 3 표준 라이브러리 문서,
collections.Counter,collections.defaultdict. ↩