여러 증거에 점수를 매겨 합한 뒤, 합이 기준을 넘으면 “예”, 아니면 “아니오”라고 답하는 투표기다. 틀릴 때마다 점수 배분을 고쳐 스스로 배운다. 직선(평면) 하나로 두 무리를 가를 수 있는 문제라면 반드시 끝에 가서 다 맞히지만, XOR처럼 직선 하나로 못 가르는 문제는 아무리 오래 배워도 못 맞힌다. 이 한계를 넘으려고 층을 쌓은 것이 오늘날의 신경망이다.
먼저 비교해 보기
표를 펼치기 전에, 생물 뉴런의 각 부품이 퍼셉트론의 무엇에 해당하는지 먼저 적어 본다.
| 생물 뉴런 (뉴런과 신호 전달 ~ 흥분성과 억제성 시냅스) | 퍼셉트론 |
|---|---|
| 수상돌기로 들어오는 여러 입력 | ? |
| 흥분성·억제성 시냅스의 세기 | ? |
| 세포체에서 입력을 모아 합함 | ? |
| 발화 문턱 | ? |
| 전부 아니면 전무인 발화 | ? |
| 경험에 따라 시냅스 세기가 바뀜 | ? |
대응 관계
| 생물 뉴런 | 퍼셉트론 | 공통 구조 |
|---|---|---|
| 여러 입력 | 입력 벡터 \(\mathbf{x}\) | 여러 신호가 한 단위로 모인다 |
| 시냅스 세기 (흥분 +, 억제 −) | 가중치 \(\mathbf{w}\) (양수·음수) | 입력마다 영향력이 다르다 |
| 세포체의 합산 | \(\mathbf{w} \cdot \mathbf{x}\) | 가중 합 |
| 발화 문턱 | \(-b\) (합이 \(-b\)를 넘으면 1) | 문턱과의 비교 |
| 전부 아니면 전무 | 계단 함수 출력 0 또는 1 | 이진 출력 |
| 시냅스 가소성 | 학습 규칙 \(\mathbf{w} \leftarrow \mathbf{w} + \eta(t - y)\mathbf{x}\) | 경험으로 가중치가 바뀐다 |
대응이 깨지는 곳도 있다. 실제 뉴런은 0/1 한 번이 아니라 시간에 따라 스파이크를 여러 번 내고 세기는 발화율로 전한다(발화율 부호화). 또 뇌의 시냅스는 “정답 \(t\)와 출력 \(y\)의 차이”를 직접 받아 고쳐지지 않는다1.
예시로 보기
입력 둘의 AND를 배운다. 처음에 \(\mathbf{w} = (0, 0)\), \(b = 0\), 학습률 \(\eta = 1\)이고, 네 점을 \((0,0), (0,1), (1,0), (1,1)\) 순서로 한 바퀴(epoch)씩 돈다. 출력은 \(\mathbf{w}\cdot\mathbf{x} + b > 0\)이면 1이다2.
| 바퀴 | 입력 \(\mathbf{x}\) | 정답 \(t\) | 출력 \(y\) | 고친 뒤 \(\mathbf{w}\) | 고친 뒤 \(b\) |
|---|---|---|---|---|---|
| 1 | (0,0) | 0 | 0 | (0,0) | 0 |
| 1 | (0,1) | 0 | 0 | (0,0) | 0 |
| 1 | (1,0) | 0 | 0 | (0,0) | 0 |
| 1 | (1,1) | 1 | 0 ✗ | (1,1) | 1 |
| 2 | (0,0) | 0 | 1 ✗ | (1,1) | 0 |
| 2 | (0,1) | 0 | 1 ✗ | (1,0) | −1 |
| 2 | (1,0) | 0 | 0 | (1,0) | −1 |
| 2 | (1,1) | 1 | 0 ✗ | (2,1) | 0 |
| 3~5 | … | 틀림 3, 2, 1번 | … | … | |
| 6 | 네 점 모두 | 모두 맞음 | (2,1) | −2 |
틀린 횟수는 모두 10번이다. 최종 경계는 \(2x_1 + x_2 - 2 = 0\)인 직선이다.
x2
 1 │ ○(0,1)      ●(1,1)      ● : 출력 1
   │      ╲                  ○ : 출력 0
   │        ╲  2x1 + x2 = 2
 0 │ ○(0,0)   ╲○(1,0)
   └──────────────── x1
     0          1
\((1, 0)\)은 직선 위에 딱 걸친다. 합이 0이고 “0보다 클 때만 1”이라 0으로 분류된다. 경계 위의 점을 어느 쪽으로 볼지는 부등호 하나로 갈리는 경계 사례다.
정의
퍼셉트론은 입력마다 가중치를 곱해 더하고 바이어스를 더한다. 그 값이 0보다 크면 1, 아니면 0을 내놓는다. 틀린 답을 내면 정답 쪽으로 가중치와 바이어스를 조금 고치고, 맞으면 그대로 둔다.
기호로 쓰면.
- 입력: \(\mathbf{x} \in \mathbb{R}^D\)(실수 \(D\)개짜리 목록). 매개변수: 가중치 \(\mathbf{w} \in \mathbb{R}^D\), 바이어스 \(b \in \mathbb{R}\).
- 출력: \(y = 1\) (\(\mathbf{w}\cdot\mathbf{x} + b > 0\)), \(y = 0\) (그 밖).
- 학습 규칙: 정답이 \(t \in \{0, 1\}\)인 샘플마다 \(\mathbf{w} \leftarrow \mathbf{w} + \eta\,(t - y)\,\mathbf{x}\), \(b \leftarrow b + \eta\,(t - y)\). 학습률 \(\eta > 0\)(\(\eta\)는 에타, 한 번에 고치는 크기). 맞히면 \(t - y = 0\)이라 아무것도 바뀌지 않는다.
뉴런의 연산 모형 \(a(A\mathbf{x} + \mathbf{b})\)에서 출력이 하나(\(R = 1\))이고 활성 함수가 계단 함수인 경우다. \(\mathbf{w}\cdot\mathbf{x} + b = 0\)은 입력 공간을 둘로 나누는 초평면(2차원이면 직선)이다.
학습 규칙이 하는 일은 한 문장이다. 1이어야 하는데 0을 냈으면(\(t - y = 1\)) 가중치를 그 입력 쪽으로 당기고, 0이어야 하는데 1을 냈으면(\(t - y = -1\)) 밀어낸다. 맞히면 \(t - y = 0\)이라 그대로다.
PERCEPTRON-TRAIN(samples, η):
    w ← 0, b ← 0
    repeat
        errors ← 0
        for (x, t) in samples:
            y ← 1 if w·x + b > 0 else 0
            if y ≠ t:
                w ← w + η(t − y)x
                b ← b + η(t − y)
                errors ← errors + 1
    until errors = 0
한 바퀴는 \(O(nD)\) 시간이다(\(n\)은 샘플 수). 몇 바퀴 만에 끝나는지는 아래 수렴 정리가 틀린 횟수로 묶어 준다. 선형으로 가를 수 없는 데이터에서는 끝나지 않는다.
증명
XOR은 퍼셉트론 하나로 풀 수 없다. 네 점이 요구하는 부등식을 모으면 모순이 나온다(귀류법).
증명 펼치기
XOR은 \((0,0) \to 0\), \((0,1) \to 1\), \((1,0) \to 1\), \((1,1) \to 0\)이다. 이를 맞히는 \(w_1, w_2, b\)가 있다고 하자.
- \((0,0) \to 0\): \(b \le 0\) — 출력이 0이려면 합이 0 이하
- \((1,1) \to 0\): \(w_1 + w_2 + b \le 0\)
- \((1,0) \to 1\): \(w_1 + b > 0\)
- \((0,1) \to 1\): \(w_2 + b > 0\)
- 3과 4를 더하면 \(w_1 + w_2 + 2b > 0\), 곧 \(w_1 + w_2 + b > -b\)
- 1에서 \(-b \ge 0\)이므로 \(w_1 + w_2 + b > 0\)
- 6은 2와 모순이다. 그런 \(w_1, w_2, b\)는 없다.
선형으로 가를 수 있으면 반드시 끝난다(퍼셉트론 수렴 정리). [증명 스케치] 바이어스를 입력 1로 흡수해 \(\mathbf{x}\) 끝에 1을 붙이자. 모든 샘플이 \(\lVert\mathbf{x}\rVert \le R\)이고, 길이 1인 어떤 \(\mathbf{w}^*\)가 모든 샘플을 여백 \(\gamma > 0\) 이상으로 가른다고 하자. 그러면 틀리는 횟수는 \((R/\gamma)^2\) 이하다3.
증명 스케치 펼치기
부호를 \(s = 2t - 1 \in \{-1, +1\}\)로 바꿔 쓰면, \(\eta = 1\)일 때 틀릴 때마다 \(\mathbf{w} \leftarrow \mathbf{w} + s\,\mathbf{x}\)다. \(k\)번 틀린 뒤의 가중치를 \(\mathbf{w}_k\)라 하자(\(\mathbf{w}_0 = \mathbf{0}\)).
- \(\mathbf{w}_k \cdot \mathbf{w}^* \ge k\gamma\) — 틀릴 때마다 \(s\,\mathbf{x}\cdot\mathbf{w}^* \ge \gamma\)만큼 는다(여백의 정의)
- \(\lVert\mathbf{w}_k\rVert^2 \le kR^2\) — 틀렸다는 것은 \(s\,\mathbf{w}\cdot\mathbf{x} \le 0\)이라서 \(\lVert\mathbf{w} + s\mathbf{x}\rVert^2 \le \lVert\mathbf{w}\rVert^2 + R^2\)
- \(k\gamma \le \mathbf{w}_k\cdot\mathbf{w}^* \le \lVert\mathbf{w}_k\rVert \le \sqrt{k}\,R\) — 코시-슈바르츠 부등식, \(\lVert\mathbf{w}^*\rVert = 1\)
- 양변을 정리하면 \(k \le (R/\gamma)^2\)
예제
두 층으로 XOR 만들기. XOR은 “OR이면서 NAND”다. 첫 층에 두 퍼셉트론을 두고 둘째 층에서 AND를 한다2.
| 단위 | \(\mathbf{w}\) | \(b\) | 하는 일 |
|---|---|---|---|
| \(h_1\) | \((1, 1)\) | \(-0.5\) | OR |
| \(h_2\) | \((-1, -1)\) | \(1.5\) | NAND |
| \(y\) | \((1, 1)\) (입력 \(h_1, h_2\)) | \(-1.5\) | AND |
flowchart LR
  X1["x1"] -- "1" --> H1["h1: OR, b = -0.5"]
  X2["x2"] -- "1" --> H1
  X1 -- "-1" --> H2["h2: NAND, b = 1.5"]
  X2 -- "-1" --> H2
  H1 -- "1" --> Y["y: AND, b = -1.5"]
  H2 -- "1" --> Y
선 위의 숫자가 가중치다. 입력 둘이 첫 층의 두 퍼셉트론에 모두 들어가고, 둘째 층은 첫 층의 두 출력만 받는다4.
첫 층이 입력 공간을 두 직선으로 자르고, 둘째 층이 두 결과를 조합한다. 직선 하나로 못 하는 일을 직선 둘과 그 조합으로 한다. 층 사이의 계단 함수(비선형)가 없으면 두 층이 한 층으로 줄어들어 이 일도 못 한다(뉴런의 연산 모형의 증명).
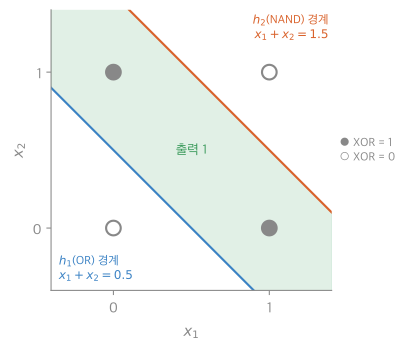
파란 선 위쪽이 \(h_1 = 1\), 주황 선 아래쪽이 \(h_2 = 1\)이다. 둘 다 1인 곳은 두 선 사이의 띠뿐이고, 꽉 찬 점 \((0, 1)\), \((1, 0)\)만 그 안에 든다5.
신호·머신러닝·인공지능 관점
신호. \(\mathbf{w}\cdot\mathbf{x}\)는 입력이 템플릿 \(\mathbf{w}\)와 얼마나 닮았는지 재는 상관이고, 문턱과 비교하는 것은 “그 무늬가 있다/없다”를 가르는 검출이다. 신호처리의 정합 필터(matched filter)와 문턱 판정을 붙인 검출기와 같은 구조다. 같은 퍼셉트론을 이미지의 모든 위치에 옮겨 적용하면 합성곱과 문턱이 되고, 무늬가 있는 곳의 지도가 나온다. 합성곱으로 무늬를 찾는 계산(패턴 검출)이 바로 이것이다6.
머신러닝. 퍼셉트론은 가장 단순한 선형 분류기다. 데이터를 한 개씩 보며 고치는 온라인 학습이고, 규칙은 “틀린 샘플에 대해서만 손실을 줄이는 방향으로 한 걸음” 가는 확률적 경사 하강과 같은 꼴이다. 계단 함수는 미분할 수 없어서, 층을 여럿 쌓아 오차를 거꾸로 전파하려면(역전파) 시그모이드나 ReLU처럼 미분할 수 있는 활성 함수로 바꾼다. 은닉층을 둔 다층 퍼셉트론(MLP)은 XOR을 풀고, 은닉 뉴런이 충분하면 연속 함수를 원하는 만큼 가깝게 근사할 수 있다(보편 근사 정리)7.
인공지능. 역사로 보면 이 과목의 뉴런 모형이 인공지능의 한 줄기다8.
| 연도 | 사건 | 의미 |
|---|---|---|
| 1943 | McCulloch & Pitts의 문턱 뉴런 | 뉴런 연결로 AND·OR·NOT 같은 논리를 계산할 수 있음을 보임 |
| 1958 | Rosenblatt의 퍼셉트론 | 가중치를 데이터에서 스스로 배우는 기계 |
| 1969 | Minsky & Papert, Perceptrons | 단층 퍼셉트론의 한계(XOR 등)를 증명. 신경망 연구가 한동안 식음 |
| 1986 | Rumelhart, Hinton & Williams의 역전파 | 다층 신경망을 학습하는 방법이 퍼지며 연결주의가 되살아남 |
| 2012 | 깊은 합성곱 신경망(AlexNet)의 이미지 인식 성공 | 딥러닝 시대의 시작 |
지능 시스템의 네 칸으로 보면, 퍼셉트론은 뇌의 구조를 본떴다는 점에서 “사람처럼 생각”에 뿌리를 두지만, 평가는 “틀린 횟수를 줄이는가”라는 “이성적으로 행동”의 기준으로 받는다.
활용
- 논리 게이트: AND, OR, NAND는 퍼셉트론 하나로 된다. NAND만으로 모든 논리 회로를 만들 수 있으므로, 퍼셉트론을 여러 층 연결하면 어떤 논리 함수든 만들 수 있다8.
- 흔한 실수: 선형으로 가를 수 없는 데이터에 단층 퍼셉트론을 돌리고 “학습이 덜 됐다”며 바퀴 수만 늘린다. 끝나지 않는 이유는 시간이 아니라 구조다.
연결
자주 하는 오해
틀렸다. AND·OR은 몇 바퀴 만에 끝나니 XOR도 시간 문제로 보이기 쉽다. 실제로는 XOR을 맞히는 \(w_1, w_2, b\)가 아예 없다(위 증명). 학습 규칙은 없는 답을 찾지 못하고 가중치가 계속 돌기만 한다. 확인 방법: 증명의 부등식 네 개를 직접 더해 보거나, 검증 코드에서 1,000바퀴를 돌려도 끝나지 않고 정수 격자 전수 조사에서도 해가 없음을 본다.
확인 문제
C1 학습 규칙 \(\mathbf{w} \leftarrow \mathbf{w} + \eta(t - y)\mathbf{x}\)가 하는 일을 쉬운 말로 한 문장에 쓰라. 맞혔을 때는 어떻게 되는가?
답: 틀렸을 때만, 1이어야 할 입력이면 가중치를 그 입력 쪽으로 당기고 0이어야 할 입력이면 그 입력에서 밀어낸다. 맞히면 \(t - y = 0\)이라 바뀌지 않는다.
C2 AND 학습 중 \(\mathbf{w} = (1, 1)\), \(b = 1\), \(\eta = 1\)인 상태에서 \((0, 0)\)(정답 0)과 \((0, 1)\)(정답 0)을 차례로 넣었다. 각각 처리한 뒤의 \(\mathbf{w}\)와 \(b\)는?
답: \((0,0)\): 합 \(= 1 > 0\)이라 \(y = 1\), 틀림. \(\mathbf{x} = (0,0)\)이라 \(\mathbf{w}\)는 \((1, 1)\) 그대로, \(b = 1 - 1 = 0\). \((0,1)\): 합 \(= 1 + 0 = 1 > 0\)이라 \(y = 1\), 틀림. \(\mathbf{w} = (1,1) - (0,1) = (1, 0)\), \(b = 0 - 1 = -1\).
흔한 오답: 입력이 \((0,0)\)일 때도 \(\mathbf{w}\)가 바뀐다고 쓴다. 입력 성분이 0이면 그 가중치는 고쳐지지 않고 바이어스만 바뀐다.
C3 XOR을 퍼셉트론 하나로 풀 수 없는 이유를 부등식으로 보이고, 두 층으로는 어떻게 푸는지 쓰라.
답: \(b \le 0\), \(w_1 + w_2 + b \le 0\), \(w_1 + b > 0\), \(w_2 + b > 0\)이 모두 필요하다. 뒤의 둘을 더하면 \(w_1 + w_2 + b > -b \ge 0\)이라 둘째 식과 모순이다. 두 층이면 첫 층에서 OR과 NAND를 만들고 둘째 층에서 둘을 AND 한다.
-
뇌의 학습은 헤브 규칙(“함께 발화하는 뉴런은 연결이 강해진다”) 같은 국소 규칙으로 설명되며, 퍼셉트론처럼 정답과의 차이를 직접 쓰지 않는다. ↩
-
퍼셉트론의 정의, AND 추적, 두 층 XOR 가중치는 표준 교재 내용이다. 추적 표와 가중치는 검증 코드의 실행 결과와 대조했다. ↩ ↩2
-
퍼셉트론 수렴 정리는 Novikoff(1962)의 결과다. ↩
-
이 문서 예제의 두 층 XOR 표(가중치와 바이어스)를 그대로 옮겨 그렸다. ↩
-
08_perceptron_plot.py로 그렸고, 그림에 쓴 값(두 층 XOR이 네 점을 모두 맞히고, 출력 1인 점이 \(0.5 < x_1 + x_2 < 1.5\)인 띠 안에만 있음)을 같은 코드로 확인했다. ↩
-
합성곱 신경망의 한 층은 “같은 가중치를 모든 위치에 적용한 퍼셉트론 무리”로 볼 수 있다. ↩
-
확률적 경사 하강과의 관계, 역전파, 보편 근사 정리(Cybenko 1989, Hornik 1991)는 머신러닝 교재의 표준 내용이다. ↩