뉴런을 계산기로 보면, 여러 입력에 각각 무게를 곱해 더하고 그 결과를 정해진 범위 안으로 눌러 담는 장치다. 무게가 양수면 흥분, 음수면 억제다. 이 단순한 식 하나로 수렴·억제 같은 신경 회로를 계산할 수 있고, 인공 신경망의 기본 단위가 된다. 대신 시간에 따른 스파이크 하나하나와 화학적 변화는 버린다.
예시로 보기
입력 셋을 받는 뉴런이 있다. 첫째·둘째 입력은 흥분성 시냅스(무게 +1), 셋째는 억제성 시냅스(무게 −1)로 들어온다1.
| 입력 발화율 \(\mathbf{x}\) | 무게를 곱해 더함 \(o\) | 실제 발화율 \(a(o)\) |
|---|---|---|
| \((3, 2, 4)\) | \(3 + 2 - 4 = 1\) | \(1\) |
| \((1, 0, 4)\) | \(1 + 0 - 4 = -3\) | \(0\) |
두 번째 줄에서 합은 −3이다. 발화율은 음수가 될 수 없으므로 실제 출력은 0이다. 반대로 합이 아무리 커도 발화율은 초당 수백 회를 넘지 못한다(발화율 부호화). 합을 현실의 범위로 눌러 담는 함수가 활성 함수 \(a\)다.
생물의 부품과 식의 기호는 이렇게 대응한다1.
| 생물 뉴런 | 식 |
|---|---|
| 들어오는 입력들의 발화율 | 입력 벡터 \(\mathbf{x}\) |
| 시냅스의 종류와 세기 (흥분 +, 억제 −) | 행렬 \(A\)의 성분 |
| 입력이 없을 때의 기본 활동 | 바이어스 \(\mathbf{b}\) |
| 발화율의 하한 0과 상한 | 활성 함수 \(a(\cdot)\) |
정의
뉴런을 계산할 수 있는 식으로 만드는 과정은 다섯 단계로 나뉜다.
- 입력과 출력이 있다 → 함수로 본다.
- 입력은 여럿이다: \(\mathbf{x} = [x_1, \dots, x_D]^\top\)(\(^\top\)는 행과 열을 바꾸는 전치). 출력도 여럿일 수 있다: \(\mathbf{o} = [o_1, \dots, o_R]^\top\).
- 전달 함수 \(\mathbf{o} = f(\mathbf{x})\).
- 뉴런의 기능이 선형이라면 \(f\)는 선형 함수다.
- 출력값에 최대·최소가 있다면(출력이 한정되면) 활성 함수 \(a\)를 씌운다.
입력 \(\mathbf{x}\)는 수 \(D\)개짜리 목록, \(A\)는 \(R\)행 \(D\)열의 변환 행렬, \(\mathbf{b}\)는 수 \(R\)개짜리 바이어스, \(a\)는 활성 함수로 성분마다 따로 적용한다. 즉 출력 \(R\)개 하나하나가 “입력에 무게를 곱해 더하고, 바이어스를 더하고, 범위 안으로 눌러 담은 값”이다. 성분으로 쓰면 \(o'_r = a\bigl(\sum_{d=1}^{D} A_{rd}\, x_d + b_r\bigr)\)(\(\sum\)은 차례로 모두 더한다는 기호), \(r = 1, \dots, R\)이다.
flowchart LR
  X1["입력 x1"] -- "× A_r1" --> S["모두 더하기"]
  X2["입력 x2"] -- "× A_r2" --> S
  XD["입력 xD"] -- "× A_rD" --> S
  B["바이어스 b_r"] --> S
  S -- "o_r" --> A["활성 함수 a"]
  A --> O["출력 o'_r"]
출력 하나는 이 세 칸을 왼쪽부터 지나서 나온다. 무게를 곱하고, 모두 더하고, 범위 안으로 누른다. 출력이 \(R\)개면 이 그림이 \(R\)벌 있고, 벌마다 \(A\)의 다른 행을 쓴다.
바이어스 \(\mathbf{b}\)의 크기는 입력 수 \(D\)가 아니라 출력 수 \(R\)을 따른다. \(A\)(\(R \times D\))에 \(\mathbf{x}\)(\(D \times 1\))를 곱하면 \(R \times 1\)이 나오고, 여기에 더하는 \(\mathbf{b}\)도 \(R \times 1\)이어야 하기 때문이다. \(\mathbf{b}\)를 \(D \times 1\)로 잡으면 \(R \ne D\)일 때 덧셈이 안 된다. 예를 들어 \(R = 2\), \(D = 3\)이면 \(2 \times 1\)에 \(3 \times 1\)을 더할 수 없다.
활성 함수의 예는 다음과 같다2.
| 이름 | 식 | 출력 범위 | 생물과의 대응 |
|---|---|---|---|
| 계단 함수 | \(1\ (o > 0)\), \(0\) (그 밖) | \(\{0, 1\}\) | 발화하느냐 마느냐 |
| 자르기 | \(\min(\max(o, 0), r_{\max})\) | \([0, r_{\max}]\) | 발화율의 하한 0과 상한 |
| ReLU | \(\max(0, o)\) | \([0, \infty)\) | 하한 0만 반영 |
| 시그모이드 | \(1 / (1 + e^{-o})\) | \((0, 1)\) | 부드럽게 포화하는 발화율 곡선 |
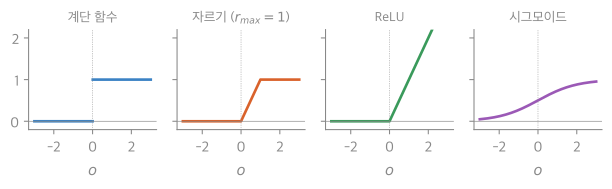
네 함수 모두 합이 0보다 작으면 출력을 낮게 누른다. 위쪽은 서로 다르다. 계단·자르기·시그모이드는 1에서 멈추고, ReLU만 끝없이 올라간다3.
증명
활성 함수가 없으면 층을 아무리 쌓아도 층 하나와 같다. 행렬 곱의 분배법칙과 결합법칙만으로 보인다.
증명 펼치기
두 층 \(\mathbf{h} = A_1\mathbf{x} + \mathbf{b}_1\), \(\mathbf{o} = A_2\mathbf{h} + \mathbf{b}_2\)가 있다고 하자.
- \(\mathbf{o} = A_2(A_1\mathbf{x} + \mathbf{b}_1) + \mathbf{b}_2\) — 대입
- \(= A_2A_1\mathbf{x} + A_2\mathbf{b}_1 + \mathbf{b}_2\) — 행렬 곱의 분배법칙
- \(= (A_2A_1)\mathbf{x} + (A_2\mathbf{b}_1 + \mathbf{b}_2)\) — 결합법칙
- \(A' = A_2A_1\), \(\mathbf{b}' = A_2\mathbf{b}_1 + \mathbf{b}_2\)로 두면 \(\mathbf{o} = A'\mathbf{x} + \mathbf{b}'\), 곧 층 하나다.
\(k\)층이면 같은 논리를 \(k - 1\)번 되풀이한다(수학적 귀납법).
신호·머신러닝·인공지능 관점
같은 식을 세 분야가 다르게 읽는다.
신호. \(A\mathbf{x} + \mathbf{b}\)는 선형(엄밀히는 아핀) 시스템이다. 입력 둘을 더해 넣으면 출력도 더해진다(중첩의 원리). \(A\)의 한 행 \(\mathbf{w}\)와 입력의 곱 \(\mathbf{w} \cdot \mathbf{x} = \lVert\mathbf{w}\rVert\,\lVert\mathbf{x}\rVert \cos\theta\)(\(\lVert\cdot\rVert\)는 벡터의 길이)는 입력이 \(\mathbf{w}\)와 같은 방향일 때 가장 크다(코시-슈바르츠 부등식). 그래서 \(\mathbf{w}\)는 “찾고 싶은 무늬(템플릿)”이고, 곱은 입력이 그 무늬와 얼마나 닮았는지 재는 상관(correlation)이다. 같은 \(\mathbf{w}\)를 이미지 위치마다 옮겨 가며 곱하면 합성곱이 된다. 합성곱으로 무늬를 찾는 계산(패턴 검출)이 바로 이것이다. 선형 단계 뒤에 비선형 함수 하나를 붙인 구조는 계산 신경과학에서 선형-비선형(LN) 모형이라 부르는 표준 모형과 같다4.
머신러닝. \(a(W\mathbf{x} + \mathbf{b})\)는 인공 신경망의 완전 연결층(fully connected layer) 하나다. 머신러닝 교재는 보통 변환 행렬을 \(W\)(weight)로 쓴다. 차이는 \(W\)와 \(\mathbf{b}\)를 사람이 정하지 않고 데이터로 학습한다는 점이다. 층을 쌓아 깊은 신경망을 만들 때 활성 함수가 꼭 있어야 하는 이유가 위의 증명이다. 비선형 함수가 없으면 100층을 쌓아도 1층짜리 선형 모델과 표현력이 같다2. 출력이 하나이고 활성 함수가 계단 함수인 경우가 퍼셉트론이다.
인공지능. 이 식은 지식을 규칙이 아니라 숫자(가중치)에 담는다. 규칙과 기호로 지능을 만들려는 기호주의(symbolic AI)와 달리, 단순한 단위를 많이 연결해 지능을 만들려는 연결주의(connectionism)의 출발점이다. 뇌의 구조에서 영감을 얻었다는 점에서 지능 시스템의 “사람처럼 생각” 쪽에 뿌리가 있다5.
활용
- 세 가지 수렴 회로를 이 식으로 모델링한다: 뉴런 수렴 모델링 연습
- 측면 억제, 중심-주변 수용장도 \(A\)의 부호 배치(가운데 +, 둘레 −)만 다른 같은 식이다.
연결
- 선수: 발화율 부호화 (출력의 범위), 흥분성과 억제성 시냅스 (가중치의 부호)
- 특수한 경우: 퍼셉트론 (출력 하나, 계단 함수, 학습 규칙)
- 이 식으로 푸는 회로: 뉴런의 수렴
자주 하는 오해
틀렸다. 위 정의의 5단계처럼 활성 함수를 “출력값이 한정될 때” 붙이는 것으로 배우면 범위 조정용으로만 보이기 쉽다. 범위 조정도 맞는 역할이지만, 더 중요한 역할은 비선형성이다. 활성 함수가 없으면 층을 몇 개 쌓든 \(A'\mathbf{x} + \mathbf{b}'\) 하나로 줄어든다. 그러면 XOR처럼 직선 하나로 가를 수 없는 문제를 영원히 풀지 못한다. 확인 방법: 위 증명의 네 줄, 그리고 퍼셉트론의 XOR 예.
확인 문제
C1 입력 \(D\)개, 출력 \(R\)개인 뉴런 층의 연산 모형을 식으로 쓰고, \(A\), \(\mathbf{x}\), \(\mathbf{b}\), \(\mathbf{o}'\)의 크기를 쓰라. 흥분성·억제성 시냅스는 식의 어디에 나타나는가?
답: \(\mathbf{o}' = a(A\mathbf{x} + \mathbf{b})\). \(A\)는 \(R \times D\), \(\mathbf{x}\)는 \(D \times 1\), \(\mathbf{b}\)와 \(\mathbf{o}'\)는 \(R \times 1\). 흥분성은 \(A\)의 양수 성분, 억제성은 음수 성분이다.
흔한 오답: \(\mathbf{b}\)를 입력 수에 맞춰 \(D \times 1\)로 쓴다.
C2 바이어스 \(\mathbf{b}\)를 입력 수에 맞춰 \(D \times 1\)로 두면 계산이 되지 않는 구체적인 경우를 하나 들라. 언제는 우연히 계산이 되는가?
답: \(R = 2\), \(D = 3\)이면 \(A\mathbf{x}\)는 \(2 \times 1\)인데 \(\mathbf{b}\)는 \(3 \times 1\)이라 더할 수 없다. \(R = D\)일 때만 크기가 우연히 맞는다.
C3 활성 함수 없이 선형 층 두 개 \(A_1\mathbf{x} + \mathbf{b}_1\), \(A_2\mathbf{h} + \mathbf{b}_2\)를 쌓으면 무엇과 같아지는가? 그래서 활성 함수가 해야 하는 일은 무엇인가?
답: \((A_2A_1)\mathbf{x} + (A_2\mathbf{b}_1 + \mathbf{b}_2)\), 곧 선형 층 하나와 같다. 활성 함수는 출력을 현실 범위로 한정하는 일과 함께, 비선형성을 넣어 층을 쌓는 의미가 생기게 한다.
-
07_neuron-computational-model_plot.py로 그렸고, 그림에 쓴 값(계단 출력 \(\{0, 1\}\), 자르기 \([0, 1]\), ReLU 하한 0, 시그모이드\((0) = 0.5\))을 같은 코드로 확인했다. ↩
-
템플릿·상관·합성곱 해석은 코시-슈바르츠 부등식에서 나온다. 선형-비선형(LN) 모형은 망막 신경절 세포 같은 뉴런의 반응을 설명하는 계산 신경과학의 표준 모형이다. ↩
-
기호주의와 연결주의의 구분은 인공지능 교과서(예: Russell & Norvig, Artificial Intelligence: A Modern Approach)의 표준 구분이다. ↩