보내는 쪽과 받는 쪽이 비트 모양 하나(젯수)를 미리 정해 둔다. 보내는 쪽은 메시지 뒤에 몇 비트를 붙여 전체가 젯수로 나누어떨어지게 만들고, 받는 쪽은 받은 비트 전체를 같은 젯수로 나눠 나머지가 0인지 본다. 이 “나누기”는 보통의 나눗셈이 아니라, 자리마다 두 비트가 같으면 0·다르면 1을 쓰는 연산(XOR)을 자리올림 없이 되풀이하는 것이라 하드웨어가 거의 공짜로 계산한다. 젯수를 잘 고르면 32비트로도 오류를 거의 다 잡지만, 오류 모양이 젯수의 배수와 같으면 놓친다.
예시로 보기
패리티 비트 하나는 비트 두 개가 함께 뒤집히면 1의 개수가 다시 짝수가 되어 오류를 놓친다(오류 검출 코드). 덧붙이는 값이 데이터의 더 많은 비트와 얽혀 있어야 이런 구멍이 줄어든다. CRC는 더하기보다 복잡한 나누기를 쓰고, 그 나머지를 오류 검출 코드로 덧붙여 보낸다.
이름도 이 일을 그대로 말한다. 중복(redundancy)은 데이터에 덧붙이는 여분 비트이고, 검사(check)는 그 비트로 오류를 검사한다는 뜻이다. 순회(cyclic)는 이 방식이 뿌리를 둔 순환 부호(cyclic code)라는 수학 이론에서 온 말이다.
나머지로 오류를 잡는 생각은 10진수로 먼저 보면 쉽다(실제 CRC는 10진 연산을 쓰지 않는다). 두 사람이 젯수 11을 약속했다. 보내는 쪽은 데이터 331 뒤에 한 자리 \(x\)를 붙여, 네 자리 수 \(331x\)가 11로 나누어떨어지게 만든다.
\(x\)는 이렇게 찾는다. 먼저 빈자리에 0을 넣은 3310을 11로 나눈다. \(3310 = 11 \times 300 + 10\)이라 나머지가 10이다. 다음 11의 배수까지 1이 모자란다. 그래서 끝자리에 1을 넣어 3311을 만든다. 확인하면 \(11 \times 301 = 3300 + 11 = 3311\)이다. 보내는 쪽은 3311을 보낸다.
받는 쪽은 받은 네 자리 수를 통째로 11로 나눈다.
| 받은 수 | 11로 나눈 나머지 | 판단 |
|---|---|---|
| 3311 | 0 | 오류 없다고 본다 |
| 3310 | 0 아님 | 오류 검출 |
| 2311 | 0 아님 | 오류 검출 |
| 2211 | 0 | 오류를 놓침 |
표를 한 줄씩 계산해 보면 이렇다. 3311은 \(11 \times 301\)이라 나머지 0이다. 끝자리가 망가진 3310은 위에서 본 대로 나머지가 10이다. 첫 자리가 망가진 2311은 \(2311 = 11 \times 210 + 1\)이라 나머지가 1이다. 둘 다 0이 아니니 받는 쪽은 오류를 알아챈다.
2211은 \(11 \times 201\)이라 나머지가 0이다. 두 자리나 망가졌는데 받는 쪽은 아무 일 없다고 본다. 어? 왜 이것만 못 잡을까? 보낸 수와 받은 수의 차이를 보면 \(3311 - 2211 = 1100 = 11 \times 100\)이다. 오류가 뺀 양이 마침 11의 배수다. 11의 배수에서 11의 배수를 빼면 또 11의 배수라 나머지가 0으로 남는다. CRC가 놓치는 오류도 같은 모양이다(아래 ‘받는 쪽 점검’에서 다시 본다).
붙이는 자리 수는 (젯수의 자리 수 − 1)이다. 젯수 11은 두 자리라 한 자리를 붙였다. 젯수를 10으로 정하면 어떨까? 10으로 나눈 나머지는 끝자리 하나로 정해진다. 보내는 쪽은 늘 끝에 0을 붙여 3310을 보내고, 받는 쪽은 끝자리만 본다. 앞자리가 망가져 2310이 와도 나머지가 0이라 앞자리 오류는 하나도 못 잡는다. 검출율은 젯수를 어떻게 고르느냐에 달려 있다.
10진 비유가 어긋나는 곳도 있다. 데이터가 21이면 210을 11로 나눈 나머지가 1이라, 끝자리에 10을 넣어야 220이 된다. 한 자리에 10은 들어가지 않는다. 아래에서 볼 XOR 나눗셈에서는 나머지가 언제나 붙인 자리 수 안에 들어가서 이런 일이 생기지 않는다1.
정의
입력: 메시지 \(M\), 약속한 \((k + 1)\)비트 젯수 \(C\). 출력: \(M\) 뒤에 붙일 \(k\)비트 \(F\)(EDC).
\(F\)는 오류 검출 코드(EDC)이고, 흔히 CRC 값이라고 부른다. 보내는 쪽은 \((M \Vert F) \bmod C = 0\)이 되도록 \(F\)를 만든다. 여기서 \(M \Vert F\)는 \(M\) 뒤에 \(F\)를 이어 붙인 비트열이고, \(\bmod C\)는 \(C\)로 나눈 나머지다. 식 전체는 “이어 붙인 비트열을 \(C\)로 나누면 나머지가 0”이라는 뜻이다.
곧 \(F\)에 나머지를 넣어 프레임 전체가 \(C\)로 나누어떨어지게 하고 \(M \Vert F\)를 보낸다. 받는 쪽은 받은 프레임 전체를 \(C\)로 나눠 나누어떨어지지 않으면 오류, 나누어떨어지면 오류가 없는 것으로 본다. 예를 들어 \(M = 10011010\), \(C = 1101\)이면 \(F = 101\)이다. \(M \Vert F = 10011010101\)을 1101로 나누면 나머지가 0이다.
XOR로 하는 나눗셈
CRC 나눗셈에서 빼기 자리에 쓰는 연산은 XOR(배타적 논리합)이다. 두 비트가 같으면 0, 다르면 1을 낸다. 기호 \(\oplus\)는 “XOR”이라고 읽는다.
| \(a\) | \(b\) | \(a \oplus b\) |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
여러 자리 비트열끼리는 같은 자리끼리만 XOR한다. 예를 들어 \(1011 \oplus 0110\)은 왼쪽 자리부터 \(1 \oplus 0 = 1\), \(0 \oplus 1 = 1\), \(1 \oplus 1 = 0\), \(1 \oplus 0 = 1\)이라 \(1101\)이다.
보통의 뺄셈과 가장 다른 점은 빌림이 없다는 것이다. 2진수 \(1000 - 0001\)은 끝자리가 앞에서 1을 빌려 오느라 앞의 0들이 줄줄이 바뀌어 \(0111\)이 된다. XOR로는 \(1000 \oplus 0001 = 1001\)이다. 끝자리만 바뀌고 다른 자리는 그대로다. 자리마다 따로 계산하니 회로로 만들기 쉽다.
XOR은 더하기와 빼기가 같은 연산이다. 같은 값을 두 번 XOR하면 원래로 돌아온다. \(1011 \oplus 0110 = 1101\)이고, 여기에 다시 \(0110\)을 XOR하면 \(1101 \oplus 0110 = 1011\)이다. 그래서 CRC에서는 “나머지를 뺀다”와 “나머지를 더한다”가 같은 말이다.
나눗셈에서 지금 들여다보는 \(k + 1\)비트 묶음을 창이라고 부른다. 창은 젯수와 길이가 같다. 규칙은 하나다. 창의 맨 앞이 1이면 그 밑에 \(C\)를 맞춰 놓고 XOR한다. 맨 앞이 0이면 \(C\)를 쓰지 않고 넘어간다. 보통 나눗셈의 “몇 번 들어가나”가 여기서는 1번 아니면 0번뿐이다.
어? \(1001\)은 \(1101\)보다 작은데 빼도 되나? 보통 나눗셈이면 작은 수에서 큰 수를 못 뺀다. XOR 나눗셈은 크기를 비교하지 않는다. 목표는 창의 맨 앞 비트를 0으로 지우는 것뿐이다. 맨 앞이 1이면 \(C\)의 맨 앞 1과 XOR해 반드시 0이 된다. 그래서 크기와 상관없이 맨 앞 비트 하나만 본다1.
다항식으로 보기
\(n\)비트 메시지를 \(n - 1\)차 다항식으로 쓴다. 비트가 1인 자리의 \(x\) 거듭제곱을 더한다. 지수는 오른쪽 끝 자리가 \(x^0\)이고, 왼쪽으로 한 칸 갈 때마다 1씩 커진다. \(C = 1101\)을 한 자리씩 읽으면 다음과 같다.
| 자리 (왼쪽부터) | 1번째 | 2번째 | 3번째 | 4번째 |
|---|---|---|---|---|
| 비트 | 1 | 1 | 0 | 1 |
| 그 자리의 거듭제곱 | \(x^3\) | \(x^2\) | \(x^1\) | \(x^0 = 1\) |
| 식에 넣나 | 넣는다 | 넣는다 | 0이라 뺀다 | 넣는다 |
1인 자리만 더하면 \(x^3 + x^2 + 1\)이다. 최고 차수가 3이라 \(k = 3\)이다. 4비트 젯수가 3차 다항식이 되듯, \((k + 1)\)비트 젯수는 \(k\)차 다항식이다.
- \[M = 10011010 \;\to\; M(x) = x^7 + x^4 + x^3 + x\]
- \(C = 1101 \;\to\; C(x) = x^3 + x^2 + 1\) (\(k = 3\))
계수는 0과 1뿐이고 더하기와 빼기가 모두 XOR이다(\(1 + 1 = 0\), 자리올림 없음). 예를 들어 \((x^3 + x^2 + 1) + (x^2 + x)\)에서는 \(x^2\)이 두 번 나와 계수가 \(1 + 1 = 0\)이 되어 사라진다. 결과는 \(x^3 + x + 1\)이다. 비트로 쓰면 \(1101 \oplus 0110 = 1011\)로, 같은 계산이다.
그래서 나눗셈도 “앞자리가 1이면 젯수를 XOR”의 되풀이다. 나누기라기보다 XOR 연산의 되풀이라는 것을 기억해야 한다.
다항식으로 쓰면 좋은 점이 두 가지 있다. 첫째, 비트열 뒤에 0을 \(k\)개 붙이는 일이 \(x^k\)를 곱하는 일이다. 모든 1이 왼쪽으로 \(k\)칸 옮겨 가기 때문이다. \(M(x) \cdot x^3 = x^{10} + x^7 + x^6 + x^4\)이고, 이것을 비트로 쓰면 \(10011010000\)이다.
둘째, 나머지의 차수는 언제나 젯수의 차수 \(k\)보다 작다. \(k\)보다 작은 차수의 다항식은 \(x^{k-1}\)부터 \(x^0\)까지 계수 \(k\)개로 적힌다. 곧 나머지는 늘 \(k\)비트에 들어간다. 0을 정확히 \(k\)개 붙이는 까닭이 이것이다. 붙인 0 \(k\)개는 나머지가 들어갈 빈자리다1.
보내는 쪽 절차
- \(M(x)\)에 \(x^k\)를 곱한다. 뒤에 0을 \(k\)개 붙여 \(F\)가 들어갈 자리를 만든다: \(10011010\,000\).
- \(C(x)\)로 나눈다.
- 나머지를 더한(XOR한) \(P(x)\)를 보낸다. \(P(x)\)는 \(C(x)\)로 나누어떨어진다.
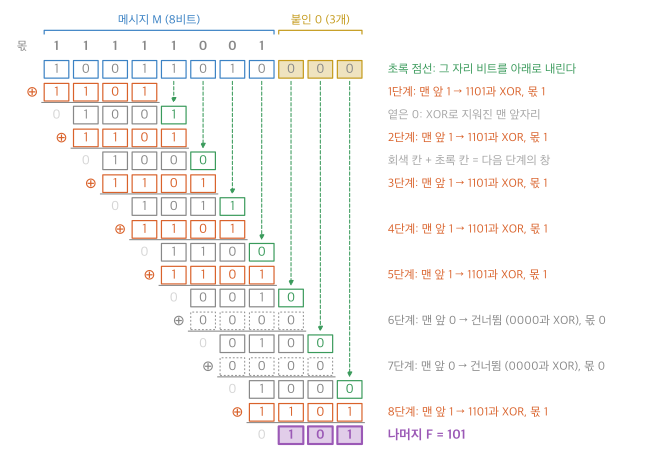
그림 1은 위에서 아래로 읽는다. 맨 윗줄의 파란 칸 8개가 메시지 \(M\)이고, 노란 칸 3개가 붙인 0이다. 그 위의 굵은 숫자 줄이 몫이다. 몫의 각 비트는 바로 아래 열에서 시작하는 창을 \(C\)와 XOR했으면 1, 건너뛰었으면 0이다.
1단계의 창은 맨 왼쪽 4칸 \(1001\)이다. 젯수가 4비트라 창도 4비트다. 맨 앞이 1이니 주황 줄에 \(C = 1101\)을 맞춰 놓고 자리마다 XOR한다. \(1001 \oplus 1101 = 0100\)이다. 맨 앞의 1끼리 만나 0이 되므로, 결과의 맨 앞은 늘 0이다. 그림에서 이 0은 옅게 칠했다. 이 자리는 할 일을 마쳤으니 버린다.
남은 세 칸 \(100\) 옆에, 나눌 수의 다음 비트(5번째 비트 1)를 초록 점선을 따라 내린다. 그러면 2단계의 창 \(1001\)이 된다. 보통 나눗셈에서 “다음 자리를 내린다”와 같은 동작이다.
2단계부터 5단계까지는 같은 일을 되풀이한다. 창은 차례로 \(1001\), \(1000\), \(1011\), \(1100\)이고, 모두 맨 앞이 1이라 \(C\)를 XOR한다. 3단계를 직접 계산하면 \(1000 \oplus 1101 = 0101\)이다. 맨 앞 0을 버린 \(101\) 옆에 다음 비트 1을 내리면 4단계의 창 \(1011\)이 된다.
6단계의 창은 \(0010\)이다. 맨 앞이 0이다. 지울 1이 없으니 \(C\) 대신 \(0000\)을 XOR한다. \(0000\)과 XOR하면 아무것도 바뀌지 않으므로 사실상 건너뛰는 것이다. 몫에는 0을 적는다. 그림의 점선 칸이 이 단계다. 7단계의 창 \(0100\)도 맨 앞이 0이라 같은 이유로 건너뛴다.
8단계의 창 \(1000\)은 맨 앞이 1이라 다시 XOR한다. \(1000 \oplus 1101 = 0101\)이다. 이제 내릴 비트가 남지 않았다. 맨 앞 0을 버린 마지막 3칸 \(101\)이 나머지 \(F\)다(보라 칸).
단계 수는 (나눌 수의 비트 수 − \(k\)) = 11 − 3 = 8이고, 몫도 8비트 \(11111001\)이다. 몫은 CRC 값에 쓰지 않는다. 필요한 것은 나머지뿐이다. 다만 몫의 1은 “\(C\)를 XOR한 단계”의 기록이라, 손으로 풀 때 단계를 빠뜨렸는지 셀 때 쓸모가 있다.
나머지를 붙이면 나누어떨어지는 까닭
보내는 프레임은 \(10011010\,101\)이다. 붙여 둔 0 세 개 자리에 나머지 \(101\)을 XOR해 넣은 것이다. 자리를 맞춰 쓰면 \(10011010000 \oplus 00000000101 = 10011010101\)이다. 앞 8자리는 0과 XOR하니 그대로이고, 뒤 3자리만 \(000 \oplus 101 = 101\)로 바뀐다. 그래서 “나머지를 XOR한다”는 “나머지를 뒤에 이어 붙인다”와 같다.
이것을 “\(10011010000 - 101 = 10011010101\)“로 적기도 한다. 여기서 −는 XOR이다. 보통의 2진 뺄셈이었다면 \(10011001011\)이 된다2.
10진 비유에서는 나머지 10을 지우려고 \(11 - 10 = 1\)을 더했다. XOR 나눗셈에서는 빼기와 더하기가 같아서, 나머지를 그대로 다시 넣으면 나머지가 지워진다. \(101 \oplus 101 = 000\)이기 때문이다.
정말 나누어떨어지는지 \(10011010101\)을 다시 1101로 나눠 본다. 각 단계에서 XOR할지 말지는 창의 맨 앞 비트로 정해진다. 1~8단계 창의 맨 앞 비트는 모두 앞 8자리 안에 있고, 앞 8자리는 처음과 같다. 그래서 1~8단계의 결정(몫 \(11111001\))도 처음과 똑같다.
달라지는 것은 뒤 3자리뿐이다. 처음 나눗셈에서 뒤 3자리 \(000\)은 여러 번 XOR을 받아 \(101\)이 되었다. 이번에는 같은 XOR들을 \(101\)에서 시작해 받는다. 그래서 끝에 \(101 \oplus 101 = 000\)이 남는다. 실제로 마지막 창이 \(1101\)이 되어 \(1101 \oplus 1101 = 0000\), 나머지가 \(000\)이다1.
받는 쪽 점검
받는 쪽은 받은 11비트 전체를 같은 \(C\)로 나눈다. 이때는 0을 붙이지 않는다. 받은 프레임 끝에 이미 \(F\)가 붙어 있기 때문이다. 오류가 없으면 바로 위에서 본 대로 나머지가 \(000\)이다.
다섯째 비트 하나가 뒤집혀 \(10010010101\)을 받았다고 하자. 같은 방법으로 1101로 나누면 나머지가 \(110\)이다. 0이 아니니 오류다.
이 \(110\)은 어디서 왔을까? 뒤집힌 자리만 1로, 나머지 자리를 0으로 적은 오류 모양 \(00001000000\)을 따로 1101로 나눠도 나머지가 \(110\)이다. 받은 프레임의 나머지가 오류 모양만의 나머지와 같다. 보낸 프레임이 나누어떨어지기 때문이다(아래 ‘스스로 설명해 보기’ 2번). 1비트 오류는 11자리 중 어디에 생겨도 나머지가 \(000\)이 아니다.
이어 붙은 몇 비트가 한꺼번에 망가지는 오류를 버스트 오류라고 부른다. 망가진 덩어리의 길이가 \(k\) 이하이면 CRC는 늘 잡는다. 그런 덩어리는 다항식으로 \(x^i B(x)\) 꼴이다. \(B(x)\)는 차수가 \(k\)보다 작고 상수항이 1인 다항식이고, \(x^i\)는 덩어리가 놓인 자리를 나타낸다.
\(C(x)\)는 상수항이 1이라 \(x\)로 나누어떨어지지 않는다. 그래서 \(C(x)\)가 \(x^i B(x)\)를 나누려면 \(B(x)\)를 나눠야 한다. 하지만 0이 아닌 다항식은 자기보다 차수가 큰 다항식으로 나누어떨어질 수 없다. 나머지가 0이 될 수 없으니 반드시 잡는다[증명 스케치]. 검증 코드도 무작위 3,000개 프레임에서 3비트 이하 버스트 오류를 모두 잡았다.
놓치는 것은 오류 모양이 \(C(x)\)의 배수일 때다. 예를 들어 오류 모양 \(00000001101\)은 \(C\) 자체를 오른쪽 끝에 놓은 모양이다. 이 오류가 생기면 나머지가 \(000\)이 되어 받는 쪽은 알아채지 못한다. 10진 비유의 2211과 같은 경우다1.
스스로 설명해 보기
- “0을 \(k\)개 붙여 나눈 나머지를 더하면 나누어떨어진다”
근거
\(x^kM(x) = Q(x)C(x) + R(x)\)이다. 양변에 \(R(x)\)를 더하면 XOR 덧셈에서 \(R + R = 0\)이라 \(x^kM(x) + R(x) = Q(x)C(x)\)다. 보내는 \(P(x)\)가 바로 \(x^kM(x) + R(x)\)다.
- “받는 쪽 나머지는 오류 모양에만 달려 있다”
근거
받은 프레임은 \(P(x) + E(x)\)이고 \(P\)는 \(C\)로 나누어떨어지므로 나머지는 \(E(x) \bmod C(x)\)다. \(E\)가 \(C\)의 배수일 때만 놓친다. 검증 코드에서 \(E = 1101000\)(\(C\)를 세 칸 옮긴 것)을 놓쳤다.
- “1비트 오류는 늘 잡는다”
근거
1비트 오류는 \(E(x) = x^i\)다. \(C(x)\)에 항이 둘 이상이면 어떤 \(x^i\)도 \(C(x)\)의 배수가 될 수 없어 나머지가 0이 아니다.
- 이 방법의 핵심 아이디어는?
답
정해 둔 젯수로 나누어떨어지도록 꼬리를 붙이면, 받는 쪽은 나머지 하나로 검사한다. 그 나머지는 오류 모양에만 달려 있어서 젯수를 잘 고르면 흔한 오류 모양을 모두 잡는다.
- 같은 논리를 쓰는 다른 상황은?
답
ISBN 같은 번호의 검증 숫자(나머지로 확인하는 10진판), 파일 압축(ZIP·PNG의 CRC-32), 저장 장치의 오류 검출.
성능과 표준 젯수
검출율은 젯수 \(C\)의 선택이 좌우한다. 수학적 분석으로 잘 고르면 32비트 코드로 1500바이트가 넘는 데이터에서도 99.99…%를 잡는다. 99.99%는 놓치는 비율이 만 분의 1이라는 뜻이고, 뒤의 “…”는 그보다 더 낫다는 말이다. 1500바이트는 12,000비트다. 여기에 32비트를 붙이면 프레임 길이는 0.3%도 늘지 않는다.
계산이 전송보다 느리면 CRC 계산이 끝나는 시각이 전송 시간을 정한다. 그래서 가능하면 네트워크 어댑터 안의 하드웨어로 계산한다. 송수신 양쪽이 같은 \(C\)를 써야 하므로 표준화된 젯수를 쓴다.
| CRC | \(C(x)\) |
|---|---|
| CRC-8 | \(x^8 + x^2 + x + 1\) |
| CRC-10 | \(x^{10} + x^9 + x^5 + x^4 + x + 1\) |
| CRC-12 | \(x^{12} + x^{11} + x^3 + x^2 + 1\) |
| CRC-16 | \(x^{16} + x^{15} + x^2 + 1\) |
| CRC-CCITT | \(x^{16} + x^{12} + x^5 + 1\) |
| CRC-32 | \(x^{32} + x^{26} + x^{23} + x^{22} + x^{16} + x^{12} + x^{11} + x^{10} + x^8 + x^7 + x^5 + x^4 + x^2 + x + 1\) |
표의 식은 앞의 규칙을 거꾸로 써서 비트열로 바꾼다. CRC-16의 \(x^{16} + x^{15} + x^2 + 1\)은 \(x^{16}\)부터 \(x^0\)까지 17자리 가운데 16, 15, 2, 0번 자리만 1인 \(11000000000000101\)이다. 젯수가 17비트이니 \(k = 16\)이고, 붙이는 0과 CRC 값은 16비트다. CRC-8, CRC-16, CRC-32처럼 이름의 숫자가 곧 최고 차수이자 붙는 비트 수다1.
하드웨어 구현
래치(latch)는 비트 하나를 기억하는 칸이다. 래치를 한 줄로 늘어놓고, 박자(클럭)가 한 번 칠 때마다 모든 칸의 값을 오른쪽 옆 칸으로 한 칸씩 옮기는 장치를 시프트 레지스터라고 부른다. XOR 게이트는 두 입력의 XOR을 내보내는 회로 부품이다.
CRC 회로는 1비트 래치와 XOR 게이트를 \(C\)에 따라 잇는다. 칸 수는 (\(C\)의 비트 수 − 1) = \(k\)개다. 나머지가 \(k\)비트라 칸도 \(k\)개면 된다. XOR은 \(C\)의 계수가 1인 자리의 칸 앞에 둔다. 모든 비트가 지나간 뒤 래치에 남은 값이 CRC다.
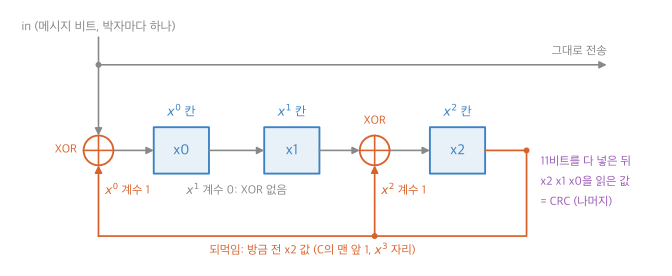
그림 2를 왼쪽 위부터 읽는다. 메시지 비트는 in으로 박자마다 하나씩 들어온다. 들어온 비트는 위쪽 선을 타고 그대로 전송 쪽으로도 간다. 보내는 일과 계산하는 일이 동시에 일어난다. 계산 쪽으로 간 비트는 먼저 왼쪽 XOR을 지나 x0 칸에 들어간다. 다음 박자에 x0의 값은 x1로 옮겨 가고, x1의 값은 가운데 XOR을 지나 x2로 옮겨 간다.
x2에서 나온 값은 오른쪽 끝에서 아래 주황 선을 타고 왼쪽으로 돌아간다. 이 선을 되먹임이라고 부른다. 되먹임은 두 갈래로 나뉘어 x0 앞 XOR과 x2 앞 XOR에 들어간다.
두 XOR의 자리는 \(C(x) = x^3 + x^2 + 1\)에서 계수가 1인 \(x^0\), \(x^2\) 자리다. 계수가 0인 \(x^1\) 앞에는 XOR이 없어서, x0의 값은 바뀌지 않고 그대로 x1로 간다. 남은 \(x^3\)의 계수 1은 되먹임 선 자체가 맡는다3.
한 박자에 일어나는 일을 적으면 다음과 같다. 화살표 왼쪽이 새 값이고, 오른쪽 값은 모두 박자 직전 값이다.
- 되먹임 \(f\) = 직전
x2 x0←in\(\oplus\, f\)x1← 직전x0x2← 직전x1\(\oplus\, f\)
작은 예로 직전 상태가 x0, x1, x2 = 0, 0, 1이고 in으로 1이 들어온다고 하자. \(f\)는 직전 x2인 1이다. x0 ← \(1 \oplus 1 = 0\), x1 ← 0, x2 ← \(0 \oplus 1 = 1\)이 되어 다시 0, 0, 1이다.
이 규칙이 왜 나눗셈과 같을까? 레지스터 세 칸에는 지금까지 들어온 비트들을 \(C\)로 나눈 나머지가 들어 있다. x2가 \(x^2\) 자리, x1이 \(x^1\) 자리, x0이 \(x^0\) 자리다. 그래서 나머지는 x2, x1, x0 순서로 읽는다.
새 비트가 들어오면, 긴 나눗셈에서는 나머지 3비트 옆에 다음 비트를 내려 4비트 창을 만든다. 레지스터에서는 모든 값이 한 칸씩 옮겨 가고 새 비트가 x0에 들어간다. 이때 x2에서 밀려 나오는 비트가 바로 창의 맨 앞 비트다.
맨 앞 비트가 1이면 나눗셈에서는 창에 \(1101\)을 XOR한다. 맨 앞 1은 \(C\)의 맨 앞 1과 만나 사라진다. 이것이 \(x^3\) 자리의 일이다. 그래서 회로에는 \(x^3\) 칸이 따로 없고, 밀려난 비트는 되먹임 선으로만 쓰인다. 남은 세 자리에는 \(C\)의 뒤 세 비트 \(101\)을 XOR한다. 곧 \(x^2\) 자리에 1, \(x^1\) 자리에 0, \(x^0\) 자리에 1이다. 회로에서 되먹임 1이 x2 앞과 x0 앞 XOR로 들어가는 것이 바로 이 일이다. 맨 앞 비트가 0이면 되먹임도 0이라 아무것도 바뀌지 않는다. 나눗셈의 건너뛰기와 같다.
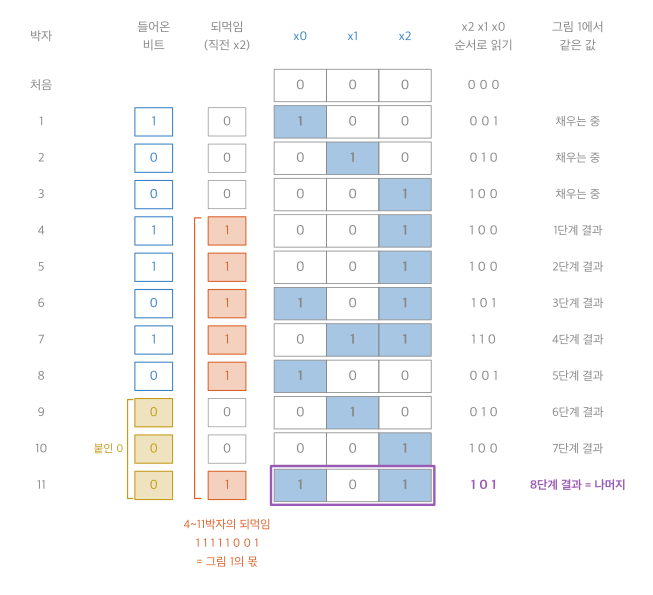
그림 3은 \(10011010\,000\)의 11비트를 박자마다 하나씩 넣을 때 세 칸의 값을 줄마다 적은 것이다. 파랗게 칠한 칸이 1이고, 노란 칸은 메시지 뒤에 붙인 0이다.
1~3박자에는 되먹임이 0이라, 들어온 비트 1, 0, 0이 오른쪽으로 밀려 갈 뿐이다. 3박자 뒤 세 칸을 x2부터 읽으면 메시지의 앞 세 비트 \(100\)이다. 창이 아직 4비트가 안 차서 나눗셈을 시작하지 않은 상태다.
4박자에서 처음으로 되먹임이 1이 된다. 직전 x2의 1이 밀려 나오면서, 그림 1의 1단계처럼 창 \(1001\)에 \(C\)를 XOR하는 셈이다. 결과를 x2부터 읽으면 \(100\)이다. 그림 1의 1단계 결과 \(0100\)에서 맨 앞 0을 버린 것과 같다.
그 뒤로도 맨 오른쪽 열에 적은 대로, \(t\)박자 뒤의 레지스터 값은 그림 1의 \((t - 3)\)단계 결과와 같다. 9·10박자에는 되먹임이 0이라 값이 한 칸씩 밀리기만 한다. 그림 1에서 6·7단계를 건너뛴 것과 같다.
되먹임 열을 4박자부터 11박자까지 세로로 읽으면 \(11111001\)이다. 그림 1의 몫과 똑같다. 되먹임이 1인 박자가 곧 \(C\)를 XOR한 단계이기 때문이다. 11박자를 마치면 세 칸에 1, 0, 1이 남는다. 이것을 x2부터 읽은 \(101\)이 CRC이고, 긴 나눗셈의 나머지와 같다4.
읽는 순서는 꼭 x2부터다. 이 예의 나머지 \(101\)은 거꾸로 읽어도 같아서 티가 나지 않는다. 7박자 줄을 보면 칸 순서로는 0, 1, 1이지만 x2부터 읽으면 \(110\)이다. 그림 1의 4단계 결과 \(0110\)과 맞는 것은 x2부터 읽은 쪽이다.
메시지 8비트만 넣고 멈추면 안 될까? 8박자에서 멈추면 레지스터에는 \(001\)이 남는다. 이것은 \(M\) 자체를 \(C\)로 나눈 나머지라 CRC가 아니다. 이 회로는 새 비트를 x0에 넣으므로, 0 세 개를 마저 넣어야 \(M(x)\,x^3\)을 나눈 나머지가 된다. 그림 1에서 붙인 0 세 개까지 내려야 나눗셈이 끝나는 것과 같다.
CRC가 늘 프레임 끝에 오는 까닭도 이 회로에서 나온다. CRC 값은 마지막 비트가 지나간 뒤에야 레지스터에 남는다. 보내는 쪽은 메시지 비트를 회로에 넣으면서 곧바로 내보내고, 다 내보낸 뒤 레지스터의 세 비트를 뒤에 이어 보낸다. CRC를 앞에 두려면 메시지 전체를 계산이 끝날 때까지 붙잡고 있어야 해서 보내기가 늦어진다. 받는 쪽도 들어오는 비트를 같은 회로에 넣다가, 마지막에 남은 값이 \(000\)인지만 보면 된다. 그래서 계산 비용이 거의 없다25.
예제
\(M = 1101\), \(C = 1011\).
- 목표 1, 0 붙이기: \(k = 3\)이라 \(1101\,000\).
- 목표 2, XOR 나눗셈: \(1101 \oplus 1011 = 0110\) → 내려 \(1100 \oplus 1011 = 0111\) → 내려 \(1110 \oplus 1011 = 0101\) → 내려 \(1010 \oplus 1011 = 0001\).
- 목표 3, 나머지 붙이기: \(F = 001\), 보내는 프레임 \(1101\,001\).
활용
- 이더넷과 무선랜 어댑터가 CRC-32를 쓴다. 검출율이 매우 높고 하드웨어로 만들 수 있어 거의 모든 링크 전송에서 쓴다.
- 복잡도: 메시지 \(n\)비트에 대해 하드웨어는 비트마다 한 박자, \(O(n)\). 소프트웨어는 표를 써서 바이트마다 처리한다.
- “CRC에 대해 간단히 설명하라”는 질문의 답 틀은 “부가되는 오류 검출 코드 → 송신자가 계산해 붙이고 수신자가 확인 → 프레임 전체가 젯수로 나누어떨어지게 만들고 나머지가 0이 아니면 오류 → 검출율이 매우 높고 하드웨어 구현이 가능해 거의 모든 링크에서 사용(CRC-32)”이다.
- 흔한 실수: 나눗셈에서 자리올림·빌림을 하는 것. CRC의 빼기는 XOR이다. 또 0을 \(k\)개가 아니라 \(k + 1\)개 붙이는 것. 시프트 레지스터에 남은 나머지를
x0부터 거꾸로 읽는 것도 흔한 실수다.
연결
- 선수: 오류 검출 코드, 나눗셈과 합동(나머지), 다항식과 방정식(다항식 나눗셈)
- XOR 연산: 불 대수와 논리 회로
- 다른 코드와 비교: 오류 검출 방식 비교
- 연습: CRC 예제 사다리
자주 하는 오해
틀렸다. 이름에 “나누기”가 있고 10진 나눗셈 비유로 설명하기도 해서 그럴듯하다. 실제로는 계수가 0과 1인 다항식의 나눗셈이라 더하기와 빼기가 모두 XOR이고 자리올림이 없다. 보내는 쪽 계산의 마지막 줄 “\(10011010000 - 101\)“도 보통의 뺄셈이면 \(10011001011\)이지만 XOR이라 \(10011010101\)이다. 손으로 계산할 때 빌림을 하면 답이 틀린다.
확인 문제
C1 CRC에서 보내는 쪽과 받는 쪽이 하는 일을 쓰라.
답: 보내는 쪽은 메시지 뒤에 0을 \(k\)개 붙여 젯수 \(C\)(\(k + 1\)비트)로 XOR 나눗셈을 하고, 나머지 \(k\)비트를 붙여 보낸다. 받는 쪽은 받은 프레임 전체를 \(C\)로 나눠 나머지가 0이 아니면 오류로, 0이면 오류가 없는 것으로 본다.
C2 \(M = 1101\), \(C = 1011\)로 보낼 프레임을 구하라.
답: \(1101000\)을 \(1011\)로 XOR 나눗셈하면 나머지 \(001\). 보내는 프레임은 \(1101001\).
C3 받는 쪽 나머지가 오류 모양 \(E(x)\)에만 달려 있는 이유는?
답: 받은 프레임은 \(P(x) + E(x)\)이고 \(P(x)\)는 \(C(x)\)로 나누어떨어진다. 그래서 나머지는 \(E(x) \bmod C(x)\)다. 데이터가 무엇이든 같은 오류 모양이면 같은 나머지가 나온다.
C4 비트열 \(10011010\)과 \(1101\)을 다항식으로 쓰라.
답: \(x^7 + x^4 + x^3 + x\)와 \(x^3 + x^2 + 1\). 왼쪽 끝 비트가 가장 높은 차수이고, 1인 자리의 거듭제곱만 더한다.
C5 CRC 하드웨어(시프트 레지스터와 XOR)가 하는 일을 한 문장으로 쓰라.
답: 메시지 비트를 한 박자에 하나씩 밀어 넣으며, 맨 앞 비트가 1일 때마다 젯수를 XOR하는 나눗셈을 레지스터 안에서 그대로 해, 마지막에 레지스터에 나머지(CRC)를 남긴다.
-
수치는 50_crc_plot.py의 assert로 확인했다. 버스트 논증은 증명 스케치이고, 50_crc_impl.py의 무작위 실험으로도 확인했다. ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
코드에서 박자마다
x0칸에는 들어온 비트와 되먹임의 XOR이,x1칸에는x0칸의 값이,x2칸에는x1칸과 되먹임의 XOR이 들어간다. ↩ -
50_crc_plot.py로 그렸고, 박자별 레지스터 값(x2부터 001, 010, 100, 100, 100, 101, 110, 001, 010, 100, 101), \(t\)박자 값 = 그림 1의 \((t - 3)\)단계 결과, 4~11박자 되먹임 = 몫 11111001, 8박자 값 001 = \(M\)의 나머지를 같은 코드로 확인했다. ↩
-
박자 규칙은 50_crc_impl.py의
shift_register를 옮겼고, 값은 50_crc_plot.py로 확인했다. ↩