패리티, 체크섬, CRC는 모두 데이터로 계산한 값을 덧붙여 오류를 찾는다. 셋을 가르는 것은 계산에 무엇을 쓰느냐(1의 개수 세기, 더하기, XOR 나누기)와, 그에 따라 어떤 오류를 놓치느냐다. 계산이 단순할수록 놓치는 오류가 많고, CRC는 계산이 복잡하지만 하드웨어로 하면 오히려 비용이 거의 없다.
어느 쪽일까
1. 이더넷 어댑터가 매 프레임을 전송하며 동시에 오류를 검사해야 한다.
CRC. 시프트 레지스터와 XOR로 전송과 동시에 계산되고 검출율이 가장 높다. 체크섬은 소프트웨어에 알맞고, 패리티는 놓치는 오류가 너무 많다.
2. 라우터마다 소프트웨어로 IP 헤더를 빨리 다시 검사하고, 바뀐 칸(TTL)만큼만 고쳐 다시 계산하고 싶다.
인터넷 체크섬. 덧셈뿐이라 CPU에서 빠르고, 한 칸이 바뀌면 그 차이만 더하고 빼서 고칠 수 있다. CRC는 소프트웨어로 다시 계산하기 더 무겁다.
3. 재전송이 어려워 받는 쪽이 1비트 오류를 스스로 고쳐야 한다.
2차원 패리티. 1비트 오류의 위치를 알아 고칠 수 있다. 체크섬과 CRC는 오류가 있다는 것만 알려 준다.
결정적 차이
무작위 데이터 32바이트에 2비트 또는 4비트 오류를 4,000번씩(모두 8,000번) 넣어 보았다1.
| 패리티(1비트) | 2차원 패리티 | 인터넷 체크섬 | CRC-16 | |
|---|---|---|---|---|
| 계산 | 1의 개수 세기 | 줄·칸마다 세기 | 16비트 1의 보수 덧셈 | XOR 다항식 나눗셈 |
| 덧붙는 크기 | 1비트 | 줄 수 + 칸 수 + 1비트 | 16비트 | 16비트 |
| 놓친 오류(8,000번 중) | 8,000 (짝수 개는 늘 놓침) | 0 | 132 | 0 |
| 늘 잡는 오류 | 홀수 개 비트 | 1~3비트 | 1비트 | 1비트, 16비트 이내 버스트 |
| 놓치는 대표 오류 | 2비트 | 직사각형 4비트 | 워드 순서 바뀜, 같은 자리 상쇄 | \(C(x)\)의 배수인 오류 |
| 잘 맞는 곳 | 아주 짧은 데이터 | 오류를 고쳐야 할 때 | IP·TCP(소프트웨어) | 링크 계층(하드웨어) |
CRC는 검출율이 매우 높고 하드웨어로 만들 수 있다. 그래서 체크섬은 IP·TCP에서 소프트웨어로 계산하고, CRC는 네트워크 어댑터(NIC) 안의 XOR 회로로 계산한다.
표는 여섯 줄이다. 아래에서 한 줄씩 작은 예로 풀어 읽는다.
같은 4바이트로 계산해 보기
표의 첫 두 줄(계산, 덧붙는 크기)은 같은 데이터에 네 방식을 적용해 보면 바로 보인다. 데이터는 16진수로 F0 F0 12 34, 모두 4바이트(32비트)다2.
| 방식 | 하는 일 | 붙는 값 | 붙는 비트 수 |
|---|---|---|---|
| 패리티 | 32비트의 1을 센다 | 1 |
1 |
| 2차원 패리티 | 4줄 8칸 표로 놓고 줄마다, 칸마다 센다 | 가로 0, 0, 0, 1 / 세로 00100110 / 모서리 1 |
\(4 + 8 + 1 = 13\) |
| 인터넷 체크섬 | 워드 0xF0F0, 0x1234를 1의 보수로 더해 뒤집는다 |
0xFCDA |
16 |
| CRC-16 | 뒤에 0을 16개 붙여 젯수로 XOR 나눗셈한다 | 0x2053 |
16 |
패리티 줄부터 직접 따라간다. F0은 2진수로 1111 0000이라 1이 4개다. F0이 두 번이라 8개, 12(0001 0010)에 2개, 34(0011 0100)에 3개가 더 있다. 모두 \(4 + 4 + 2 + 3 = 13\)개로 홀수라 1을 붙인다.
2차원 패리티는 한 바이트를 한 줄로 놓는다. F0 두 줄은 1이 4개씩이라 0, 12 줄은 2개라 0, 34 줄은 3개라 1이다. 세로는 칸마다 네 줄의 같은 자리를 모은다. 맨 왼쪽 칸은 1, 1, 0, 0이라 0이고, 셋째 칸은 1, 1, 0, 1이라 1이다. 여덟 칸을 다 구하면 00100110이다. 모서리 비트는 가로 패리티 0, 0, 0, 1에 1이 하나라 1이다.
체크섬은 두 바이트씩 묶어 워드 0xF0F0, 0x1234를 만든다. 이 두 워드의 계산은 인터넷 체크섬 문서의 본문 예시와 같아서 0xFCDA가 나온다.
CRC-16은 손으로 하면 XOR을 수십 번 해야 한다. 이 문서의 검증 코드와 같은 방식(초깃값 0, 비트 순서를 뒤집지 않음)으로 계산하면 0x2053이다. 실제 표준 CRC-16들은 초깃값이나 비트 순서가 달라 같은 데이터에서도 값이 다를 수 있다2.
덧붙는 크기는 데이터 길이에 따라 다르게 자란다. 4바이트에서는 2차원 패리티가 13비트로 체크섬·CRC의 16비트보다 적다. 실험처럼 32바이트가 되면 줄이 32개라 \(32 + 8 + 1 = 41\)비트를 붙인다. 256비트 데이터의 16%다. 체크섬과 CRC는 데이터가 아무리 길어도 16비트로, 256비트의 6%다2.
실험을 읽는 법
표의 셋째 줄(놓친 오류)은 다음 실험의 결과다2.
- 무작위 32바이트(256비트)를 만든다.
- 256자리 가운데 무작위로 2자리를 골라 뒤집는다.
- 원래 데이터와 뒤집힌 데이터로 네 방식의 검사 값을 각각 계산한다. 두 값이 같으면 그 방식은 이 오류를 놓친 것이다.
- 1~3을 4,000번 되풀이한다. 같은 일을 4자리 뒤집기로 4,000번 더 한다.
그래서 네 방식은 똑같은 오류 8,000개를 받았다. 2비트 4,000개와 4비트 4,000개다.
패리티의 8,000은 한 번도 못 잡았다는 뜻이다. 2비트와 4비트는 모두 짝수 개라서 1의 개수의 짝홀이 바뀌지 않는다.
체크섬의 132는 \(132 / 8{,}000 = 0.0165\), 약 1.6%다. 60번에 한 번꼴로 놓친다는 뜻이다. 나눠 보면 2비트 오류에서 124번, 4비트 오류에서 8번이었다.
2비트 오류를 놓치는 비율은 계산으로도 나온다. 체크섬이 2비트 오류를 놓치려면 두 비트가 워드 안의 같은 자리에 있고, 하나는 0→1, 하나는 1→0이어야 한다. 첫 비트를 정하면 남은 255자리 가운데 같은 자리는 나머지 워드 15개에 하나씩, 15곳이다. 무작위 데이터에서 두 비트의 값이 서로 다를 확률은 1/2이다. 그래서 \(15/255 \times 1/2 \approx 2.9\%\)이고, 4,000번이면 약 118번이다. 실험의 124번과 가깝다.
4비트 오류에서 놓친 8번은 네 비트의 변화가 더해서 0이 된 경우다. 8번 중 7번은 같은 자리끼리 두 쌍이 각각 서로 지운 경우였다. 나머지 1번은 1의 자리 두 비트가 1→0(-1, -1), 2의 자리 한 비트가 1→0(-2), 4의 자리 한 비트가 0→1(+4)로 바뀌어 \(-1 - 1 - 2 + 4 = 0\)이 된 경우였다.
2차원 패리티와 CRC-16의 0은 “절대 놓치지 않는다”는 뜻이 아니다. 놓칠 모양이 8,000번 안에 한 번도 나오지 않았다는 뜻이다. 아래에서 \(\binom{n}{k}\)는 “\(n\)개 중 \(k\)개를 고르는 방법의 수”라고 읽는다.
- 2차원 패리티는 직사각형 4비트를 놓친다. 32줄 8칸 표에서 직사각형은 \(\binom{32}{2} \times \binom{8}{2} = 496 \times 28 = 13{,}888\)가지다. 256자리에서 4자리를 고르는 방법은 \(\binom{256}{4}\), 약 1억 7,479만 가지다. 무작위 4비트 오류가 직사각형일 확률은 약 1만 2,600분의 1이다.
- CRC-16이 놓치는 4비트 모양은 이 길이에서 14,995가지다. 무작위 4비트 오류가 걸릴 확률은 약 1만 1,700분의 1이다.
4비트 오류 4,000번에서 이런 모양이 나올 횟수는 두 방식 모두 평균 0.3번 남짓이다. 그래서 한 번도 나오지 않은 것이 자연스럽다. 무작위로 흩어진 4비트 오류만 보면 두 방식이 놓치는 비율은 비슷하다. CRC가 앞서는 곳은 짧은 덩어리 오류와 덧붙는 크기다2.
늘 잡는 오류와 놓치는 오류
표의 넷째·다섯째 줄을 방식마다 예로 읽는다.
- 패리티: 홀수 개가 뒤집히면 1의 개수의 짝홀이 바뀌어 늘 잡는다. 아무 비트 두 개가 함께 뒤집히면 짝홀이 돌아와 놓친다(오류 검출 코드).
- 2차원 패리티: 1~3비트는 어떤 줄이나 칸이 반드시 홀수 개를 품어 늘 잡는다. 직사각형 네 꼭짓점이 함께 뒤집히면 모든 줄과 칸이 짝수 개씩 품어 놓친다(2차원 패리티).
- 인터넷 체크섬: 비트 하나가 뒤집히면 합이 1, 2, 4, …, 32,768 중 하나만큼 변해 늘 잡는다. 워드 순서가 바뀌거나 같은 자리의 변화가 서로 지워지면 합이 그대로라 놓친다(인터넷 체크섬).
- CRC-16: 1비트 오류와, 이어 붙은 16비트 안에서 생긴 덩어리 오류(버스트 오류)를 늘 잡는다. 이 실험 길이(256비트)에서는 2비트 오류 3만 2,640가지와 3비트 오류 약 276만 가지도 모두 잡는다. 놓치는 것은 오류 모양이 젯수의 배수일 때다. 예를 들어 젯수
1 1000 0000 0000 0101과 똑같은 모양으로 네 비트가 뒤집히면 나머지가 0이 되어 놓친다(CRC)2.
같은 16비트를 붙이는데 체크섬은 놓치고 CRC는 잡는 오류가 있다. 체크섬 문서의 약점 예를 두 방식에 함께 넣어 보면 차이가 보인다.
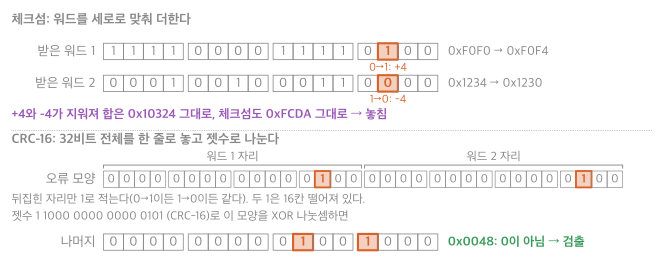
그림 위쪽은 체크섬이 보는 모습이다. 받은 워드 두 개를 세로로 맞춰 놓았고, 주황 칸이 뒤집힌 비트다. 두 주황 칸은 같은 세로줄(4의 자리)에 있다. 워드 1에서는 0→1이라 4가 늘고, 워드 2에서는 1→0이라 4가 준다. 체크섬은 세로줄끼리 더하므로 +4와 -4가 지워진다. 합과 체크섬이 그대로라 놓친다.
그림 아래쪽은 CRC-16이 보는 모습이다. 같은 32비트를 한 줄로 늘어놓고, 뒤집힌 자리만 1로 적은 오류 모양을 만든다. CRC는 XOR로 계산하므로 0→1인지 1→0인지는 상관없고, 뒤집혔는지만 남는다. 두 1은 16칸 떨어져 있다.
받는 쪽 나머지는 이 오류 모양을 젯수로 나눈 나머지와 같다. 원래 프레임은 젯수로 나누어떨어지게 만들어졌으므로, 나머지에는 오류 모양에서 생긴 부분만 남기 때문이다(CRC). 맨 아래 줄이 그 나머지 0x0048이고, 0이 아니라서 검출한다3.
체크섬에게 16칸 떨어진 두 자리는 같은 자리다. 워드를 세로로 맞추면 겹치기 때문이다. CRC에게는 32자리가 모두 다른 자리다. CRC는 오류 모양 전체를 하나의 긴 수로 보고 나누므로, 두 1이 서로 지워지려면 그 모양이 젯수의 배수여야 한다. 1이 두 개뿐인 모양은 이 길이에서 젯수의 배수가 되지 않는다2.
CRC가 앞서는 또 한 가지는 덩어리 오류다. 선에 잠깐 큰 잡음이 끼면 이웃한 비트 여러 개가 한꺼번에 망가진다. 2차원 패리티는 이웃한 두 줄의 같은 두 칸이 함께 뒤집히는 덩어리를 놓친다. 32바이트 표에서 넷째·다섯째 줄의 일곱째·여덟째 비트가 함께 뒤집히면, 10비트 길이 안에 생긴 오류인데도 네 비트가 직사각형을 이뤄 모든 검사를 통과한다. CRC-16은 이 오류를 잡는다. 덩어리 길이가 16 이하이기 때문이다2.
잘 맞는 곳
표의 마지막 줄은 위 ‘어느 쪽일까’의 세 상황과 같다. 하드웨어가 전송과 동시에 계산할 수 있는 링크 계층에는 CRC, 소프트웨어가 빨리 다시 계산해야 하는 IP·TCP에는 체크섬, 받는 쪽이 직접 고쳐야 할 때는 2차원 패리티가 맞다. 패리티 하나는 몇 비트짜리 짧은 데이터에서 홀수 개 오류만 걸러도 될 때 쓴다.
둘 다 아닐 때
- 오류를 고쳐야 하는데 1비트보다 많이: 해밍 부호, 리드-솔로몬 부호처럼 더 강한 오류 수정 코드를 쓴다(CD, QR 코드, 위성 통신)1. 오류 복구 일반은 오류 복구와 FEC.
- 누군가 일부러 바꾸는 것까지 막아야 할 때: CRC와 체크섬은 우연한 오류용이라 일부러 맞춰 바꿀 수 있다. 암호학적 해시(SHA-256)나 메시지 인증 코드를 쓴다1.
확인 문제
C1 체크섬과 CRC는 둘 다 16비트를 덧붙인다. 같은 크기인데 CRC가 오류를 더 잘 잡는 이유는?
답: 체크섬은 더하기라 순서가 바뀌거나 같은 자리의 변화가 서로 상쇄되면 합이 같다. CRC는 자리마다 다른 무게(다항식의 차수)로 나누어, 같은 자리의 오류도 위치에 따라 나머지가 달라진다. 실험에서 체크섬은 8,000번 중 132번, CRC-16은 0번 놓쳤다.
C2 패리티 비트 하나가 짝수 개 비트 오류를 하나도 잡지 못하는 이유는?
답: 패리티는 1의 개수가 짝수인지만 본다. 비트 두 개가 바뀌면 1의 개수가 2만큼 늘거나, 줄거나, 그대로라 짝홀이 변하지 않는다.
C3 왜 2계층은 CRC, 3·4계층은 체크섬을 주로 쓰나?
답: 2계층은 어댑터 하드웨어가 전송과 동시에 계산할 수 있어 강한 CRC를 거의 공짜로 쓴다. 3·4계층은 호스트와 라우터의 소프트웨어가 계산하므로 덧셈만 하는 체크섬이 빠르다. 2계층이 이미 강하게 검사했으니 위 계층은 가벼운 검사로 중복 확인만 한다.