식당이 예약석을 따로 비워 두지 않고 온 손님 순서대로 빈자리에 앉히듯, 칸을 미리 나눠 주지 않고 보낼 데이터가 있는 사용자에게만 그때그때 링크를 내주는 방법이다. 쉬는 사람 몫이 비지 않으니 같은 링크로 훨씬 많은 사용자를 받는다. 대신 조각마다 누구 것인지 적은 이름표를 붙여야 하고, 여럿이 한꺼번에 몰리면 기다리거나 버려진다. 사용자들이 서로 다른 때에 가끔씩만 보낼 때만 이득이 난다.
예시로 보기
사용자 A~D 가운데 첫 주기에는 A와 B만, 둘째 주기에는 B와 C만 데이터가 있다고 하자. 같은 사례를 두 방식으로 실어 본다. ··는 빈 칸, a는 주소 칸이다.
동기식 시분할 : | A1 | B1 | ·· | ·· | ·· | B2 | C2 | ·· |   ← 8칸 중 4칸이 빈 칸 (Wasted Bandwidth)
통계적        : |a|A1|a|B1|a|B2|a|C2|   남는 대역 →        ← 빈 칸 없음, 대신 주소 칸
동기식 시분할에서 칸 위치가 하던 일을 통계적 다중화에서는 주소 칸 a가 한다. 조각 사이의 a는 빈 간격이 아니라 주인을 알려 주는 칸이고, 이것이 주소 오버헤드다. 빈 칸이 사라진 자리는 다른 데이터에 쓸 수 있는 여유 대역이 된다(Extra Bandwidth Available). 아래 정의에서는 주소 칸 하나의 크기를 \(b_{\text{addr}}\)비트, 데이터 조각 하나의 크기를 \(b_{\text{data}}\)비트라 쓴다.
정의
통계적 다중화는 시분할 방법의 한 종류로, 고정 분할이 아니라 요구에 따라 동적으로 링크 시간을 나눈다. 비동기식 시분할 다중화라고도 한다.
그 순간 모든 입력이 보내려는 양을 더해서 링크 속도 \(R\) 이하이면 모두 바로 나간다. 넘치면 넘친 만큼 줄 서서 기다리고, 줄 설 자리(버퍼)까지 차면 버린다. 조각마다 주소를 붙이므로 링크의 일부는 주소가 차지한다. 예를 들어 데이터 1,000비트에 주소 40비트를 붙이면 데이터 비율은 \(1000/1040 \approx 96\%\)다1.
기호로 쓰면. 링크 전송률 \(R\)(bps), 입력 \(N\)개. 시각 \(t\)에 입력 \(i\)가 보내려는 전송률을 \(r_i(t) \ge 0\)라 하자.
- \(\sum_i r_i(t) \le R\)(모든 입력의 요구를 더한 값이 \(R\) 이하)이면 모든 입력의 데이터가 바로 실린다.
- \(\sum_i r_i(t) > R\)이면 넘친 부분은 버퍼에서 기다린다. 버퍼가 가득 차면 버려진다2.
- 데이터 \(b_{\text{data}}\)비트짜리 조각마다 주소 \(b_{\text{addr}}\)비트를 붙인다. 링크에서 데이터가 차지하는 비율은 \(\dfrac{b_{\text{data}}}{b_{\text{data}} + b_{\text{addr}}}\)다.
| 보장한다 | 보장하지 않는다2 |
|---|---|
| 쉬는 입력의 몫을 다른 입력이 쓴다. 링크가 비어 있는 동안 기다리는 데이터는 없다 | 입력별 전송률, 지연의 상한, 손실 없음. 여러 입력이 동시에 몰리면 모두 깨진다 |
말로 하면, 각자 확률 \(p\)로 따로따로 켜지는 사용자 \(n\)명 가운데 링크가 감당할 수 있는 수보다 많은 사람이 동시에 켜질 확률을 구한다.
사용자 \(n\)명이 활동할 때 전송률 \(a\)를 쓰고, 각자 어느 순간이든 확률 \(p\)로 활동하며, 사용자끼리 서로 독립이라 하자. 링크가 한꺼번에 감당할 수 있는 사용자 수를 \(n_{\max} = \lfloor R/a \rfloor\)(\(\lfloor\ \rfloor\)는 소수점 아래를 버린 정수)라 하면, 링크가 넘칠 확률은
\[\Pr[X > n_{\max}] = \sum_{k = n_{\max}+1}^{n} \binom{n}{k} p^k (1-p)^{n-k}\]이다. 여기서 \(X\)는 동시에 활동하는 사용자 수이고 \(X \sim \mathrm{Binomial}(n, p)\)(\(X \sim\) 분포는 “\(X\)가 그 분포를 따른다”)다3.
- 증명 펼치기
- 사용자 \(j\)가 활동하면 1, 아니면 0인 값을 \(Y_j\)라 하자. \(\Pr[Y_j = 1] = p\)다. — 가정
- \(X = \sum_{j=1}^{n} Y_j\)다. \(Y_j\)들이 서로 독립이고 모두 같은 \(p\)를 가지므로 \(X \sim \mathrm{Binomial}(n, p)\)다. — 이항분포의 정의
- 전체 요구량은 \(X \cdot a\)다. 링크가 넘치는 것은 \(X \cdot a > R\), 즉 \(X > R/a\)일 때다. — 정의의 둘째 줄
- \(X\)는 정수이므로 \(X > R/a \iff X \ge \lfloor R/a \rfloor + 1 = n_{\max} + 1\)이다. — 바닥 함수의 성질
- 이항분포의 확률 질량 함수를 \(k = n_{\max}+1, \dots, n\)에서 더하면 위 식이다. ∎
스스로 설명해 보기
- ”\(X \sim \mathrm{Binomial}(n, p)\)”
근거
사용자마다 활동 여부가 확률 \(p\)인 0/1 값이고, 서로 독립이다. 독립인 같은 베르누이 변수의 합이 이항분포다.
- ”\(X > R/a \iff X \ge n_{\max} + 1\)”
근거
\(X\)가 정수라서, \(R/a\)보다 큰 가장 작은 정수는 \(\lfloor R/a \rfloor + 1\)이다.
- 이 모델의 핵심 아이디어는?
답
각자는 가끔만 보내므로, 서로 독립이면 한꺼번에 몰릴 확률이 매우 작다. 그래서 최대가 아니라 평균에 가깝게 용량을 잡아도 된다.
- 같은 논리를 쓰는 다른 상황은?
답
항공사의 초과 예약, 서버 한 대에 가상 머신을 물리 자원보다 많이 올리는 초과 할당. 모두 “동시에 다 쓰지는 않는다”에 기댄다.
예제
넘칠 확률 계산3: 링크 1 Mbps, 사용자는 활동할 때 100 kbps, 시간의 10%만 활동한다.
- 고정 할당의 한계: 회선 스위칭(또는 시분할 다중화)으로 100 kbps씩 떼어 주면 \(1{,}000{,}000 / 100{,}000 = 10\)명까지 받는다.
- 모델 세우기: 통계적 다중화로 35명을 받는다. \(X \sim \mathrm{Binomial}(35,\ 0.1)\)이고 평균은 3.5명이다.
- 넘칠 확률: \(n_{\max} = 10\)이므로 11명 이상이 동시에 활동할 때 넘친다. \(\Pr[X \ge 11] \approx 0.000424\).
- 해석: 99.95% 이상의 시간 동안 35명 모두 막힘없이 보낸다. 같은 링크로 고정 할당보다 3.5배 많은 사용자를 받는다.
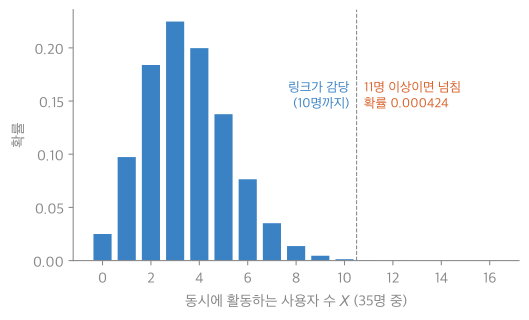
막대 하나가 “35명 중 동시에 \(X\)명이 활동할 확률”이다. 대부분 2~5명에 몰려 있고, 점선 오른쪽(11명 이상)의 막대는 너무 낮아 보이지도 않는다. 그 막대들을 모두 더한 값이 0.000424다4.
사용자 수를 늘리면 넘칠 확률이 빠르게 커진다. 30명 0.000089, 40명 0.00147, 50명 0.00935다.
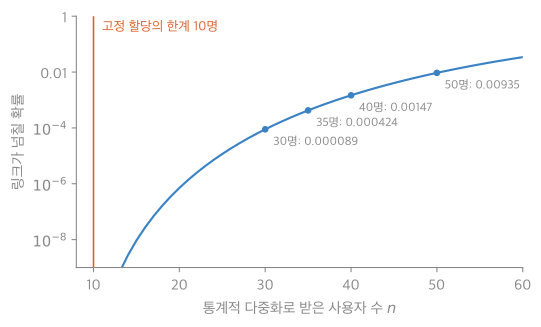
세로축은 한 칸이 100배다. 10명까지는 넘칠 일이 아예 없고, 그 위로는 사용자를 늘릴수록 넘칠 확률이 꾸준히 커진다. 몇 명까지 받을지는 견딜 수 있는 넘칠 확률을 먼저 정한 뒤 이 곡선에서 읽는다4.
독립 가정을 빼면. 35명이 모두 같은 순간에 함께 켜지고 꺼진다고 하자(모두 정각에 시작하는 온라인 시험). 그러면 11명 이상이 동시에 활동할 확률은 곧 “모두 활동할 확률”인 0.1이다. 독립일 때의 약 236배다. 몬테카를로로도 0.0998이 나온다. 통계적 이득은 사용자들이 서로 다른 때에 몰린다는 가정에서 나온다.
버스티하지 않으면. 모든 입력이 늘 보낼 것이 있으면(\(p = 1\)) 나눠 쓸 빈 시간이 없다. 통계적 다중화는 이득 없이 주소 오버헤드만 더한다5.
활용
- 통계적 다중화를 두고 흔히 묻는 두 질문의 답은 다음과 같다.
- “Demux key/select?” → 칸 위치가 고정되지 않으므로 주소(address)가 필요하다.
- “항상 좋은가?” → 아니다. 주소 오버헤드가 있고, 트래픽이 버스티하지 않거나 사용자들이 한꺼번에 몰리면 이득이 사라진다. 몰리면 지연과 손실도 생긴다2.
- 버스티한 컴퓨터 통신에서는 반드시 필요한 기법이다.
- 인터넷의 패킷 스위칭이 곧 통계적 다중화다. 패킷 헤더의 목적지 주소가 주소 칸이다2.
연결
- 선수: 버스티 트래픽, 주소 지정, 시분할 다중화
- 대조: 시분할 다중화와 통계적 다중화 비교, 패킷 스위칭과 통계적 다중화 비교
- 같은 구조: 동기식 시분할 다중화와 통계적 다중화의 관계는 회선 스위칭과 패킷 스위칭의 관계와 같다(카드 C5).
- 확률통계의 이항분포 꼬리 확률과 독립 가정이 그대로 쓰인다.
자주 하는 오해
틀렸다. 위 그림처럼 통계적 다중화는 빈 칸이 없고 남는 대역까지 생겨서 늘 나아 보인다. 실제로 이득은 트래픽이 버스티하고 사용자들이 서로 다른 때에 몰릴 때만 생긴다. 모든 입력이 늘 꽉 차게 보내면 빈 칸이 원래 없으므로 이득은 0이고, 조각마다 붙는 주소만큼 손해다. \(p = 1\)이면 동기식 시분할의 빈 칸이 0개라는 것으로 확인할 수 있다.
확인 문제
C1 통계적 다중화를 동기식 시분할 다중화와 비교해 정의하고, 두 질문 “Demux key/select?”(무엇으로 주인을 가르나)와 “항상 좋은가?”에 답하라.
답: 시분할 방법의 일종인데, 칸을 고정 배정하지 않고 요구에 따라 동적으로 나눈다(비동기식). Demux key: 칸 위치로 주인을 알 수 없으니 주소가 필요하다. 항상 좋은가: 아니다. 주소 오버헤드가 있고, 트래픽이 버스티하지 않으면 이득이 없다.
C2 입력 A, B, C. 주기 1에는 A와 C, 주기 2에는 B만, 주기 3에는 A·B·C 모두 데이터 조각이 하나씩 있다. (a) 동기식 시분할(주기당 칸 3개)로 보내면 빈 칸은 모두 몇 개인가? (b) 통계적 다중화 링크가 주기당 조각 2개까지 보내고, 같은 주기에 온 조각은 A, B, C 순으로 버퍼에 줄 선다. 주기 3이 끝났을 때 버퍼에 남은 조각과, 그 조각이 나가는 주기는?
답: (a) 9칸 중 데이터 6개, 빈 칸 3개. (b) 주기 1: A1, C1 / 주기 2: B2 / 주기 3: A3, B3 → C3가 남는다. C3는 주기 4에 나간다.
흔한 오답: (b)에서 “남는 것 없음”. 주기 3에는 조각이 3개인데 링크는 2개만 보낸다. 몰리면 기다린다.
C3 링크 2 Mbps, 사용자는 활동할 때 200 kbps, 시간의 5%만 활동하며 서로 독립이다. 회선 스위칭으로는 몇 명을 받는가? 사용자 60명을 통계적 다중화로 받을 때, 평균 동시 활동자 수와 링크가 넘칠 확률의 식을 쓰라. (계산기가 있으면 값도)
답: 회선 스위칭 \(2{,}000{,}000 / 200{,}000 = 10\)명. 평균 \(60 \times 0.05 = 3\)명. 넘칠 확률 \(\Pr[X \ge 11] = \sum_{k=11}^{60} \binom{60}{k} (0.05)^k (0.95)^{60-k} \approx 0.000172\).
흔한 오답: \(\Pr[X \ge 10]\)으로 쓰는 것. 10명까지는 링크가 감당한다. 넘치는 것은 11명부터다.
C4 통계적 다중화의 이득이 사라지는 상황 두 가지를 들고, 각각 어떤 가정이 깨진 것인지 쓰라.
답: ① 사용자들이 한꺼번에 켜지고 꺼진다(예: 정각에 모두 시작). 사용자끼리 독립이라는 가정이 깨진다. ② 모든 사용자가 늘 보낼 것이 있다. 트래픽이 버스티하다는 가정(\(p\)가 작음)이 깨진다. 이때는 주소 오버헤드만 남는다.
C5 동기식 시분할 다중화와 통계적 다중화의 관계를, 회선 스위칭과 패킷 스위칭의 관계와 나란히 놓아라. 두 쌍의 공통 구조는 무엇이고, 무엇이 무엇에 대응하는가?
답: 공통 구조는 “자원을 미리 떼어 줄까, 필요할 때 줄까”다.
| 미리 떼어 줌 | 필요할 때 줌 | 대응하는 것 |
|---|---|---|
| 회선 스위칭 | 패킷 스위칭 | 경로 위 링크 용량 |
| 동기식 시분할 다중화 | 통계적 다중화 | 링크 하나의 시간 칸 |
| 칸 위치·회선이 곧 주인 | 조각마다 주소 | 누구 것인지 아는 방법 |
| 쉬는 몫 낭비 | 몰리면 대기·손실 | 치르는 대가 |
실제로 회선 스위칭은 링크마다 시간 칸 하나를 잡는 식으로 구현하고, 패킷 스위칭은 출력 링크를 통계적 다중화로 나눠 쓴다.
-
데이터 1,000비트·주소 40비트는 비율 식을 보이려고 고른 예시 값이다. \(1000/1040 = 0.9615\). ↩
-
Peterson & Davie, Computer Networks: A Systems Approach, 1.2절의 통계적 다중화 설명과 같다. ↩ ↩2 ↩3 ↩4
-
예제 수치는 Kurose & Ross, Computer Networking: A Top-Down Approach, 1.3절의 패킷 스위칭과 회선 스위칭 비교 예제와 같다. 증명과 반례, 사용자 수별 값은 이 모델에서 나온다. ↩ ↩2
-
15_statistical-multiplexing_plot.py로 그렸고, 35명에서 넘칠 확률 0.000424, 30·40·50명에서 0.000089, 0.00147, 0.00935를 같은 코드로 확인했다. ↩ ↩2
-
이 단락과 ‘활용’의 두 질문이 그 답이다. ↩