가로축에 노드를, 세로축에 시간을 놓고 데이터가 언제 어디에 있는지 그려서 총 걸리는 시간을 구하는 방법이다. 기차 시간표를 그리듯 구간마다 싣는 시간, 달리는 시간, 역에서 머무는 시간을 쌓으면 답이 나온다. 회선 스위칭은 처음 설정에 시간을 쓰고 그 뒤로는 멈춤 없이 흐른다. 패킷 스위칭은 노드마다 다 받고 넘기느라 조금씩 늦지만, 여러 패킷이 겹쳐 흘러 그 손해를 메운다. 아래 공식은 다른 트래픽과 줄 서는 시간이 없을 때만 맞다.
예시로 보기
Host 1 — Node 1 — Node 2 — Host 2를 잇는다(링크 3개). 링크마다 패킷 하나를 싣는 데 2 ms, 신호가 건너는 데 1 ms가 걸린다. 노드는 패킷마다 처리에 0.5 ms를 쓴다. 패킷 3개를 보낸다.
| 사건 | 패킷 1 | 패킷 2 | 패킷 3 |
|---|---|---|---|
| Host 1에서 싣기 | 0 → 2 | 2 → 4 | 4 → 6 |
| Node 1에 다 도착 (+ 전파 1) | 3 | 5 | 7 |
| Node 1 처리 (+ 0.5) | 3 → 3.5 | 5 → 5.5 | 7 → 7.5 |
| Node 1에서 싣기 (+ 2) | 3.5 → 5.5 | 5.5 → 7.5 | 7.5 → 9.5 |
| Node 2에 다 도착 → 처리 → 싣기 | 6.5 → 7 → 9 | 8.5 → 9 → 11 | 10.5 → 11 → 13 |
| Host 2에 다 도착 (+ 전파 1) | 10 | 12 | 14 |
패킷 1 하나만 보면 링크마다 “싣기 2 + 전파 1”이, 노드마다 처리 0.5가 쌓여 \(3 \times 3 + 2 \times 0.5 = 10\) ms다. 노드가 패킷을 끝까지 받은 뒤에야 내보내므로(저장 후 전달) 싣는 시간이 링크마다 다시 들어간다. 뒤 패킷들은 앞 패킷이 비운 링크에 곧바로 실려 2 ms 간격으로 따라온다. Host 1이 패킷 2를 싣는 동안 Node 1은 패킷 1을 내보낸다. 이 모습을 파이프라이닝(Pipelining)이라 부른다.
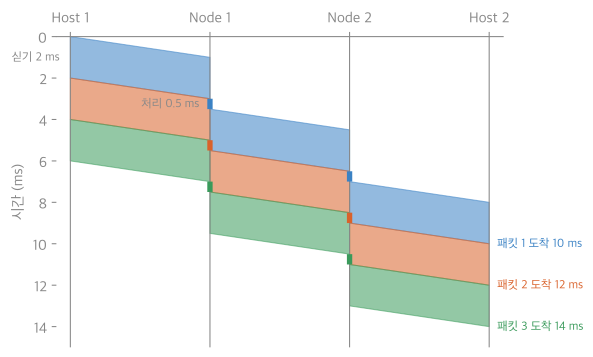
띠 하나가 패킷 하나가 링크 하나를 건너는 모습이다. 띠의 세로 두께가 싣는 시간 2 ms, 비스듬히 내려가는 만큼이 전파 1 ms, 노드 위의 짧고 굵은 막대가 처리 0.5 ms다. 4~5.5 ms 사이에는 Host 1이 패킷 3을, Node 1이 패킷 1을 동시에 싣는다. 이렇게 띠들이 시간상 겹치는 것이 파이프라인이다1.
기차 시간표로 읽으면 역이 노드, 기차 한 량이 패킷, 싣는 시간이 \(L/R\), 달리는 시간이 \(d_{\text{prop}}\), 역에 머무는 시간이 \(d_{\text{proc}}\)다. 다른 기차를 기다리는 시간(큐잉 지연)은 0으로 친다.
회선 스위칭의 그림은 세 구간으로 나뉜다.
Host 1        Node 1        Node 2        Host 2
  │ 설정 요청 ─────→ (처리) ─────→ (처리) ─────→ │   ┐
  │ ←───────────────── 수락 ──────────────────── │   ┘ circuit establishment
  │ DATA ═══════════════════════════════════════→ │   ┐ data transmission
  │ (M/R 동안 싣고, 마지막 비트는 경로 전파 지연 뒤 도착) │   ┘
  │ 해제 ──────────────────────────────────────→ │   ─ circuit termination
회선은 설정에 공을 들이고, 그 뒤 데이터는 노드에서 멈추지 않고 스트림으로 흐른다.
정의
이 방법은 경로의 링크 수, 링크마다 전송률과 전파 지연, 노드의 처리 시간, 보낼 데이터의 크기(패킷이면 헤더를 포함한 패킷 크기와 개수)가 주어질 때 쓴다. 큐잉 지연은 없거나 값이 주어져야 한다.
문제에 “~까지 걸리는 시간”, “회선 스위칭과 패킷 스위칭으로 각각”, “스위치 S를 거쳐”, “헤더 20바이트”, “처리 시간 0.1 ms” 같은 말이 보이면 이 방법을 떠올린다.
링크 \(H\)개, 링크마다 전송률 \(R\)과 전파 지연 \(d_{\text{prop}}\)인 경로에서 설정에 \(d_{\text{setup}}\)이 걸린 뒤 \(M\)비트를 흘려보낸다. 마지막 비트가 도착하는 시각은
\[T_{\text{circ}} = d_{\text{setup}} + \frac{M}{R} + H\,d_{\text{prop}}\]이다. 회선 위에서는 노드가 데이터를 멈추지 않고 넘긴다고 본다.
회선 스위칭의 전송 완료 시간을 \(\text{RTT} + M/R\)로 쓰기도 한다. 설정에 RTT 하나가 걸린다고 보고, 보내는 쪽이 마지막 비트를 내보낸 시각까지 센 값이다. 받는 쪽에 마지막 비트가 닿기까지는 한쪽 전파 지연 \(H\,d_{\text{prop}}\)가 더 걸린다2 [확인필요].
같은 경로로 길이 \(L\)비트(헤더 포함)인 패킷 \(P\)개를 보낸다. 다음을 가정한다.
- 패킷 \(P\)개는 시각 0에 출발지에 모두 있고, 다른 트래픽이 없다(큐잉 지연 0).
- 중간 노드는 패킷을 끝까지 받은 뒤 처리하고 내보낸다(저장 후 전달). 처리 시간은 패킷마다 \(d_{\text{proc}}\)이다.
- 노드는 앞 패킷을 내보내는 동안 다음 패킷을 처리할 수 있고, \(d_{\text{proc}} \le L/R\)이다.
그러면 마지막 패킷이 도착하는 시각은
\[T_{\text{pkt}} = (H + P - 1)\frac{L}{R} + H\,d_{\text{prop}} + (H - 1)\,d_{\text{proc}}\]이다. \(d_{\text{prop}} = d_{\text{proc}} = 0\)이면 패킷 스위칭의 저장 후 전달 지연 \((H + P - 1)L/R\)이 된다.
증명
전략: 패킷 \(k\)의 마지막 비트가 링크 \(i\)에 실리는 시각 \(F(k, i)\)의 점화식을 세우고, 닫힌 식을 \((k, i)\)에 대한 강한 귀납법으로 보인다. \(\tau = L/R\)(타우, 싣는 시간), \(\delta = d_{\text{prop}}\)(델타, 전파 지연), \(\rho = d_{\text{proc}}\)(로, 처리 시간)로 줄여 쓴다.
증명 펼치기
-
점화식. 출발지는 쉬지 않고 싣는다: \(F(k, 1) = k\tau\). 링크 \(i \ge 2\) 앞의 노드는 패킷 \(k\)를 시각 \(F(k, i-1) + \delta\)에 다 받는다. 처리는 이 시각과 앞 패킷의 처리가 끝난 시각 \(E(k-1, i-1)\) 중 늦은 쪽에 시작한다.
\[E(k, i-1) = \max\big(F(k, i-1) + \delta,\ E(k-1, i-1)\big) + \rho\]싣기는 처리가 끝나고, 링크가 앞 패킷을 다 실은 뒤에 시작한다.
\[F(k, i) = \max\big(E(k, i-1),\ F(k-1, i)\big) + \tau\]앞 패킷이 없으면(\(k = 1\)) 해당 항은 \(-\infty\)다. — 모형의 가정
- 주장. \(F(k, i) = i\tau + (i-1)(\delta+\rho) + (k-1)\tau\).
- 경계. \(i = 1\)이면 \(k\tau\)로 주장과 같다. \(k = 1\)이면 \(F(1, i) = F(1, i-1) + \delta + \rho + \tau\)이므로 \(F(1, i) = i\tau + (i-1)(\delta+\rho)\)다. — 점화식
- 처리는 기다리지 않는다. 귀납 가정으로 \(E(k-1, i-1) = F(k-1, i-1) + \delta + \rho = F(k, i-1) - \tau + \delta + \rho\)다. \(\rho \le \tau\)이므로 이 값은 \(F(k, i-1) + \delta\) 이하다. 따라서 \(E(k, i-1) = F(k, i-1) + \delta + \rho\). — 가정 \(d_{\text{proc}} \le L/R\)
- 두 기다림이 같다. \(F(k, i-1) + \delta + \rho\)와 \(F(k-1, i)\)에 귀납 가정을 넣으면 둘 다 \((i-1)\tau + (i-1)(\delta+\rho) + (k-1)\tau\)다. 따라서 \(F(k, i) = i\tau + (i-1)(\delta+\rho) + (k-1)\tau\). — 귀납 가정과 대수 정리
- 도착. 마지막 패킷은 \(F(P, H) + \delta = (H + P - 1)\tau + H\delta + (H-1)\rho\)에 도착한다. ∎
스스로 설명해 보기
- 1단계에서 \(E\)의 max 안 두 항
근거
앞 항은 저장 후 전달(패킷을 다 받아야 처리 시작), 뒤 항은 처리기가 한 번에 패킷 하나만 처리한다는 가정.
- 4단계에서 max가 앞 항이 되는 이유
근거
\(d_{\text{proc}} \le L/R\). 패킷은 \(L/R\) 간격으로 도착하므로, 처리가 그보다 짧으면 앞 패킷의 처리가 늘 먼저 끝나 있다.
- 5단계에서 두 항이 같아지는 것의 뜻
근거
패킷이 다음 링크에 실릴 준비가 되는 순간, 그 링크가 마침 앞 패킷을 다 실었다. 모든 링크의 전송률이 같아서 어느 단계도 병목이 아니다.
- 6단계에서 \(\delta\)를 한 번 더 더하는 이유
근거
\(F\)는 마지막 비트가 실리는 시각이고, 그 비트가 마지막 링크를 건너 목적지에 닿는 데 전파 지연이 한 번 더 든다.
- 이 증명의 핵심 아이디어는?
답
첫 패킷이 경로를 다 채우는 시간(링크마다 \(\tau + \delta\), 노드마다 \(\rho\))을 구하고, 뒤 패킷은 가장 느린 단계의 간격 \(\tau\)로 따라온다는 것. 파이프라인의 “채우는 시간 + 개수 × 간격”이다.
- 이 방법을 쓸 수 있는 다른 상황은?
답
CPU 명령어 파이프라인, 공장 조립 라인, 여러 단계를 거치는 데이터 처리 흐름. 단계마다 걸리는 시간이 다르면 간격은 가장 느린 단계가 정한다.
예제
대표 문제 두 개가 연습 문서에 있다. 소요시간 분석 예제 사다리는 하위목표 라벨을 단 네 문제이고, 는 같은 기법으로 회선과 패킷을 비교한다.
- \(P = 1\): \(H(L/R + d_{\text{prop}}) + (H-1)d_{\text{proc}}\). 링크마다 싣기와 전파가, 노드마다 처리가 한 번씩 더해진다.
- \(H = 1\)(스위치 없음): \(P \cdot L/R + d_{\text{prop}}\). 처리할 중간 노드가 없다.
- 가정 \(d_{\text{proc}} \le L/R\)을 빼면 처리가 병목이 된다. 링크 2개, 패킷 5개, \(L/R = 1\), \(d_{\text{proc}} = 3\), \(d_{\text{prop}} = 0\)이면 실제로는 17이 걸리지만 공식은 9를 준다.
- 처리와 싣기를 한 장치가 차례로 하면(겹치지 못하면) 노드에서의 간격이 \(d_{\text{proc}} + L/R\)로 늘어 공식보다 늦다.
활용
- 회선이냐 패킷이냐. 회선은 설정 시간을 한 번 내고 데이터는 헤더 없이 흐른다. 패킷은 설정이 없지만 패킷마다 헤더가 붙고 파이프라인을 채우는 시간이 든다. 그래서 데이터가 작으면 패킷이, 아주 크면 회선이 빨라질 수 있다. 예제 사다리 문제 4의 조건에서는 패킷 944개(약 9.4 Mbit)를 넘으면 회선이 빨라진다.
- 흔한 실수 1: 싣는 시간 \(L/R\)을 경로 전체에 한 번만 더하는 것. 저장 후 전달이라 링크마다 더한다.
- 흔한 실수 2: 파일을 패킷으로 나눴는데도 스위치가 파일 전체를 받은 뒤 보낸다고 계산하는 것(아래 오해).
- 흔한 실수 3: 단위 환산. 8 Mbps는 1 μs에 8비트, 1 ms에 8,000비트다. 8,160비트 패킷의 싣는 시간은 1.02 ms이지 1.02 μs가 아니다.
- 흔한 실수 4: 회선 스위칭에서 전파 지연을 빼먹는 것. 데이터도 경로의 링크 \(H\)개를 모두 건너야 한다.
연결
- 선수: 소요시간, 회선 스위칭, 패킷 스위칭
- 두 방식의 선택 기준 전체: 회선 스위칭과 패킷 스위칭 비교
- 전송 완료 시간으로 계산하는 처리량: 처리량
자주 하는 오해
틀렸다. “저장 후 전달”이라는 이름 때문에 무엇이든 전부 저장한 뒤 전달한다고 느끼기 쉽다. 실제로 저장하고 전달하는 단위는 패킷 하나다. 스위치는 패킷 1을 다 받자마자 내보내고, 그동안 패킷 2를 받는다. 확인하는 방법: 링크 2개, 8 Mbps, 전파 2 ms, 처리 0.1 ms에서 8,160비트 패킷 5,000개를 보낸다. 파일 단위로 계산하면 10,704 ms이지만, 패킷 단위로는 5,105.12 ms로 약 절반이다. 검증 코드의 시뮬레이션도 5,105.12 ms를 준다.
확인 문제
C1 회선 스위칭의 시간 흐름 그림을 이루는 세 구간의 이름을 쓰고, 각 구간에서 시간이 드는 원인을 쓰라.
답: ① 회선 설정(circuit establishment): 설정 요청이 목적지까지 갔다가 수락이 돌아온다. 링크마다 전파 지연, 노드마다 처리 지연이 든다. ② 데이터 전송(data transmission): \(M/R\) 동안 싣고, 마지막 비트는 경로 전체의 전파 지연 뒤에 도착한다. ③ 회선 해제(circuit termination): 해제 메시지가 경로를 지나간다.
C2 링크 3개(링크마다 1.5 Mbps, 전파 4 ms)로 이은 회선을 설정하는 데 30 ms가 걸린다. 3,000,000비트 파일의 마지막 비트는 언제 도착하는가?
답: \(30 + 3{,}000{,}000 / 1{,}500{,}000\text{ s} + 3 \times 4 = 30 + 2{,}000 + 12 = 2{,}042\) ms.
흔한 오답: 2,030 ms. 데이터가 링크 3개를 건너는 전파 지연 12 ms를 빠뜨렸다.
C3 링크 3개(링크마다 6 Mbps, 전파 4 ms), 스위치 처리 1 ms. 12,000비트 패킷 하나가 도착하는 데 걸리는 시간은?
답: \(L/R = 2\) ms. \(3 \times (2 + 4) + 2 \times 1 = 20\) ms.
흔한 오답: 8 ms(싣기 2 ms를 한 번만 더하고 전파를 경로 전체에 한 번만 더함), 21 ms(처리를 링크 수만큼 3번 더함). 처리는 중간 노드 수 \(H - 1 = 2\)번이다.
C4 위 예시(링크 3개, 싣기 2 ms, 전파 1 ms, 처리 0.5 ms, 패킷 3개)에서 패킷 2의 마지막 비트가 링크 2에 실리는 시각과, 패킷 3이 도착하는 시각을 구하라.
답: 7.5 ms와 14 ms. 패킷 2는 Node 1에 5 ms에 다 도착하고, 5.5 ms까지 처리한 뒤 7.5 ms까지 싣는다. 패킷 3은 첫 패킷 10 ms에서 2 ms 간격으로 두 번 뒤인 14 ms에 도착한다.
C5 패킷 스위칭 정리의 증명 4단계에서 “처리는 기다리지 않는다”가 맞는 근거는 무엇인가? 그 가정이 깨지는 예를 들어라.
답: 가정 \(d_{\text{proc}} \le L/R\). 패킷은 \(L/R\) 간격으로 도착하므로, 처리 시간이 그보다 짧으면 다음 패킷이 올 때 앞 처리가 이미 끝나 있다. 반례: 링크 2개, 패킷 5개, \(L/R = 1\), \(d_{\text{proc}} = 3\)이면 노드에서 줄이 생겨 실제 17, 공식 9다.
-
26_timing-analysis_plot.py로 그렸고, 위 표의 도착 시각 10, 12, 14 ms, Node 1과 Node 2가 패킷 1을 싣기 시작하는 3.5 ms와 7 ms, 정리의 식 \((H + P - 1)L/R + H\,d_{\text{prop}} + (H - 1)\,d_{\text{proc}} = 14\) ms를 같은 코드로 확인했다. ↩
-
회선 식의 해석(보내는 쪽 기준)은 Peterson & Davie, Computer Networks: A Systems Approach, 1.5절의 전송 시간 식과 같은 꼴이다. 받는 쪽 기준이면 한쪽 전파 지연을 더한다. ↩