메모리 프레임이 다 찼는데 새 페이지를 들여와야 하면, 지금 있는 페이지 하나를 내보내야 한다. 가장 좋은 선택은 앞으로 가장 늦게 쓰일 페이지지만 미래는 알 수 없다. 그래서 최근 기록으로 미래를 짐작한다. 가장 오래 안 쓴 페이지(LRU), 가장 먼저 들어온 페이지(FIFO), 사용 비트로 LRU를 싸게 흉내 낸 클록이 대표적이다. 짐작이 정확할수록 하드웨어와 시간이 더 든다.
예시로 보기
프레임 3개, 페이지 참조열 2 3 2 1 5 2 4 5 3 2 5 2. 처음 세 페이지(2, 3, 1)로 프레임을 채운 뒤의 페이지 부재를 센다.
| 참조 | 2 | 3 | 2 | 1 | 5 | 2 | 4 | 5 | 3 | 2 | 5 | 2 | 부재 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| OPT | F | F | F | 3 | |||||||||
| LRU | F | F | F | F | 4 | ||||||||
| FIFO | F | F | F | F | F | F | 6 | ||||||
| CLOCK | F | F | F | F | F | 5 |
5가 들어올 때 OPT는 앞으로 다시 쓰이지 않는 1을 내보낸다. LRU는 마지막으로 쓴 지 가장 오래된 3을 내보낸다(3은 시각 1, 2는 시각 2, 1은 시각 3에 마지막으로 쓰였다). FIFO는 가장 먼저 들어온 2를 내보내는데, 2는 바로 다음에 또 쓰여 곧 다시 부재가 난다. LRU는 2와 5가 자주 쓰인다는 것을 알아채고, FIFO는 알아채지 못한다.
정확히 말하면
교체 정책은 주기억장치의 프레임이 모두 차 있을 때 새 페이지를 들이려면 지금 있는 페이지 중 무엇을 내보낼지 정한다. 내보낼 페이지는 가까운 미래에 가장 덜 참조될 페이지여야 한다. 대부분의 정책은 지역성에 기대어 과거로 미래를 짐작한다.
프레임 잠금. 잠긴 프레임의 페이지는 교체하지 않는다. 운영체제 커널, 핵심 제어 구조, 입출력 버퍼가 들어 있는 프레임이 그렇다. 프레임마다 잠금 비트를 둔다.
| 알고리즘 | 내보내는 페이지 | 특징 |
|---|---|---|
| 최적 (OPT) | 다음 참조까지 시간이 가장 긴 페이지 | 가장 적은 부재. 미래를 알아야 해서 구현할 수 없다. 다른 알고리즘을 재는 기준이다 |
| LRU | 가장 오랫동안 참조되지 않은 페이지 | 지역성에 따르면 가까운 미래에 가장 덜 쓰일 페이지라 OPT에 가깝다. 페이지마다 마지막 참조 시각을 적어야 해서 부담이 크다 |
| FIFO | 메모리에 가장 오래 있었던 페이지 | 할당된 프레임을 원형 버퍼처럼 돌아가며 내보낸다. 가장 단순하다. 오래 있었다고 안 쓰는 것은 아니라서, 곧 다시 필요할 수 있다 |
| 클록 (CLOCK) | 사용 비트가 0인 첫 페이지 | 아래 설명 |
클록 알고리즘. 프레임마다 사용 비트를 하나 둔다.
- 페이지가 처음 들어오거나 참조되면 사용 비트를 1로 한다.
- 교체할 때가 되면 시곗바늘이 가리키는 프레임부터 돌며, 사용 비트가 1인 프레임은 0으로 바꾸고 지나간다.
- 사용 비트가 이미 0인 첫 프레임의 페이지를 내보낸다. 바늘은 그다음 프레임으로 간다.
최근에 쓴 페이지는 사용 비트가 1이라 한 바퀴를 버틴다. 그래서 자주 쓰는 2와 5를 잘 지킨다. LRU처럼 시각을 기록하지 않고 비트 하나로 LRU에 가까운 효과를 낸다. 사용 비트에 변경 비트를 더한 변형도 있다. 최근에 안 쓰였고 바뀌지도 않은 페이지를 먼저 고른다. 바뀌지 않은 페이지는 디스크에 다시 쓸 필요가 없어 내보내기가 싸다1.
CLOCK 실행 추적
*는 사용 비트 1, >는 시곗바늘 위치다.
| 시각 | 참조 | 프레임 상태 | 부재 |
|---|---|---|---|
| 0~3 | 2 3 2 1 | >2* 3* 1* | (채우기) |
| 4 | 5 | 모두 1 → 모두 0으로 바꾸고 한 바퀴. 2를 내보냄: 5* >3 1 | F |
| 5 | 2 | 3이 0 → 3을 내보냄: 5* 2* >1 | F |
| 6 | 4 | 1이 0 → 1을 내보냄: >5* 2* 4* | F |
| 7 | 5 | 적중 | |
| 8 | 3 | 모두 1 → 0으로 바꾸며 한 바퀴. 5를 내보냄: 3* >2 4 | F |
| 9 | 2 | 적중: 3* >2* 4 | |
| 10 | 5 | 2는 1 → 0, 4가 0 → 4를 내보냄: >3* 2 5* | F |
| 11 | 2 | 적중 |
성능 비교
프로세스에 줄 프레임 수를 6~14개로 바꿔 가며 1000번 참조당 부재 수를 잰 비교가 있다1. 프레임이 6개일 때 FIFO 약 37, 클록 약 31, LRU 약 24, OPT 약 16이다. 프레임이 늘수록 네 알고리즘의 차이가 줄어든다.
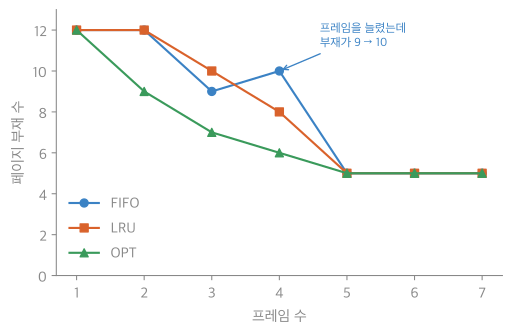
벨레이디의 참조열 1 2 3 4 1 2 5 1 2 3 4 5에서 프레임 수를 1개부터 7개까지 바꿔 센 부재 수다(처음 채우는 부재 포함). LRU와 OPT의 선은 오른쪽으로 갈수록 내려가거나 그대로인데, FIFO 선만 프레임 3개에서 4개로 갈 때 위로 꺾인다. 프레임이 5개 이상이면 다섯 페이지가 다 들어가 세 알고리즘 모두 처음 채우는 부재 5번만 낸다2.
페이지 버퍼링
LRU와 클록은 복잡하고 부담이 있다. 또 바뀐 페이지를 내보내는 것은 디스크에 써야 해서 안 바뀐 페이지보다 비싸다. 그래서 내보낸 페이지를 바로 버리지 않고 두 목록 중 하나에 넣는다.
- 바뀌지 않았으면 빈 페이지 목록
- 바뀌었으면 변경 페이지 목록
목록의 페이지는 아직 메모리에 있다. 곧 다시 참조되면 디스크에서 가져오지 않고 목록에서 되찾는다. 변경 페이지 목록은 모아 두었다가 한꺼번에 디스크에 쓴다. 페이지 버퍼가 일종의 캐시 역할을 한다.
정확성과 복잡도
모든 알고리즘은 “부재가 나면 프레임 하나를 비워 요청 페이지를 넣는다”는 성질을 지키므로, 참조된 페이지는 늘 실행 전에 메모리에 있다. 알고리즘마다 다른 것은 비우는 프레임의 선택뿐이다3.
| 알고리즘 | 부재 한 번에 드는 일 (프레임 \(k\)개) |
|---|---|
| FIFO | 큐 맨 앞 하나: \(O(1)\) |
| LRU | 마지막 참조 시각이 가장 작은 것 찾기: \(O(k)\), 또는 참조마다 순서 목록 갱신 |
| CLOCK | 바늘이 최대 한 바퀴 돔: 최악 \(O(k)\), 보통은 몇 칸 |
| OPT | 앞으로의 참조열을 모두 봐야 함(실제로는 불가능) |
스스로 설명해 보기
- OPT는 5가 들어올 때 1을 내보낸다.
근거
이후 참조 2 4 5 3 2 5 2에서 2는 바로 다음, 3은 여덟 번째 뒤에 다시 쓰이지만 1은 다시 쓰이지 않는다. 다음 참조까지 가장 먼 것은 1이다.
- FIFO는 시각 5에 2를 내보낸 직후 2 때문에 부재를 낸다.
근거
FIFO는 들어온 순서만 본다. 2는 가장 먼저 들어왔지만 계속 쓰이는 페이지였다. “오래 있었다”와 “안 쓴다”는 다르다.
- 클록은 사용 비트로 LRU를 흉내 낸다.
근거
사용 비트 1은 “바늘이 지난번에 지나간 뒤로 쓰였다”는 뜻이다. 바늘이 다시 올 때까지 안 쓰인 페이지만 내보내므로, 대략 “최근에 안 쓴 것”을 고르게 된다. 다만 쓴 순서까지는 모른다.
- 핵심 아이디어는?
답
미래를 모르니 과거로 짐작한다. 지역성 때문에 “최근에 쓴 것은 곧 또 쓴다”가 대체로 맞다. 그 짐작을 얼마나 정확히, 얼마나 싸게 하느냐로 알고리즘이 갈린다.
- 같은 생각을 쓰는 다른 곳은?
답
캐시 메모리의 교체, 웹 브라우저 캐시, 데이터베이스 버퍼 풀. 모두 LRU나 그 근사를 쓴다.
활용
- SVR4 UNIX는 손이 둘인 클록을 쓴다. 앞 바늘이 사용 비트를 0으로 바꾸고, 일정 간격(handspread) 뒤의 뒷 바늘이 그때까지도 0인 페이지를 교체 후보로 모은다. 바늘이 도는 속도(scanrate)와 간격은 부팅 때 메모리 크기로 정한다.
- 리눅스는 클록을 바탕으로, 사용 비트 대신 8비트 나이 값을 쓴다. 참조마다 늘리고 주기적으로 줄여서, 나이가 0인 페이지를 교체 후보로 삼는다. 쓴 횟수를 보는 LFU의 한 형태다.
- 계산 연습: 페이지 교체 예제 사다리
연결
- 선수: 가상 메모리, 캐시 메모리 (LRU와 LFU의 구별)
- 몇 프레임을 줄지, 누구의 페이지 중에서 고를지: 상주 집합 관리와 적재 제어
자주 하는 오해
틀렸다. 메모리가 많으면 당연히 나아 보인다. 하지만 FIFO에서는 프레임을 늘렸는데 부재가 늘 수 있다(벨레이디의 이상 현상). 참조열 1 2 3 4 1 2 5 1 2 3 4 5에서 FIFO는 프레임 3개일 때 9번, 4개일 때 10번 부재를 낸다. LRU와 OPT는 이런 일이 없다. 프레임 \(k\)개일 때 메모리에 있는 페이지가 늘 \(k+1\)개일 때의 부분집합이기 때문이다3.
틀렸다. 바늘이 원형으로 도는 모양은 FIFO와 같다. 하지만 사용 비트가 1인 페이지는 한 바퀴를 더 살려 주므로, 자주 쓰는 페이지를 내보내지 않는다. 위 예에서 FIFO 6번, 클록 5번, LRU 4번이고, 프레임 수를 바꿔 가며 잰 비교에서도 클록은 FIFO와 LRU 사이에 있다.
확인 문제
C1 OPT, LRU, FIFO가 각각 내보내는 페이지를 한 줄씩 쓰라.
답: OPT: 다음 참조까지 시간이 가장 긴 페이지. LRU: 가장 오랫동안 참조되지 않은 페이지. FIFO: 메모리에 가장 먼저 들어온 페이지.
C2 프레임 3개, 참조열 7 0 1 2 0 3 0 4 2 3. 처음 세 페이지로 채운 뒤 OPT, LRU, FIFO의 부재 수는?
답: OPT 3, LRU 5, FIFO 6.
과정(LRU): 2 → 7 교체(F), 0 적중, 3 → 1 교체(F), 0 적중, 4 → 2 교체(F), 2 → 3 교체(F), 3 → 0 교체(F).
C3 클록 알고리즘이 교체할 때 하는 일을 쉬운 말 한 문장으로 쓰라.
답: 바늘을 돌리며 최근에 쓰인(사용 비트 1) 페이지는 한 번 봐주고(0으로 바꾸고) 지나가다가, 지난 한 바퀴 동안 안 쓰인(사용 비트 0) 첫 페이지를 내보낸다.
C4 LRU가 OPT에 가까운 성능을 내는 이유를 지역성으로 설명하라. LRU가 나쁘게 동작하는 참조 패턴의 예도 들라.
답: 지역성 때문에 최근에 안 쓴 페이지는 가까운 미래에도 안 쓸 가능성이 크다. 그래서 과거를 거꾸로 본 LRU의 선택이 미래를 본 OPT의 선택과 자주 같다. 반대로 프레임보다 하나 많은 페이지를 순서대로 되풀이해 쓰면(프레임 3개에 1 2 3 4 1 2 3 4 …) LRU는 늘 다음에 쓸 페이지를 내보내 매번 부재가 난다.
C5 “프레임을 늘리면 부재가 줄어든다”가 FIFO에서 깨지는 예를 보여라.
답: 참조열 1 2 3 4 1 2 5 1 2 3 4 5. FIFO, 프레임 3개면 부재 9번, 4개면 10번(처음 채우는 부재 포함). 벨레이디의 이상 현상이다.
-
Stallings, Operating Systems: Internals and Design Principles 6판, 8.2절 그림 8.16(클록 정책), 그림 8.17(프레임 수에 따른 네 알고리즘의 부재 수, 그래프에서 읽은 값), 그림 8.18(사용 비트와 변경 비트를 함께 쓰는 클록). ↩ ↩2
-
41_page-replacement_plot.py로 그렸고, FIFO 9번 → 10번, LRU 10번 → 8번, LRU·OPT의 부재 수가 프레임을 늘릴 때 늘지 않음을 같은 코드로 확인했다. ↩
-
Stallings 6판 8.2절과 Silberschatz, Operating System Concepts 9장을 바탕으로 보탰다. ↩ ↩2