버퍼링은 장치와 프로세스 사이에 운영체제의 메모리 칸(버퍼)을 두고, 입력은 필요하기 전에 미리 받아 두고 출력은 요청 뒤에 천천히 내보내는 방법이다. 식당 주방의 배식대처럼, 요리사와 손님이 서로의 속도에 묶이지 않게 해 준다. 버퍼가 둘이면 한쪽을 채우는 동안 다른 쪽을 비울 수 있다. 하지만 프로세스의 평균 요구가 장치 속도보다 크면 버퍼를 아무리 늘려도 결국 다 차서 기다려야 한다.
예시로 보기
디스크에서 블록 하나를 읽는 데 \(T\), 프로세스가 블록 하나를 처리하는 데 \(C\), 운영체제 버퍼에서 사용자 메모리로 옮기는 데 \(M\)이 든다고 하자. \(T = 10\), \(C = 4\), \(M = 1\) ms면 블록 하나당 시간은 다음과 같다.
| 방식 | 블록당 시간 | 이 예 |
|---|---|---|
| 버퍼 없음 | \(T + C\) | 14 ms |
| 단일 버퍼 | \(\max(C, T) + M\) | 11 ms |
| 이중 버퍼 | \(\max(C, T)\) | 10 ms |
버퍼가 없으면 읽는 동안 처리를 못 하고, 처리하는 동안 읽지 못한다. 단일 버퍼는 지금 블록을 처리하는 동안 다음 블록을 미리 읽어 둔다. 이중 버퍼는 옮기는 시간 \(M\)까지 숨긴다.
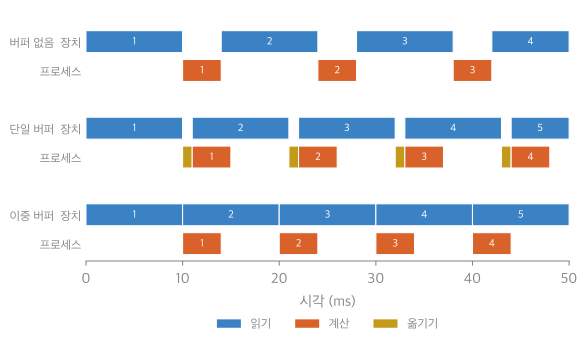
막대 안의 숫자는 블록 번호다. 버퍼가 없으면 계산하는 동안 장치 줄이 빈다. 단일 버퍼에서는 계산이 다음 읽기와 겹치지만, 옮기는 1 ms(노란 막대) 동안 장치가 다음 읽기를 시작하지 못한다. 이중 버퍼에서는 장치가 쉬지 않고 읽어 블록이 10 ms마다 끝난다1.
정확히 말하면
왜 필요한가. 프로세스는 입출력이 끝나야 다음으로 간다. 게다가 사용자 메모리로 바로 입출력하면, 교착상태를 막으려고 그 메모리 페이지를 입출력이 끝날 때까지 주기억장치에 묶어 둬야 한다. 그러면 그 프로세스는 스와핑으로 내보낼 수 없다. 운영체제 버퍼를 쓰면 이 부담을 피하고, 입력은 요청 전에, 출력은 요청 뒤에 할 수 있다.
| 장치 종류 | 버퍼링 단위 | 예 |
|---|---|---|
| 블록 지향 | 고정 크기 블록. 블록 번호로 데이터를 찾는다 | 디스크, USB 메모리 |
| 스트림 지향 | 바이트의 흐름 | 터미널, 프린터, 통신 포트, 마우스, 2차 기억장치가 아닌 대부분의 장치 |
버퍼 없음. 운영체제가 필요할 때마다 장치에 바로 접근한다.
단일 버퍼. 입출력 요청마다 운영체제가 주기억장치의 시스템 영역에 버퍼 하나를 준다.
- 블록 지향: 입력을 시스템 버퍼로 받고, 끝나면 블록을 사용자 공간으로 옮긴 뒤 곧바로 다음 블록을 요청한다. 다음 블록이 곧 필요하리라 보고 미리 읽는 것이다(미리 읽기). 데이터는 대개 차례로 읽히므로 대부분 맞고, 마지막에 한 블록을 쓸데없이 읽을 뿐이다.
- 스트림 지향: 한 줄씩(줄 끝의 캐리지 리턴으로 줄이 끝남을 알림, 터미널) 또는 한 바이트씩(키 하나하나가 중요한 장치, 센서·컨트롤러) 다룬다.
이중 버퍼. 시스템 버퍼를 둘 둔다. 운영체제가 한 버퍼를 비우거나 채우는 동안 프로세스는 다른 버퍼와 주고받는다.
순환 버퍼. 버퍼를 셋 이상 두고 원형으로 돌려 쓴다. 프로세스가 짧은 시간에 입출력을 몰아서 하면 이중 버퍼로도 모자라기 때문이다. 원형으로 도는 버퍼 칸은 생산자-소비자 문제의 유한 버퍼와 같다.
            입출력 장치          운영체제 영역                사용자 프로세스
버퍼 없음   [장치] ------------------------------------------> [사용자 메모리]
단일 버퍼   [장치] -------> [버퍼]  ----------- 옮김 --------> [사용자 메모리]
이중 버퍼   [장치] -------> [버퍼 1] [버퍼 2]  -- 옮김 ------> [사용자 메모리]
                            (장치가 하나를 채우는 동안 다른 하나를 옮김)
순환 버퍼   [장치] -------> [1] [2] [3] ... [n]  -- 옮김 ----> [사용자 메모리]
                            (칸을 차례로 돌아가며 채우고 비움)
아래로 갈수록 장치와 사용자 프로세스 사이에 버퍼가 늘어난다. 버퍼가 많을수록 장치가 채우는 일과 프로세스가 가져가는 일이 서로를 덜 기다린다.
한계. 버퍼링은 입출력 요구의 봉우리를 평평하게 깎는다. 하지만 프로세스의 평균 요구가 장치가 처리할 수 있는 양보다 크면, 버퍼가 아무리 많아도 결국 모두 차고 프로세스는 데이터 묶음마다 기다리게 된다. 그래도 여러 입출력과 여러 프로세스가 섞여 도는 다중 프로그래밍 환경에서는 운영체제 효율과 개별 프로세스 성능을 높인다.
활용
- SVR4 UNIX의 버퍼 캐시는 디스크 블록용 버퍼를 빈 목록, 장치 목록, 드라이버 입출력 큐의 세 목록으로 관리한다. 터미널·프린터 같은 문자 장치에는 생산자-소비자 방식의 문자 큐를 쓴다.
- 버퍼 없는 입출력은 장치와 프로세스 공간 사이의 DMA라 가장 빠르다. 대신 프로세스가 주기억장치에 묶여 스와핑되지 못하고, 그동안 장치를 다른 프로세스가 쓸 수 없다.
- 화면 그래픽의 “더블 버퍼링”도 같은 생각이다. 보이지 않는 버퍼에 다음 화면을 그리는 동안 다른 버퍼를 화면에 보여 준다.
연결
- 선수: 입출력 장치와 입출력 설계, 생산자-소비자 문제
- 블록 버퍼를 다시 쓰는 캐시: 디스크 캐시
확인 문제
C1 블록 하나를 읽는 데 T = 5 ms, 처리하는 데 C = 8 ms, 옮기는 데 M = 1 ms다. 버퍼 없음, 단일 버퍼, 이중 버퍼의 블록당 시간은? 어느 쪽이 병목인가?
답: 버퍼 없음 13 ms, 단일 버퍼 \(\max(8, 5) + 1 = 9\) ms, 이중 버퍼 8 ms. C > T라 프로세스(처리)가 병목이다. 버퍼를 더 늘려도 8 ms 아래로는 줄지 않는다.
C2 사용자 메모리로 직접 입출력하면 그 프로세스를 스와핑할 수 없는 이유는?
답: 장치(DMA)가 그 메모리 주소로 데이터를 쓰는 중이다. 프로세스를 디스크로 내보내고 그 프레임을 다른 프로세스에 주면, 장치가 남의 메모리를 덮어쓰거나 데이터가 사라진다. 그래서 입출력이 끝날 때까지 그 페이지를 주기억장치에 묶어 둬야 한다.
C3 키보드 입력을 줄 단위 버퍼로 받는 터미널과 키 하나씩 받는 게임 중 어느 쪽에 어떤 방식이 맞는가? 이유는?
답: 명령어를 치는 터미널은 줄 단위. 엔터를 누를 때 한 줄이 완성되어야 의미가 있고, 그전엔 지우고 고칠 수 있다. 게임은 바이트(키) 단위. 키 하나하나가 곧바로 동작을 일으켜야 한다.
-
52_io-buffering_plot.py로 그렸고, 세 방식에서 블록이 끝나는 간격 14, 11, 10 ms를 같은 코드로 확인했다. ↩