하드 디스크에서 데이터를 읽으려면 읽기 머리(헤드)를 원하는 트랙까지 팔로 옮겨야 하는데, 이 팔 움직임이 가장 느리다. 그래서 요청이 여러 개 쌓이면 어떤 순서로 처리하느냐에 따라 팔이 움직이는 거리가 크게 달라진다. 엘리베이터가 층 버튼이 눌린 순서가 아니라 한 방향으로 쭉 가며 태우는 것과 같다. 가까운 것부터 처리하면 이동은 줄지만 멀리 있는 요청이 굶을 수 있어, 이동 거리와 공평성을 맞바꾼다.
예시로 보기
트랙이 200개(0~199)인 디스크의 헤드가 트랙 100에 있다. 요청이 55, 58, 39, 18, 90, 160, 150, 38, 184 순서로 와 있다.
| 정책 | 처리 순서 | 이동한 트랙 수 합 | 평균 |
|---|---|---|---|
| FIFO | 55 58 39 18 90 160 150 38 184 | 498 | 55.3 |
| SSTF | 90 58 55 39 38 18 150 160 184 | 248 | 27.6 |
| SCAN (트랙이 커지는 방향으로 시작) | 150 160 184 90 58 55 39 38 18 | 250 | 27.8 |
| C-SCAN (트랙이 커지는 방향으로만) | 150 160 184 18 38 39 55 58 90 | 322 | 35.8 |
FIFO는 55 → 18 → 90 → 160 → 38 → 184처럼 디스크를 오락가락한다. SSTF는 늘 가장 가까운 요청으로 가서 이동이 절반 이하로 준다.
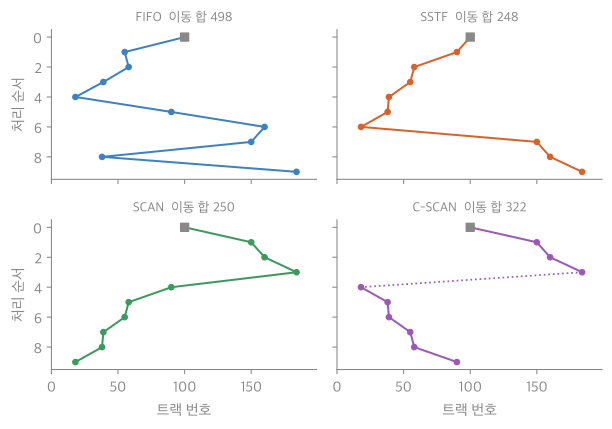
가로축은 헤드가 있는 트랙, 세로축은 처리한 순서다(네모가 출발점 100). FIFO는 좌우로 크게 오가고, SCAN은 방향을 한 번만 바꾼다. C-SCAN의 점선은 184에서 18까지 요청을 처리하지 않고 건너가는 구간이고, 이 거리도 이동 합 322에 들어간다1.
정확히 말하면
디스크 성능
디스크는 일정한 속도로 돈다. 읽거나 쓰려면 헤드가 원하는 트랙에, 그리고 그 트랙에서 원하는 섹터의 시작에 있어야 한다. 트랙을 고르는 것은 움직이는 헤드라면 팔을 옮기는 일이고, 고정 헤드라면 여러 헤드 중 하나를 전기적으로 고르는 일이다.
접근 시간은 두 부분의 합이다.
- 탐색 시간: 헤드를 원하는 트랙으로 옮기는 시간
- 회전 지연: 원하는 섹터의 시작이 헤드 아래로 돌아오기까지의 시간
그다음 섹터가 헤드 아래를 지나가는 동안 실제로 읽거나 쓴다. 이 시간이 전송 시간이다.
그 앞에 장치가 비기를, 채널이 비기를 기다리는 시간이 붙을 수 있다.
기호로 쓰면. 평균 탐색 시간 \(T_s\), 회전 속도 \(r\)(초당 회전 수), 한 트랙의 바이트 수 \(N\), 옮길 바이트 수 \(b\)라 하자. 평균 회전 지연은 반 바퀴라 \(1/(2r)\)이고, 전송 시간은 옮길 양이 한 트랙의 몇 분의 몇인지에 한 바퀴 시간을 곱한 \(b/(rN)\)이다.
\[T_a = T_s + \frac{1}{2r} + \frac{b}{rN}\]예: 평균 탐색 4 ms, 15,000 rpm(한 바퀴 4 ms), 섹터 512바이트, 트랙당 500섹터. 섹터 2,500개(5트랙)를 읽는다.
| 배치 | 계산 | 시간 |
|---|---|---|
| 이어서 놓임 | 첫 트랙: 4 + 2 + 4 = 10 ms. 나머지 4트랙은 탐색 없이 회전 지연 2 + 한 바퀴 4 = 6 ms씩 | 10 + 4 × 6 = 34 ms |
| 흩어져 놓임 | 섹터마다 4 + 2 + 0.008 = 6.008 ms | 2,500 × 6.008 = 15.02 s |
같은 양인데 440배쯤 차이가 난다. 탐색과 회전 지연이 전송보다 훨씬 크기 때문이다. 디스크 스케줄링은 이 탐색 시간을 줄이려는 것이다.
정책
| 정책 | 고르는 요청 | 특징 |
|---|---|---|
| FIFO | 들어온 순서 | 모두에게 공평하다. 프로세스가 많으면 무작위 순서와 성능이 비슷해진다 |
| 우선순위 (PRI) | 요청한 프로세스의 우선순위 | 디스크 효율이 목적이 아니다. 짧은 작업과 대화형 작업의 응답을 좋게 하지만 긴 작업은 오래 기다린다. 데이터베이스에는 나쁘다 |
| LIFO | 가장 최근 요청 | 방금 쓴 사용자에게 장치를 주므로 팔이 거의 안 움직인다. 트랜잭션 처리에 좋다. 줄 끝으로 밀린 요청은 굶을 수 있다 |
| SSTF | 지금 위치에서 팔을 가장 적게 움직이는 요청 | 늘 최소 탐색을 고르지만, 여러 번의 평균 탐색이 최소라는 보장은 없다. 거리가 같으면 임의로 고른다 |
| SCAN | 한 방향으로만 가며 지나가는 요청을 모두 처리하고, 끝에 이르면 방향을 바꾼다 | 아래 설명 |
| C-SCAN | 한 방향으로만 처리하고, 끝에 이르면 반대쪽 끝으로 돌아가 다시 같은 방향으로 처리한다 | 새 요청의 최대 대기 시간이 줄어든다 |
| N-step-SCAN | 요청 큐를 길이 \(N\)인 하위 큐로 나누고 하나씩 SCAN으로 처리한다. 처리 중에 온 요청은 다른 큐에 넣는다 | 팔이 한 트랙에 붙잡히지 않는다 |
| FSCAN | 하위 큐 둘. 스캔을 시작할 때 모든 요청은 한 큐에 있고, 스캔 중 새 요청은 다른 큐로 간다 | 새 요청은 옛 요청을 다 처리한 뒤에 처리된다 |
SCAN과 LOOK. Stallings의 SCAN은 “마지막 트랙에 이르거나 그 방향에 요청이 더 없을 때” 방향을 바꾼다. 뒤쪽 방식은 LOOK이라고도 부른다. 위 예의 SCAN도 184에서 돌아서므로 사실상 LOOK이다. 다른 교재(예: Silberschatz)는 SCAN을 디스크 끝(199)까지 가는 것으로, LOOK을 마지막 요청에서 돌아서는 것으로 구별한다. 이 예에서 끝까지 가는 SCAN이면 이동 합은 \(99 + 181 = 280\)으로 250보다 크다.
| 이름 | Stallings | Silberschatz |
|---|---|---|
| SCAN | 마지막 요청(또는 끝)에서 돌아섬 | 디스크 끝까지 감 |
| LOOK | 위와 같은 것의 다른 이름 | 마지막 요청에서 돌아섬 |
SCAN은 가장 안쪽과 바깥쪽 트랙의 요청, 그리고 가장 늦게 도착한 요청에 유리하다. C-SCAN은 한쪽 끝 근처 요청이 왕복 두 번을 기다리는 일이 없어 대기 시간의 편차가 작다.
SSTF·SCAN·C-SCAN의 정체. 팔이 한 트랙 근처에 계속 새 요청이 들어오면, SSTF·SCAN·C-SCAN은 그 근처에서 떠나지 못할 수 있다(팔 붙잡힘). N-step-SCAN과 FSCAN이 이를 막는다.
정책 요약
여러 정책을 무엇을 보고 고르느냐로 묶으면 다음과 같다2.
| 기준 | 정책 | 비고 |
|---|---|---|
| 요청자에 따라 | RSS(무작위) | 분석·시뮬레이션용 |
| FIFO | 가장 공평 | |
| PRI | 디스크 큐 관리 밖에서 통제 | |
| LIFO | 지역성과 자원 이용 극대화 | |
| 요청 항목에 따라 | SSTF | 이용률 높음, 큐 짧음 |
| SCAN | 서비스가 고르게 분포 | |
| C-SCAN | 서비스 편차 작음 | |
| N-step-SCAN | 서비스 보장 | |
| FSCAN | 부하에 민감 |
정확성과 복잡도
모든 정책은 큐의 요청을 하나도 빠뜨리지 않고 처리한다(SSTF·SCAN·C-SCAN은 새 요청이 계속 오면 굶는 요청이 생길 수 있다는 점만 다르다). 요청 \(k\)개를 고르는 비용은 FIFO \(O(1)\), SSTF는 매번 가장 가까운 것을 찾아 \(O(k)\), SCAN·C-SCAN은 트랙 순으로 정렬해 두면 다음 요청을 \(O(1)\)에 찾는다.
스스로 설명해 보기
- SSTF는 처음에 90으로 간다.
근거
헤드가 100에 있고 가장 가까운 요청은 90(거리 10)이다. 150은 50, 58은 42 떨어져 있다.
- SSTF는 18을 처리한 뒤 150까지 132를 한 번에 움직인다.
근거
작은 쪽 요청(58, 55, 39, 38, 18)이 가까워서 먼저 다 처리하고 나니, 남은 요청은 모두 큰 쪽(150, 160, 184)에 있다. 가장 가까운 150도 132 떨어져 있다.
- C-SCAN의 184 → 18 이동은 166인데 SCAN의 184 → 90은 94다.
근거
C-SCAN은 반대쪽 끝(가장 작은 요청 18)으로 건너가 다시 큰 방향으로 처리한다. SCAN은 방향만 바꿔 가까운 90부터 내려온다. 그래서 이동 합은 C-SCAN이 크지만, 대기 시간은 더 고르다.
- 핵심 아이디어는?
답
탐색 시간이 접근 시간을 지배하므로 처리 순서를 바꿔 팔 이동을 줄인다. 다만 이동만 줄이면 특정 요청이 굶으므로, 한 방향으로 쓸고 지나가는 규칙으로 공평성을 되찾는다.
- 같은 생각을 쓰는 다른 곳은?
답
엘리베이터 운행, 택배 배송 경로. 스케줄링 알고리즘의 SPN이 짧은 작업을 먼저 해 평균을 줄이고 긴 작업을 굶기는 것과 SSTF는 같은 구조다.
활용
- 리눅스는 엘리베이터 스케줄러(요청 큐 하나를 블록 번호로 정렬해 한 방향으로 처리), 데드라인 스케줄러(읽기 FIFO 큐·쓰기 FIFO 큐를 따로 두고 요청마다 만료 시각을 두어 굶주림 방지), 예측(anticipatory) 스케줄러(읽기를 처리한 뒤 잠깐 기다려 근처의 새 읽기 요청을 받음)를 썼다.
- SSD는 팔이 없어 탐색 시간이 거의 없으므로, 이런 정책의 이득이 작다.
- 계산 연습: 디스크 스케줄링 예제 사다리
연결
- 선수: 입출력 장치와 입출력 설계, 스케줄링 알고리즘 (SSTF ↔ SPN)
- 여러 디스크로 성능과 안전을 높이기: RAID
자주 하는 오해
틀렸다. 매 순간 최선이 전체 최선을 보장하지는 않는다. 예시에서 SSTF는 작은 쪽을 먼저 다 처리하고 18에서 150까지 132를 한 번에 건너야 했다. 게다가 가까운 요청이 계속 오면 먼 요청은 굶는다.
교재마다 다르다. Stallings의 SCAN은 요청이 더 없으면 끝까지 가지 않고 돌아서며, 위 예의 SCAN도 184에서 돌아선다. 끝까지 가는 버전을 SCAN, 돌아서는 버전을 LOOK이라 구별하는 교재도 있다. 문제를 풀 때는 어느 정의를 쓰는지 먼저 확인한다.
과목별 관점
어셈블리어 (2-1학기). 디스크의 생김새를 이름 붙여 설명한다.
- 트랙과 섹터. 트랙은 자료가 놓이는 동심원 하나다. 섹터는 트랙을 자른 한 조각이다.
- 실린더. 디스크는 원판(플래터) 여러 장이 한 축에 꽂혀 돌고, 판의 면마다 읽기 머리가 하나씩 있다. 머리들은 한 팔에 묶여 같이 움직인다. 머리를 한 자리에 둔 채로 읽을 수 있는 트랙 전부, 곧 모든 면의 같은 번호 트랙을 묶어 실린더라 부른다.
- 탐색. 머리를 다른 트랙으로 옮기는 일이다. 위 정의의 탐색 시간이 이 움직임에 드는 시간이다.
이 과목은 스케줄링 정책 대신 파일이 놓인 모양이 탐색을 얼마나 늘리는지를 본다. 한 파일의 섹터가 디스크의 붙어 있는 자리에 있지 않으면 조각난 파일이라 부른다. 조각난 파일을 읽으면 머리가 건너뛰어야 해서 읽기가 느려지고, 읽기·쓰기 오류가 날 수도 있다. 파일이 어떻게 조각나는지는 클러스터와 FAT의 사슬 그림에 있다.
데이터베이스 설계 (2-2학기). 같은 디스크를 다른 물음으로 본다. 운영체제는 쌓인 요청을 어떤 순서로 처리해야 팔이 덜 움직이는지를 묻는다. 데이터베이스는 연산 하나가 디스크를 몇 번 읽고 쓰는지를 묻는다.
데이터를 읽으러 갈 때 기계가 움직이는 것은 원판의 회전과 팔의 이동 둘이다. 이 움직임 때문에 디스크는 주기억장치를 읽을 때보다 10만 배쯤(10의 다섯 제곱 배) 오래 걸린다. 그래서 데이터베이스 연산의 실행 시간은 주로 디스크를 읽고 쓰는 횟수로 정해지고, 한 번 읽거나 쓸 때 되도록 많은 정보를 옮기려 한다. 원판을 여러 장 쓰면 용량은 늘지만 빨라지지는 않는다.
데이터베이스는 전체를 디스크에 두고 필요한 조각만 주기억장치로 읽어 온다. 읽어 오는 일을 Disk-Read, 고친 조각을 디스크에 다시 쓰는 일을 Disk-Write라 부르고, 알고리즘의 비용을 이 둘의 횟수로 센다. 이 횟수를 줄이려고 만든 자료구조가 B-트리다.
확인 문제
C1 디스크 접근 시간의 두 부분과, 그 뒤에 오는 시간을 쓰라. 셋 중 보통 가장 큰 것은?
답: 탐색 시간, 회전 지연. 그 뒤에 전송 시간. 보통 탐색 시간이 가장 크다.
C2 헤드 50, 요청 82 170 43 140 24 16 190(트랙 0~199). SSTF의 처리 순서와 이동 합은?
답: 43, 24, 16, 82, 140, 170, 190. 이동 7 + 19 + 8 + 66 + 58 + 30 + 20 = 208.
C3 C-SCAN이 하는 일을 쉬운 말 한 문장으로 쓰라.
답: 헤드가 한 방향으로만 가며 요청을 처리하고, 끝에 닿으면 처리 없이 반대쪽 끝으로 돌아가 다시 같은 방향으로 처리한다.
C4 트랙 양쪽 끝에 요청이 몰리는 시스템에서 SCAN과 C-SCAN 중 대기 시간이 더 고른 것은? 이유는?
답: C-SCAN. SCAN은 방금 지나간 쪽 끝의 요청이 왕복을 다 기다려야 해서, 가운데 요청보다 대기 시간이 두 배쯤 길 수 있다. C-SCAN은 모든 요청이 같은 방향의 한 바퀴를 기다리므로 대기 시간이 고르다.
C5 평균 탐색 4 ms, 15,000 rpm, 트랙당 500섹터(섹터 512바이트)인 디스크에서 무작위로 흩어진 섹터 1,000개를 읽는 시간은?
답: 섹터마다 탐색 4 + 회전 지연 2 + 전송 4/500 = 0.008 → 6.008 ms. 1,000개면 6,008 ms, 약 6초.
C6 같은 실린더에 있는 섹터들을 이어서 읽으면 왜 빠른가? 조각난 파일은 왜 느린가?
답: 실린더는 머리를 한 자리에 둔 채 읽을 수 있는 트랙의 묶음이라, 그 안에서는 팔을 옮기지 않아 탐색 시간이 들지 않는다. 조각난 파일은 섹터가 떨어진 트랙에 흩어져 있어서 조각마다 팔을 옮겨야 하고, 그때마다 탐색 시간이 든다.
이유: 접근 시간에서 가장 큰 것이 탐색 시간이다. 탐색 횟수가 읽기 시간을 좌우한다.
-
53_disk-scheduling_plot.py로 그렸고, 네 정책의 처리 순서와 이동 합 498, 248, 250, 322를 같은 코드로 확인했다. ↩
-
Stallings, Operating Systems: Internals and Design Principles 6판, 표 11.3(디스크 스케줄링 정책 비교). ↩