SPN, SRT, HRRN은 각 프로세스가 프로세서를 얼마나 쓸지 알아야 한다. 미리 알 수 없으니, 같은 프로세스가 지난번들에 프로세서를 쓴 시간(버스트)으로 다음 버스트를 짐작한다. 일기 예보가 최근 날씨에 더 무게를 두듯, 최근 값에 더 큰 무게를 주는 지수 평균이 흔히 쓰인다. 무게 α를 크게 하면 변화에 빨리 따라가지만, 한 번 튄 값에도 크게 흔들린다.
예시로 보기
어떤 프로세스의 버스트가 6, 4, 6, 4, 13, 13, 13으로 나왔다. 처음 예측값 \(S_1 = 10\), \(\alpha = 0.5\)로 지수 평균을 내면 다음과 같다1.
| \(n\) | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 실제 \(T_n\) | 6 | 4 | 6 | 4 | 13 | 13 | 13 | |
| 예측 \(S_n\) | 10 | 8 | 6 | 6 | 5 | 9 | 11 | 12 |
예: \(S_2 = 0.5 \times 6 + 0.5 \times 10 = 8\). 실제가 4~6을 오가다 13으로 뛰자, 예측은 5 → 9 → 11 → 12로 몇 번에 걸쳐 따라간다.
정확히 말하면
\(T_i\)를 이 프로세스의 \(i\)번째 실제 실행 시간, \(S_i\)를 \(i\)번째의 예측값이라 하자. \(S_1\)은 계산하지 않고 정해 준다.
단순 평균. 지금까지의 실제 값을 똑같은 무게로 평균 낸다.
\[S_{n+1} = \frac{1}{n} \sum_{i=1}^{n} T_i\]매번 다 더하지 않도록, 앞 예측값을 이용해 다음처럼 쓸 수 있다.
\[S_{n+1} = \frac{1}{n} T_n + \frac{n - 1}{n} S_n\]지수 평균. 과거 값의 시계열로 미래 값을 예측하는 흔한 방법이다. 이번 실제 값과 지난 예측값을 \(\alpha : (1 - \alpha)\)로 섞는다.
\[S_{n+1} = \alpha T_n + (1 - \alpha) S_n \qquad (0 < \alpha < 1)\]식을 풀어 쓰면 \(S_{n+1} = \alpha T_n + (1-\alpha)\alpha T_{n-1} + (1-\alpha)^2 \alpha T_{n-2} + \cdots\)이다. 오래된 관측일수록 무게가 \((1 - \alpha)\)배씩 줄어든다. \(\alpha = 0.8\)이면 가장 최근 값에 0.8, 그 앞에 0.16, 그 앞에 0.032를 준다. 금방 옛날 값을 잊는다.
| \(\alpha\) | 성질 |
|---|---|
| 크다 (예: 0.8) | 최근 변화에 빨리 반응한다. 한 번 튄 값에 크게 흔들린다 |
| 작다 (예: 0.2) | 오래된 값까지 고루 반영해 안정적이다. 실제 행동이 바뀌어도 늦게 따라간다 |
실제 값이 갑자기 오르거나 내리면, 단순 평균보다 지수 평균이, 그리고 α가 클수록 빨리 따라간다.
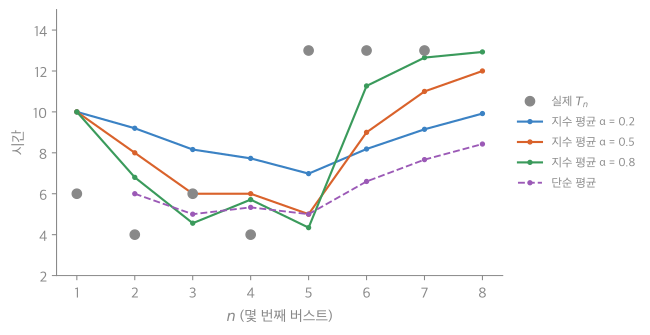
예시의 버스트로 그렸다. 실제 값이 13으로 뛴 뒤 α = 0.8 선은 두 번 만에 12.6까지 올라가고, α = 0.2 선과 단순 평균은 8번째 예측에서도 10 아래에 머문다. 반대로 4와 6을 오갈 때는 α = 0.8 선이 실제 값을 따라 출렁이고, α = 0.2 선은 천천히 내려오기만 한다2.
활용
연결
- 선수: 스케줄링 알고리즘
확인 문제
C1 지수 평균 식을 쓰고, α와 각 항의 뜻을 말로 설명하라.
답: \(S_{n+1} = \alpha T_n + (1 - \alpha) S_n\). 다음 예측은 이번 실제 실행 시간 \(T_n\)에 무게 α를, 지난번 예측 \(S_n\)에 무게 \(1 - \alpha\)를 주어 섞은 값이다. α가 클수록 최근 실제 값을 더 믿는다.
C2 α = 0.5, S₁ = 10이다. 실제 버스트가 2, 2, 2로 나오면 S₂, S₃, S₄는?
답: \(S_2 = 0.5 \times 2 + 0.5 \times 10 = 6\), \(S_3 = 0.5 \times 2 + 0.5 \times 6 = 4\), \(S_4 = 0.5 \times 2 + 0.5 \times 4 = 3\).
흔한 오답: \(S_2 = 2\). 지난 예측 10의 몫을 빠뜨린 것이다.
C3 단순 평균보다 지수 평균이 스케줄링에 더 맞는 이유는?
답: 프로세스의 행동은 실행 중에 바뀐다(예: 계산 단계에서 입출력 단계로). 단순 평균은 모든 과거 값에 같은 무게를 주어, 실행이 길어질수록 새 행동을 거의 반영하지 못한다. 지수 평균은 최근 값에 무게를 더 주어 바뀐 행동을 빨리 따라간다.
-
버스트 6, 4, 6, 4, 13, 13, 13 예는 Silberschatz, Operating System Concepts 6장의 예제 수치다. ↩ ↩2
-
45_burst-prediction_plot.py로 그렸고, α = 0.5의 예측값 10, 8, 6, 6, 5, 9, 11, 12와 8번째 예측의 순서(α = 0.8 > α = 0.5 > α = 0.2 > 단순 평균 59/7)을 같은 코드로 확인했다. ↩