전통 UNIX는 프로세서를 최근에 많이 쓴 프로세스의 우선순위를 낮추고, 시간이 지나면 그 기록을 반씩 잊어 다시 올려 준다. 그래서 대화형 프로그램은 빨리 응답받고, 계산만 하는 배경 작업도 굶지 않는다. 공정 분배는 여기에 “사용자나 그룹 단위로도 공평하게”를 더한다. 프로세스를 많이 띄운 쪽이 프로세서를 독차지하지 못하게 한다. 대신 우선순위를 매초 다시 계산하는 부담이 있다.
예시로 보기
프로세스 A, B, C가 모두 계산만 하고, 기본 우선순위가 60이다. 우선순위 값이 작을수록 먼저 실행된다. 실행 중인 프로세스는 1초에 60번 시계 인터럽트를 받을 때마다 CPU 카운트가 1씩 늘어난다. 매초 끝에 모든 프로세스의 CPU 카운트를 반으로 줄이고 우선순위를 다시 계산한다.
| 시각 | A 우선순위 | B 우선순위 | C 우선순위 | 다음 1초 실행 |
|---|---|---|---|---|
| 0 | 60 | 60 | 60 | A |
| 1 | 75 | 60 | 60 | B |
| 2 | 67 | 75 | 60 | C |
| 3 | 63 | 67 | 75 | A |
| 4 | 76 | 63 | 67 | B |
| 5 | 68 | 76 | 63 | C |
예: 시각 1에 A의 CPU 카운트 60을 반으로 줄이면 30, 우선순위는 \(60 + 30/2 = 75\)다. 시각 2에는 30이 15가 되어 \(60 + 7 = 67\)이다. 세 프로세스가 돌아가며 실행된다.
정확히 말하면
전통 UNIX 스케줄링
SVR3와 4.3 BSD UNIX가 쓰던 방식이다. 대화형 시분할 환경을 위한 것이다. 대화형 사용자에게 좋은 응답 시간을 주면서, 우선순위가 낮은 배경 작업이 굶지 않게 한다. 현대 UNIX에서는 바뀌었지만 실용적인 시분할 스케줄링의 대표다.
- 우선순위 큐마다 라운드 로빈을 쓰는 다단계 피드백이다.
- 실행 중인 프로세스가 1초 안에 막히거나 끝나지 않으면 선점한다.
- 우선순위는 프로세스 종류와 실행 기록으로 정한다.
우선순위 식
\[CPU_j(i) = \frac{CPU_j(i-1)}{2}, \qquad P_j(i) = Base_j + \frac{CPU_j(i)}{2} + nice_j\]| 기호 | 뜻 |
|---|---|
| \(CPU_j(i)\) | 구간 \(i\)까지 프로세스 \(j\)가 프로세서를 쓴 정도 |
| \(P_j(i)\) | 구간 \(i\)가 시작될 때 프로세스 \(j\)의 우선순위. 값이 작을수록 높다 |
| \(Base_j\) | 프로세스 \(j\)의 기본 우선순위 |
| \(nice_j\) | 사용자가 조절하는 값 |
말로 읽으면, 프로세서를 많이 쓴 만큼 우선순위 값이 커지고(낮아지고), 그 기록은 매초 반으로 줄어 잊힌다.
대역. 기본 우선순위는 모든 프로세스를 고정된 대역으로 나눈다. CPU와 nice 항은 프로세스가 자기 대역 밖으로 나가지 못하게 제한된다. 대역은 높은 것부터 스와퍼, 블록 입출력 장치 제어, 파일 조작, 문자 입출력 장치 제어, 사용자 프로세스다. 디스크 같은 블록 장치 접근을 최적화하고 시스템 호출에 빨리 응답하기 위해서다.
공정 분배 스케줄링
사용자의 응용 하나는 프로세스(스레드) 여러 개로 돈다. 사용자에게 중요한 것은 개별 프로세스가 아니라 응용 전체의 성능이다. 그래서 프로세스 묶음(그룹) 단위로 스케줄링을 정한다.
\[P_j(i) = Base_j + \frac{CPU_j(i)}{2} + \frac{GCPU_k(i)}{4 \times W_k}\]\(GCPU_k(i)\)는 프로세스 \(j\)가 속한 그룹 \(k\)의 프로세서 사용량이고(매초 반으로 줄인다), \(W_k\)는 그룹 \(k\)의 몫(가중치, \(0 < W_k \le 1\), 합 1)이다. 같은 그룹의 프로세스가 프로세서를 쓰면 그룹 전체의 우선순위가 함께 낮아진다.
그림 9.16의 예: A는 그룹 1, B와 C는 그룹 2이고 몫은 각각 0.5다. 기본 우선순위는 60이고, 나눗셈은 항마다 소수점을 버린다.
| 시각 | A | B | C | 다음 1초 실행 |
|---|---|---|---|---|
| 0 | 60 | 60 | 60 | A |
| 1 | 90 | 60 | 60 | B |
| 2 | 74 | 90 | 75 | A |
| 3 | 96 | 74 | 67 | C |
| 4 | 78 | 81 | 93 | A |
| 5 | 98 | 70 | 76 |
예: 시각 1에 A는 CPU 30, 그룹 CPU 30이므로 \(60 + 15 + 30/(4 \times 0.5) = 90\)이다. 실행 순서가 A, B, A, C, A로, A가 시간의 절반, B와 C가 나머지 절반을 나눠 쓴다. 그룹 두 개가 몫 0.5씩을 받는 셈이다.
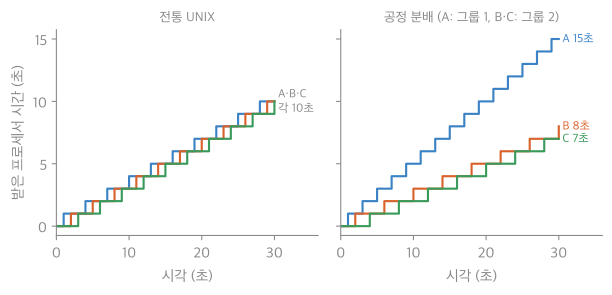
같은 규칙을 30초까지 계속 돌린 누적 실행 시간이다. 전통 UNIX에서는 셋이 10초씩 똑같이 나눈다. 공정 분배에서는 그룹 1의 A 혼자 15초를, 그룹 2의 B와 C가 합쳐 15초를 받는다. 프로세스 수가 아니라 그룹 수로 프로세서가 나뉜다1.
활용
- 리눅스의
nice명령이 위 식의 \(nice_j\)를 바꾼다.nice -n 10 명령으로 실행하면 우선순위 값이 커져(낮아져) 다른 작업에 양보한다. - 공정 분배는 여러 사용자가 한 서버를 함께 쓸 때, 프로세스를 많이 띄운 사용자가 서버를 독차지하지 못하게 한다.
연결
- 선수: 스케줄링 알고리즘 (다단계 피드백, 라운드 로빈)
- 우선순위와 에이징: 스케줄링의 종류와 기준
확인 문제
C1 전통 UNIX에서 기본 우선순위 60, nice 0인 프로세스가 직전 1초 동안 계속 실행되어 CPU 카운트가 80이 되었다(그 전 기록 포함). 1초가 끝날 때 새 우선순위는?
답: CPU를 반으로 줄여 40, 우선순위 \(60 + 40/2 = 80\).
C2 CPU 카운트를 매초 반으로 줄이는 이유는? 줄이지 않으면 어떻게 되는가?
답: 오래전의 사용 기록을 점점 잊게 하려는 것이다. 줄이지 않으면 오래 실행된 프로세스의 우선순위 값이 계속 커져, 지금은 거의 안 쓰더라도 영원히 뒤로 밀린다. 반으로 줄이면 최근에 많이 쓴 프로세스만 일시적으로 밀리고, 쉬면 다시 올라온다.
C3 사용자 X는 프로세스 1개, 사용자 Y는 프로세스 9개를 계속 돌린다. 전통 UNIX와 공정 분배(사용자마다 몫 0.5)에서 X가 받는 프로세서 비율은 대략 얼마인가?
답: 전통 UNIX: 프로세스마다 공평하므로 X는 약 1/10. 공정 분배: 그룹마다 공평하므로 X는 약 1/2.
-
46_fair-share-unix-scheduling_plot.py로 그렸고, 처음 5초의 실행 순서가 위 두 표와 같다는 것, 30초 동안 받은 시간 10·10·10초와 15·8·7초를 같은 코드로 확인했다. ↩