여행 가기 전에 “차로 몇 시간 걸리지?”를 먼저 따져 보는 것과 같다. 문제에는 “입력이 최대 얼마까지 온다”는 제한이 적혀 있다. 코드를 짜기 전에 내 방법이 계산을 몇 번쯤 하는지 세어 보면, 시간 안에 끝날지 짜기 전에 알 수 있다. 다만 이 셈은 자릿수만 맞추는 어림이다. 경계에 걸리면 실제로 돌려서 재 봐야 한다.
예시로 보기
마라톤 참가자 명단과 완주자 명단에서 완주하지 못한 한 명을 찾는 문제가 있다. 참가자는 최대 10만 명이다. 방법 세 가지의 계산 횟수를 세어 본다.
| 방법 | 하는 일 | 계산 횟수 (n = 10만) | 파이썬에서 대략 |
|---|---|---|---|
| A. 하나씩 대조 | 참가자마다 완주자 명단을 처음부터 훑는다 | 10만 × 10만 = 100억 | 수 분 이상. 안 된다 |
| B. 정렬해서 나란히 | 두 명단을 정렬하고 앞에서부터 비교한다 | 정렬 약 10만 × 17 + 비교 10만 ≈ 200만 | 0.1초 안쪽 |
| C. 이름별로 세기 | 이름마다 몇 명인지 표에 적고, 완주자만큼 뺀다 | 약 20만 | 0.05초 안쪽 |
같은 문제인데 A와 C는 5만 배 차이가 난다. 입력의 크기가 방법을 정한다. 여기서 n은 입력의 크기(참가자 수)이고, “10만 × 17”의 17은 10만을 몇 번 반으로 나눠야 1이 되는지(\(\log_2 10^5 \approx 17\))다.
1초에 몇 번 계산하나
이 컴퓨터(Apple M3, Python 3.14)에서 재 보니 s += i 같은 단순 반복은 1초에 약 7천만 번 돌았다. 실제 풀이는 한 바퀴에 비교, 표 찾기, 리스트 넣기를 함께 하므로 이보다 몇 배 느리다. 그래서 파이썬은 1초에 대략 천만 번으로 잡고 센다. 채점 서버의 컴퓨터와 파이썬 버전은 이것과 다르므로 두세 배의 여유를 둔다.
C++ 기준 교재는 “요즘 컴퓨터는 1초에 수억 번”을 출발점으로 삼고 아래 왼쪽 두 칸 같은 표를 준다1. 파이썬은 그보다 느리니 오른쪽 칸처럼 한 단계 낮춰 잡는다.
| n의 최대 (C++ 교재) | 쓸 수 있는 복잡도 | 파이썬에서 편한 n | 대표 방법 |
|---|---|---|---|
| 10 | \(O(n!)\) | 8~9 | 모든 순서 나열 |
| 20 | \(O(2^n)\) | 18~20 | 모든 부분집합 |
| 500 | \(O(n^3)\) | 100~200 | 삼중 반복, 플로이드–워셜 |
| 5,000 | \(O(n^2)\) | 2,000~3,000 | 모든 쌍 비교 |
| \(10^6\) | \(O(n \log n)\), \(O(n)\) | \(10^5\)~\(10^6\) | 정렬, 한 번 훑기, 해시 |
| 그보다 큼 | \(O(\log n)\), \(O(1)\) | \(10^9\) 이상 | 이분 탐색, 공식 |
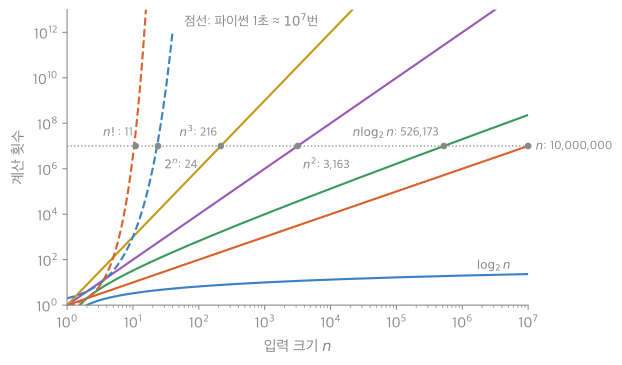
가로축과 세로축 모두 10배마다 한 칸인 눈금이다. 점선(1초에 천만 번)과 곡선이 만나는 점이 그 방법이 1초를 넘기 시작하는 n이다. \(n^2\)은 3천 남짓, \(2^n\)은 24, \(n!\)은 11에서 넘친다. 위 표의 오른쪽 칸은 이 값보다 조금 작게 잡은 것이다2.
in과 집합 in의 속도 차이(약 1,000배), 실수 100만 개 정렬(약 0.12초), 이중 반복에서 n을 두 배로 늘리면 시간이 약 네 배(로그-로그 기울기 2.16)를 실험으로 확인했다. 컴퓨터마다 값은 다르다 — 02_complexity-budget_bench.py. 문서와 예제 사다리의 계산은 02_complexity-budget_verify.py에서 확인했다.세는 법
빅오(Big-O)는 “입력이 커질 때 계산 횟수가 어떤 빠르기로 늘어나는가”를 나타내는 표기다. 정확한 뜻은 점근 표기에 있다. 여기서는 세는 요령만 쓴다.
- 겹친 반복은 곱한다.
for안에for가 있으면 바깥 횟수 × 안쪽 횟수다. - 나란한 반복은 더하고, 큰 쪽만 남긴다. n번 반복 뒤에 n²번 반복이 오면 n² + n이고, n이 크면 n²만 중요하다.
- 한 줄 안에 숨은 반복을 센다. 아래 표의 “O(n)” 줄은 한 줄이지만 속에서 리스트를 끝까지 돈다3.
- 제한의 최댓값을 넣는다. “n ≤ 10만”이면 n = 10만을 넣어 횟수를 구한다.
- 천만으로 나눈다. 결과가 1억을 넘으면 거의 안 되고, 수백만이면 넉넉하다.
| 파이썬 코드 | 비용 |
|---|---|
a[i], a.append(x), a.pop(), len(a) |
\(O(1)\) (append는 평균) |
x in 리스트, a.index(x), a.count(x), a.remove(x), a.insert(0, x), a.pop(0), min(a), max(a), sum(a) |
\(O(n)\) |
a[i:j] (잘라 복사하기) |
\(O(j - i)\) |
sorted(a), a.sort() |
\(O(n \log n)\) |
딕셔너리·집합에 넣기, 찾기(in), 지우기 |
평균 \(O(1)\) |
표의 두 ‘평균’은 뜻이 다르다. append의 평균은 n번 넣은 총비용을 n으로 나눈 값이라 입력과 상관없이 늘 맞는다. 꽉 찰 때 용량을 일정한 비율로 키우면 옮겨 담는 횟수의 합이 등비급수로 묶이기 때문이다. 딕셔너리·집합의 평균은 해시값이 고르게 흩어진다고 볼 때의 기댓값이다. 그래서 키가 한 칸에 몰리는 나쁜 입력에서는 한 번에 \(O(n)\)까지 걸릴 수 있다(해싱과 무작위 알고리즘의 확률).
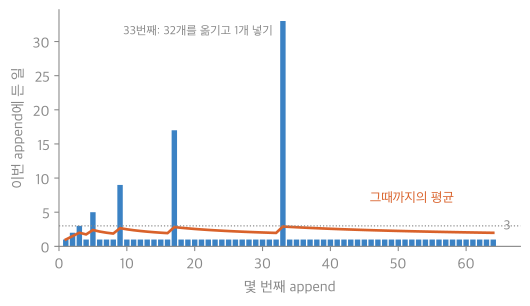
용량을 1에서 시작해 꽉 찰 때마다 두 배로 늘리는 배열이다. 막대가 가끔 높이 솟는 때가 옮겨 담는 순간이다. 33번째에는 32개를 옮기고 1개를 넣는다. 그래도 그때까지의 평균(주황 선)은 3을 넘지 않는다2.
스스로 설명해 보기
아래 코드는 예시의 방법 A를 파이썬으로 쓴 것이다. 줄마다 비용이 어디서 나오는지 먼저 답해 본다.
def solution(participant, completion):
    for p in participant:            # (1)
        if p in completion:          # (2)
            completion.remove(p)     # (3)
        else:
            return p
1. (1)은 몇 번 도는가?
참가자 수 n번이다. 끝까지 가기 전에 return할 수도 있지만, 제한을 셀 때는 가장 오래 걸리는 경우를 본다.
2. (2)는 한 줄인데 왜 한 번에 끝나지 않는가?
completion이 리스트라서 in은 앞에서부터 하나씩 같은지 본다. 최대 n − 1번 비교한다. (3)의 remove도 지울 것을 찾으며 같은 만큼 훑는다.
3. 전체 비용은?
(1)의 n번 × ((2)의 n + (3)의 n) ≈ 2n²이다. n = 10만이면 200억 번이라 시간 안에 끝나지 않는다.
이 어림의 핵심 아이디어는?
한 줄짜리 연산도 속에서 몇 번 일하는지 보고, 겹친 반복은 곱한다.
같은 방법을 쓸 수 있는 다른 상황은?
반복 안에서 a.index(x), a.count(x), a.pop(0), sum(a), a[i:]를 부르는 모든 코드다. 이것들도 한 줄짜리 O(n)이라 반복 안에 두면 O(n²)이 된다.
예제
“길이 n ≤ 200,000인 배열에서, 앞에 나온 적 있는 수가 몇 번 다시 나오는지 센다.”
- 제한 읽기: n은 최대 20만이다.
- 단순한 방법 세기: 원소마다 앞부분을 다 훑으면 1 + 2 + … + n ≈ n²/2 = 200억 번이다. 안 된다.
- 더 나은 방법 세기: 본 수를 집합에 넣어 가며
in으로 확인하면 n번 × O(1) = 20만 번이다. 된다. - 경계 확인: n = 1이면 다시 나오는 수가 없으니 0이다. 모두 같은 수면 n − 1이다.
더 많은 연습은 시간 복잡도 어림 예제 사다리에 있다.
활용
- 모든 풀이 문서의 2단계(“가장 단순한 방법과 그 비용”)가 이 어림이다.
- 문제를 읽고 제한부터 보면 풀이 방향이 좁혀진다. n ≤ 20이면 “다 해 봐도 된다”는 힌트고, n ≤ 10만이면 “n²은 안 된다”는 힌트다.
- 프로그래머스 Level 2 이상의 “효율성 테스트”는 느린 방법을 떨어뜨리려고 만든 큰 입력이다.
연결
- 선수: 파이썬 기본 문법, 점근 표기
- 이어지는 개념: 딕셔너리와 집합(O(n)을 O(1)로), 정렬과 정렬 기준(O(n log n))
- “겹친 반복은 곱하고, 나란한 반복은 더한다”는 셈의 기본 법칙의 곱의 법칙과 합의 법칙이다. 곱하려면 안쪽 횟수가 바깥 변수와 상관없이 같아야 한다. 안쪽 횟수가 바깥 변수에 따라 바뀌면 바깥 값마다 나눠 더한다.
- 제한표에서 \(n^3\), \(n^2\) 칸의 n은 수백·수천인데 \(2^n\) 칸은 20뿐인 까닭은 거듭제곱함수와 지수함수 비교에 있다. \(2^n\) 방법은 n이 1 늘 때마다 일이 두 배라서, 1000배 빠른 컴퓨터로도 n이 10쯤만 늘어난다. \(2^{20} \approx\) 100만, \(2^{40} \approx\) 1조 같은 어림은 \(2^{10} = 1024 \approx 10^3\)을 거듭제곱과 지수법칙으로 넓힌 것이다. 예를 들어 \(2^{40} = (2^{10})^4 \approx 10^{12}\)이다.
- 입력을 두 배로 늘렸을 때 시간이 r배가 되면, 시간은 대략 \(n^k\)(\(k = \log_2 r\))에 비례한다. 네 배면 \(n^2\), 여덟 배면 \(n^3\)이다. 위 검증의 로그-로그 기울기 2.16이 이 k를 잰 값이고, 그래프로 읽는 법은 로그함수와 로그 스케일에 있다.
- 예제에서 원소마다 앞부분을 훑는 횟수를 정확히 세면 0 + 1 + ⋯ + (n − 1) = n(n − 1)/2번이다. 이런 합을 닫힌 꼴로 바꾸는 법은 수열과 합의 기호에 있다. 이 수는 n개에서 둘을 고르는 쌍의 수 \(\binom{n}{2}\)(\(\binom{\ }{\ }\)은 위의 수만큼 있는 것에서 아래의 수만큼 고르는 경우의 수)와 같다. 쌍의 수와 모든 순서의 수 n!은 순열과 조합에서 센다.
- 제한표 맨 아래 줄에서 n이 \(10^9\)을 넘어도 \(O(\log n)\)이면 되는 것은 \(\log_2 10^9 \approx 30\)이라서다. 이런 로그 값을 어림하는 법은 로그에 있다.
자주 하는 오해
틀렸다. if p in completion:은 한 줄이지만 completion이 리스트면 속에서 끝까지 훑는 반복이다. 줄 수로 속도를 재면 그럴듯해 보이는데, 파이썬의 짧은 문법 뒤에 반복이 숨어 있기 때문이다. 실제 비용은 그 연산이 속에서 몇 번 일하는지로 센다. 확인하려면 입력을 두 배로 늘려 시간이 두 배(O(n))인지 네 배(O(n²))인지 재 보면 된다. 측정 코드에서 리스트 in은 집합 in보다 약 1,000배 느렸다.
과목별 관점
자료구조 (1-2학기). 자료구조에서는 같은 어림을 기계의 명령 수로 한다. 1초에 명령 \(10^9\)개를 실행하는 기계에서 방법마다 걸리는 시간이다.
| \(n\) | \(n\) | \(n \log_2 n\) | \(n^2\) | \(n^3\) |
|---|---|---|---|---|
| 1,000 | 1마이크로초 | 10마이크로초 | 1밀리초 | 1초 |
| 10,000 | 10마이크로초 | 130마이크로초 | 100밀리초 | 17분 |
| \(10^6\) | 1밀리초 | 20밀리초 | 17분 | 32년 |
값이 백만 개일 때 \(n \log_2 n\) 방법은 0.02초에 끝나고, \(n^2\) 방법은 17분, \(n^3\) 방법은 32년이 걸린다. 이 문서는 파이썬에 맞춰 1초에 천만 번으로 잡았다. 위 표의 기계는 그보다 100배 빠른데도 \(n^2\) 방법이 백만 개 앞에서 못 쓰게 되는 것은 같다4.
그래서 기계를 빠르게 바꾸는 것보다 방법을 고치는 쪽이 쓸모 있다. \(2^n\) 방법을 \(n^3\) 방법으로 바꾸는 것이 그런 예다. 횟수를 자릿수로 어림하지 않고 줄 단위로 정확히 세는 법은 연산 횟수와 단계 수 세기에 있다.
확인 문제
C1 제한이 n ≤ 200,000인 문제에서 모든 쌍 (i, j)를 확인하는 이중 반복을 쓰려 한다. 시간 안에 될까?
답: 안 된다. 쌍의 수는 약 n²/2 = 2 × 10¹⁰이다. 1초에 천만 번으로 잡으면 2,000초가 걸린다. O(n log n)이나 O(n) 방법을 찾아야 한다.
C2 반복문 안에서 x in 리스트를 쓰면 왜 전체가 O(n²)이 되는가? 무엇으로 바꾸면 O(n)이 되는가?
답: 리스트의 in은 앞에서부터 하나씩 비교하는 O(n) 연산이다. 이것을 n번 부르면 n × n이다. 리스트를 집합(set)이나 딕셔너리로 바꾸면 in이 평균 O(1)이라 전체가 O(n)이 된다.
C3 사람 n명 중 몇 명을 뽑는 모든 경우를 다 확인하려 한다. n ≤ 20과 n ≤ 40 중 어느 쪽에서 쓸 수 있는가?
답: n ≤ 20이다. 뽑는 경우는 2ⁿ가지다. 2²⁰ ≈ 100만은 되지만 2⁴⁰ ≈ 1조는 안 된다.
흔한 오답: “40도 작은 수니까 된다.” n이 작아 보여도 지수로 늘어나는 방법에서는 20과 40이 100만 배 차이다.
C4 “정렬한 뒤 한 번 훑는” 풀이의 비용을 O(n log n)이라고 하는 근거는?
답: 정렬이 O(n log n), 훑기가 O(n)이고 둘은 나란히 이어진다. 나란한 비용은 더한 뒤 큰 쪽만 남기므로 O(n log n) + O(n) = O(n log n)이다.
-
Laaksonen, Competitive Programmer’s Handbook (2018년 7월판), 2.3 “Estimating efficiency”. 요즘 컴퓨터가 1초에 수억 번 계산한다는 것을 출발점으로 삼고, 1초 제한에서 n ≤ 10 → O(n!), n ≤ 20 → O(2ⁿ), n ≤ 500 → O(n³), n ≤ 5000 → O(n²), n ≤ 10⁶ → O(n log n) 또는 O(n), n이 더 크면 O(1) 또는 O(log n)이라는 표를 준다. 표의 “파이썬에서 편한 n” 칸은 이 교재가 C++ 기준이라는 점과 위 측정값을 바탕으로 한 어림이다. ↩
-
02_complexity-budget_plot.py로 그렸고, 1초 예산 \(10^7\)번을 넘기 시작하는 n(\(n^2\): 3,163, \(n^3\): 216, \(2^n\): 24, \(n!\): 11, \(n\log_2 n\): 약 52만)과, 두 배로 늘리는 배열에 10만 번 넣는 동안 그때까지의 평균 비용이 늘 3 미만임을 같은 코드로 확인했다. ↩ ↩2
-
Python Wiki, “TimeComplexity” (wiki.python.org/moin/TimeComplexity). list의
x in s,insert,pop(0),remove,min/max는 O(n), slice는 O(k), sort는 O(n log n), dict·set의 get/set/delete와in은 평균 O(1)이다. ↩ -
표의 값은 02_operation-step-count_verify.py로 다시 계산했다. ↩