알고 싶은 값을 한가운데 두고 정해 둔 크기의 창을 대어, 그 창 안에 든 자료가 몇 개인지 세는 방법이다. 창이 물어보는 값을 따라 움직이니 미리 잘라 둔 칸의 경계에 걸릴 일이 없다. 대신 창의 크기는 사람이 정해야 한다. 너무 크면 봉우리와 골짜기가 뭉개져 어디나 비슷해 보이고, 너무 작으면 자료가 있는 자리에만 뾰족한 기둥이 서고 나머지는 0이 된다.
예시로 보기
히스토그램은 칸을 미리 잘라 둬서, 경계 바로 옆의 7.9와 8.1이 전혀 다른 값을 받았다. 칸을 미리 자르지 않고, 물어보는 값마다 그 값을 가운데 둔 칸을 새로 잡으면 경계가 없어진다.
같은 머리카락 길이 10개(cm)를 쓴다1.
\[3,\ 4,\ 5,\ 5,\ 6,\ 7,\ 12,\ 13,\ 14,\ 20\]5.2가 얼마나 흔한 값인지 폭 4인 창으로 잰다.
- 창을 댄다. 5.2에서 양쪽으로 2씩이니 3.2부터 7.2까지다.
- 창 안의 표본을 센다. 4, 5, 5, 6, 7로 5개다. 3은 3.2보다 작아 빠진다.
- 비율을 창 폭으로 나눈다. \(\frac{5/10}{4} = 0.125\).
창 폭만 바꿔 같은 일을 되풀이한다.
| 창 폭 | 5.2의 창 | 든 개수 | 5.2의 값 | 9.6의 창 | 든 개수 | 9.6의 값 |
|---|---|---|---|---|---|---|
| 1 | 4.7 ~ 5.7 | 2 | 0.2 | 9.1 ~ 10.1 | 0 | 0 |
| 4 | 3.2 ~ 7.2 | 5 | 0.125 | 7.6 ~ 11.6 | 0 | 0 |
| 10 | 0.2 ~ 10.2 | 6 | 0.06 | 4.6 ~ 14.6 | 7 | 0.07 |
폭 10에서는 표본이 하나도 없는 9.6이 표본이 몰린 5.2보다 높은 값을 받는다. 창이 양쪽 무리를 한꺼번에 덮기 때문이다.
경계 문제는 풀린다. 폭 4에서 7.9는 0.05, 8.1은 0.025다. 히스토그램에서는 0.125와 0이었다.
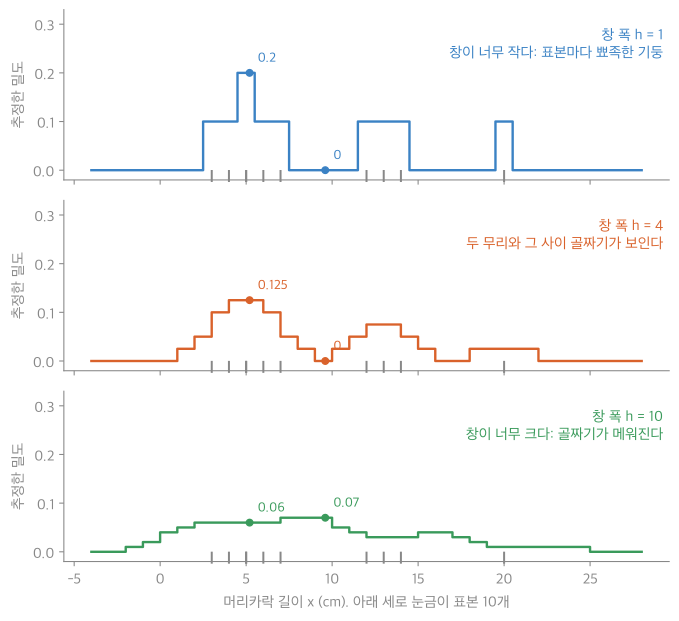
같은 표본 10개에 창 폭만 바꿔 모든 \(x\)에서 값을 구해 이었다. 폭 1은 표본 자리에만 기둥이 서고, 폭 4는 봉우리 둘과 그 사이 골짜기가 보이며, 폭 10은 골짜기가 메워져 9.6이 5.2보다 높아진다. 점은 표의 여섯 값이다2.
정의
파젠 창은 물어보는 값 \(\mathbf{x}\)를 가운데 둔 구역 \(R_n\)을 먼저 정하고, 그 안에 든 표본 수를 세는 방법이다. 밀도는 구역의 크기 \(V_n\), 그 안에 든 표본 수 \(k_n\), 전체 표본 수 \(n\)으로 구한다. 아래첨자 \(n\)은 “표본을 \(n\)개 쓸 때의 값”이라는 표시다3.
구역. 잰 값이 \(d\)가지면 \(\mathbf{x}\)는 숫자 \(d\)개짜리 목록이고, 구역 \(R_n\)은 한 변의 길이가 \(h_n\)인 \(d\)차원 정육면체다(다차원 정면체라고도 부른다). 값이 하나면 길이 \(h_n\)인 구간, 둘이면 한 변이 \(h_n\)인 정사각형이다. 크기는 변의 길이를 \(d\)번 곱한 것이다.
\[V_n = h_n^d\]창 함수. “원점을 가운데 둔, 한 변이 1인 정육면체 안에 있는가”를 1과 0으로 답하는 함수 \(\varphi\)(파이)를 둔다.
\[\varphi(\mathbf{u}) = \begin{cases} 1 & \vert u_j\vert \le \frac{1}{2}\ \ (j = 1, \dots, d) \\ 0 & \text{그 밖} \end{cases}\]\(u_j\)는 목록 \(\mathbf{u}\)의 \(j\)번째 숫자다. 모든 좌표가 원점에서 \(\frac12\) 안쪽이어야 1이다.
여기에 \(\frac{\mathbf{x} - \mathbf{x}_i}{h_n}\)을 넣는다. 이 값은 표본 \(\mathbf{x}_i\)가 \(\mathbf{x}\)에서 “창 변의 몇 배만큼” 떨어져 있는가다. 그래서 \(\varphi\!\left(\frac{\mathbf{x} - \mathbf{x}_i}{h_n}\right)\)은 표본 \(\mathbf{x}_i\)가 \(\mathbf{x}\)를 가운데 둔 한 변 \(h_n\)짜리 창 안에 있으면 1, 아니면 0이다. 위 예시에서 \(x = 5.2\), \(x_i = 4\), \(h = 4\)면 \(\frac{5.2 - 4}{4} = 0.3 \le \frac12\)이라 1이고, \(x_i = 3\)이면 \(0.55\)라 0이다.
추정식. 창 안에 든 표본 수는 모든 표본의 \(\varphi\) 값을 더한 것이고, 밀도는 히스토그램 밀도 추정의 식 그대로 “든 비율 ÷ 크기”다.
\[k_n = \sum_{i=1}^{n} \varphi\!\left(\frac{\mathbf{x} - \mathbf{x}_i}{h_n}\right), \qquad p_n(\mathbf{x}) = \frac{k_n / n}{V_n} = \frac{1}{n}\sum_{i=1}^{n} \frac{1}{V_n}\,\varphi\!\left(\frac{\mathbf{x} - \mathbf{x}_i}{h_n}\right)\]\(\sum_{i=1}^{n}\)은 \(i\)를 1부터 \(n\)까지 바꿔 가며 모두 더한다는 기호다.
같은 식을 거꾸로 읽기. 표본 하나가 맡는 몫을 \(\delta_n(\mathbf{x}) = \frac{1}{V_n}\varphi\!\left(\frac{\mathbf{x}}{h_n}\right)\)로 묶으면 식이 짧아진다(\(\delta\)는 델타).
\[p_n(\mathbf{x}) = \frac{1}{n}\sum_{i=1}^{n} \delta_n(\mathbf{x} - \mathbf{x}_i)\]\(\delta_n(\mathbf{x} - \mathbf{x}_i)\)는 표본 \(\mathbf{x}_i\) 위에 놓인, 폭 \(h_n\)에 높이 \(\frac{1}{V_n}\)인 상자다. 그러니 이 식은 “표본마다 상자를 하나씩 올려놓고 그 높이를 평균 낸다”로 읽힌다. 앞의 읽기는 물어보는 값에 창을 대고 표본을 세는 것이고, 이 읽기는 표본마다 상자를 놓고 물어보는 값 위에 쌓인 높이를 재는 것이다. 값은 같다.
상자 하나의 넓이가 \(h_n \times \frac{1}{h_n} = 1\)이라, 평균 낸 \(p_n\)의 넓이도 늘 1이다3. 그림의 세 곡선 모두 아래 넓이가 1이다.
창 크기의 영향
상자의 폭과 높이는 맞물려 있다. \(h_n\)이 크면 상자가 넓고 낮고, 작으면 좁고 높다. 같은 표본 5개에 창 폭을 1, 0.5, 0.2로 바꿔 그려 보면, 폭이 좁아질수록 표본마다 높고 뾰족한 봉우리가 따로 선다.
| \(V_n\)(또는 \(h_n\))이 너무 크다 | \(V_n\)이 너무 작다 | |
|---|---|---|
| 곡선 | 넓고 낮은 언덕 몇 개가 서로 겹친다 | 표본마다 뾰족한 봉우리가 따로 선다 |
| 문제 | 세세한 모양을 못 가른다 | 표본이 조금만 달라져도 곡선이 크게 바뀐다 |
| 위 예시 | 폭 10: 골짜기인 9.6이 5.2보다 높다 | 폭 1: 0~24 가운데 길이 15만큼이 0이다 |
둘 사이에서 타협해야 하고, \(h_n\)을 무엇으로 고르느냐가 \(p_n(\mathbf{x})\)를 크게 바꾼다.
이런 그림은 흔히 상자 대신 매끄러운 언덕으로 그린다. 창 함수를 상자 대신 종 모양 곡선(정규분포의 밀도)으로 바꾼 것이다. 넓이가 1인 함수면 창 함수로 쓸 수 있고, 이때는 창 밖의 표본도 멀수록 작게나마 값을 보탠다3.
활용
- 분류. 클래스마다 표본으로 밀도를 구해 물어보는 값에서 견준다. 창이 같으면 결국 창 안에 표본이 더 많이 든 클래스가 답이다. 창 안에 아무 표본도 없으면 답을 못 낸다.
- 비용. 미리 계산해 둘 것이 없는 대신 표본 \(n\)개를 모두 갖고 있어야 하고, 물음 하나에 표본 \(n\)개를 모두 훑는다3.
- 흔한 실수. 개수 \(k_n\)을 \(n\)으로만 나누고 \(V_n\)으로 나누지 않는 것. 그러면 창을 키울수록 값이 커지기만 한다.
연결
- 선수: 히스토그램 밀도 추정(같은 식 \(\frac{k/n}{V}\), 칸을 미리 자른다)
- 크기 대신 개수를 정해 두는 방법: k-이웃 밀도 추정, 둘의 차이는 파젠 창과 k-이웃 비교
- 매끄러운 창으로 쓰는 곡선: 정규분포
자주 하는 오해
틀렸다. 자를 촘촘하게 댈수록 정밀해진다는 느낌 때문에 그럴듯해 보인다. 하지만 창이 작아지면 창 안에 드는 표본도 줄어서, 값이 표본 한두 개에 좌우된다. 위 예시에서 폭 1이면 0~24 가운데 길이 15만큼에서 값이 0이다. 7과 12 사이의 9, 14와 20 사이의 17 같은 값이 “절대 안 나온다”는 답을 받는다. 창을 줄여도 괜찮으려면 표본이 그만큼 많아야 한다. 확인하는 법: 폭을 줄여 가며 곡선을 그려 표본 자리에만 기둥이 서는지 본다.
확인 문제
C1 파젠 창의 밀도 추정식을 쓰고, \(n\), \(h_n\), \(V_n\), \(\varphi\)가 각각 무엇인지 말하라.
답: \(p_n(\mathbf{x}) = \frac{1}{n}\sum_{i=1}^{n}\frac{1}{V_n}\varphi\!\left(\frac{\mathbf{x} - \mathbf{x}_i}{h_n}\right)\). \(n\)은 표본 수, \(h_n\)은 창의 한 변 길이, \(V_n = h_n^d\)는 창의 크기, \(\varphi\)는 모든 좌표가 \(\frac12\) 안쪽이면 1이고 아니면 0인 창 함수다.
이유: 합은 창 안에 든 표본 수 \(k_n\)이라 식 전체가 \(\frac{k_n/n}{V_n}\)이다. \(V_n\)으로 나누는 것을 빼먹기 쉽다.
C2 표본이 2, 3, 7이다. 폭 2인 창으로 \(x = 3\)에서 밀도를 구하라.
답: 창은 2부터 4까지다. 2와 3이 들어 \(k = 2\)다. \(\frac{2/3}{2} = \frac13\).
이유: 2는 창의 끝에 딱 걸리는데, 창 함수가 \(\le \frac12\)이라 넣는다. 7은 \(\frac{3 - 7}{2} = -2\)라 창 밖이다1.
C3 표본이 평면의 세 점 \((1, 1)\), \((2, 1)\), \((4, 4)\)다. 한 변이 2인 창으로 \(\mathbf{x} = (1.5, 1.5)\)에서 밀도를 구하라.
답: 창은 가로 0.5~2.5, 세로 0.5~2.5인 정사각형이다. \((1, 1)\)과 \((2, 1)\)이 들어 \(k = 2\)다. \(V = 2^2 = 4\)이므로 \(\frac{2/3}{4} = \frac16\).
이유: 값이 두 가지면 크기는 길이가 아니라 넓이 \(h^2\)이다. 2로 나누면 틀린다1.
C4 표본 수는 그대로인데 창 폭을 아주 크게, 또 아주 작게 잡으면 추정 곡선이 각각 어떻게 되는가? 왜 그런가?
답: 아주 크게 잡으면 어느 값에서 물어도 거의 모든 표본이 창에 들어 곡선이 넓고 낮은 언덕 하나가 된다. 봉우리와 골짜기를 못 가른다. 아주 작게 잡으면 표본 바로 옆에서만 창에 표본이 들어, 표본마다 좁고 높은 기둥이 서고 나머지는 0이다. 표본이 조금만 바뀌어도 곡선이 크게 달라진다.
이유: 표본 하나가 올리는 상자는 폭 \(h_n\), 높이 \(\frac{1}{V_n}\)이라 넓이가 늘 1이다. 폭을 키우면 낮아지며 서로 겹치고, 줄이면 높아지며 서로 떨어진다.