알고 싶은 값에서 시작해, 가까운 자료가 정해 둔 개수만큼 잡힐 때까지 구간을 넓혀 가는 방법이다. 조금만 넓혀도 개수가 차면 그 근처에 자료가 빽빽하다는 뜻이고, 멀리까지 넓혀야 하면 드물다는 뜻이다. 구간의 크기가 자료가 몰린 정도에 저절로 맞춰지므로 텅 빈 구간이 생기지 않는다. 대신 개수는 사람이 정해야 하고, 그려 보면 곡선이 뾰족뾰족하며, 자료에서 아주 먼 값에도 0이 아닌 답을 주어 다 더하면 1을 넘는다.
예시로 보기
파젠 창은 창 크기를 하나로 정해 둔다. 그래서 자료가 드문 곳에서는 창이 비고, 빽빽한 곳에서는 창이 너무 많은 것을 덮는다. 크기 대신 “창 안에 들 개수”를 정해 두면, 창이 자리마다 알맞게 늘었다 줄었다 한다.
같은 머리카락 길이 10개(cm)를 쓴다1.
\[3,\ 4,\ 5,\ 5,\ 6,\ 7,\ 12,\ 13,\ 14,\ 20\]9.6에서 가까운 표본 3개가 잡힐 때까지 넓힌다. 9.6에서 각 표본까지의 거리를 가까운 순서로 적는다.
| 순서 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 표본 | 12 | 7 | 13 | 6 | 14 |
| 거리 | 2.4 | 2.6 | 3.4 | 3.6 | 4.4 |
- 세 번째로 가까운 표본은 13이고 거리는 3.4다.
- 구간은 9.6에서 양쪽으로 3.4씩, 곧 6.2부터 13.0까지다. 길이는 \(2 \times 3.4 = 6.8\).
- 든 비율을 길이로 나눈다. \(\frac{3/10}{6.8} \approx 0.0441\).
파젠 창은 폭 4에서 9.6에 0을 줬다. 여기서는 구간이 표본을 만날 때까지 넓어지므로 0이 나오지 않는다.
표본이 몰린 5.2에서는 세 번째로 가까운 표본(6)까지 거리가 0.8뿐이다. 구간 길이가 1.6이라 \(\frac{3/10}{1.6} = 0.1875\)다. 같은 3개를 잡는 데 9.6에서는 길이 6.8, 5.2에서는 1.6이 들었다. 이 길이의 차이가 곧 빽빽함의 차이다.
| 물어보는 값 | 개수 3: 반지름, 값 | 개수 5: 반지름, 값 |
|---|---|---|
| 5.2 | 0.8, 0.1875 | 1.8, 0.1389 |
| 9.6 | 3.4, 0.0441 | 4.4, 0.0568 |
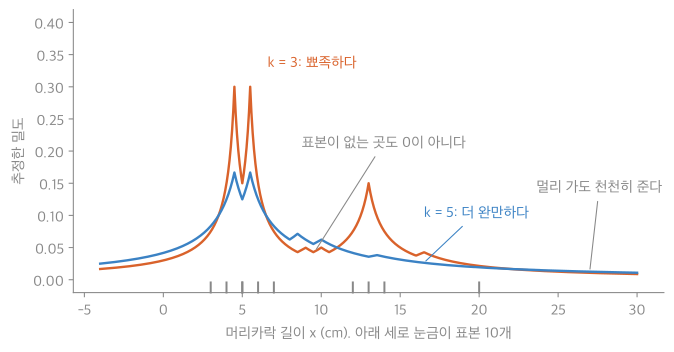
모든 \(x\)에서 값을 구해 이었다. 개수 3인 곡선은 표본 근처에서 뾰족하게 솟고, 개수 5인 곡선은 더 완만하다. 어느 곡선도 0에 닿지 않고, 표본에서 멀어져도 아주 천천히 내려간다2.
정의
\(k_n\)-이웃 찾기는 물어보는 값 \(\mathbf{x}\)와 찾을 이웃의 개수 \(k_n\)을 먼저 정하고, 가까운 표본 \(k_n\)개가 들 때까지 \(\mathbf{x}\)를 가운데 둔 구역 \(R_n\)을 키우는 방법이다. 밀도는 그때의 구역 크기 \(V_n\), 개수 \(k_n\), 전체 표본 수 \(n\)으로 구한다.
\[p_n(\mathbf{x}) = \frac{k_n / n}{V_n}\]식은 히스토그램이나 파젠 창과 똑같다. 다른 것은 무엇이 먼저 정해지는가다. 여기서는 \(k_n\)이 사람이 정한 수이고, \(V_n\)이 \(\mathbf{x}\)와 표본에 따라 그때그때 정해진다.
값이 하나뿐이면 \(\mathbf{x}\)에서 \(k_n\)번째로 가까운 표본까지의 거리를 \(r\)이라 할 때 구역은 \(x - r\)부터 \(x + r\)까지이고 \(V_n = 2r\)이다1. 값이 여러 가지면 “가깝다”를 어떤 거리로 재는지부터 정해야 한다(거리와 유사도).
절차
입력: 표본 x_1..x_n, 물어보는 값 x, 이웃 수 k
1. x에서 모든 표본까지의 거리를 잰다
2. 거리를 작은 것부터 늘어놓는다
3. k번째 거리를 r로 둔다
4. 구역의 크기 V를 구한다 (값이 하나면 V = 2r)
5. (k / n) / V 를 돌려준다
물음 하나에 표본 \(n\)개까지의 거리를 모두 재고 늘어놓으므로 \(O(n \log n)\)이다. \(n\)은 표본 수다3.
개수의 영향과 한계
표본 8개에 개수를 3과 5로 잡아 두 곡선을 그리면, 3인 곡선이 훨씬 뾰족하고 5인 곡선이 더 평평하다. 개수가 파젠 창의 창 크기와 같은 일을 한다. 작으면 표본 몇 개에 휘둘리고, 크면 넓은 구역을 한 덩어리로 뭉갠다.
이 방법의 추정값은 확률밀도가 꼭 지켜야 할 것을 못 지킨다3.
- 표본 바로 위에서 값이 끝없이 커진다. 개수가 1이면 표본 위에서 반지름이 0이다. 12에서 0.01 떨어진 곳의 값은 5, 0.001 떨어진 곳은 50이다.
- 넓이가 1이 아니다. 표본에서 멀어지면 반지름이 거리만큼 늘 뿐이라 값이 “거리분의 1”처럼 천천히 준다. 30에서도 개수 3이면 \(\frac{3/10}{34} \approx 0.0088\)이다. 이런 꼬리는 끝까지 더하면 한없이 커진다.
그래서 값 하나하나를 견주는 데는 쓰지만, 구간의 확률을 구하려고 적분하면 안 된다.
활용
분류. 클래스가 여럿이면 표본을 한데 모아 놓고, 물어보는 값에서 가까운 \(k\)개를 잡아 그 안에 가장 많이 든 클래스를 답한다. 구역이 같으니 크기 \(V\)가 모든 클래스에 똑같이 나뉘고, 남는 것은 개수뿐이다. 결국 구역 안에 표본이 많은 쪽이 답이다.
위의 10개에 이름표를 붙인다. 남자가 3, 4, 5, 5, 6, 12이고 여자가 7, 13, 14, 20이다1.
| 물어보는 값 | 가까운 3개 | 답 |
|---|---|---|
| 5.2 | 5(남), 5(남), 6(남) | 남 3 : 여 0 → 남 |
| 9.6 | 12(남), 7(여), 13(여) | 남 1 : 여 2 → 여 |
틀릴 확률. 분포를 정확히 알 때 낼 수 있는 가장 낮은 오류율이 있다(베이즈 분류기의 오류율, 베이즈 정리로 가장 그럴듯한 클래스를 고를 때의 값). 가까운 표본으로 답하는 분류기의 오류율은 그보다 낮을 수 없지만 2배를 넘지도 않는다. 이 보장은 가장 가까운 표본 하나로 답하는 규칙에서, 표본이 한없이 많을 때의 이야기다. 표본이 적으면 2배를 넘을 수 있다4.
흔한 실수. \(V\)를 반지름 \(r\)로 두는 것. 구역은 양쪽으로 뻗으므로 값이 하나일 때 \(V = 2r\)이다.
연결
- 선수: 히스토그램 밀도 추정(같은 식 \(\frac{k/n}{V}\)), 거리와 유사도(가까움을 재는 법)
- 개수 대신 크기를 정해 두는 방법: 파젠 창, 둘의 차이는 파젠 창과 k-이웃 비교
- 오류율을 견주는 기준: 베이즈 정리
확인 문제
C1 \(k_n\)-이웃 밀도 추정의 식을 쓰고, 식 안에서 사람이 정하는 것과 자료가 정하는 것을 가르라.
답: \(p_n(\mathbf{x}) = \frac{k_n/n}{V_n}\). 사람이 정하는 것은 이웃 수 \(k_n\)이다. 구역의 크기 \(V_n\)은 \(\mathbf{x}\)에서 \(k_n\)번째로 가까운 표본까지의 거리로 정해진다. 값이 하나면 \(V_n = 2r\)이다.
이유: 파젠 창은 반대로 \(V_n\)을 사람이 정하고 \(k_n\)을 센다.
C2 표본이 1, 2, 4, 8, 16이다. \(x = 5\)에서 이웃 수 2로 밀도를 구하라. 거리를 늘어놓는 것부터 차례로 적어라.
답: 거리는 4, 3, 1, 3, 11이고 작은 것부터 1, 3, 3, 4, 11이다. 두 번째 거리가 3이므로 \(r = 3\), \(V = 6\)이다. \(\frac{2/5}{6} = \frac{1}{15} \approx 0.067\).
이유: 거리 3인 표본이 2와 8로 둘이지만 두 번째 거리는 어느 쪽을 잡아도 3이다. \(V\)를 3으로 두면 \(\frac{2}{15}\)로 두 배가 되어 틀린다1.
C3 절차의 3~5번 줄이 하는 일을 한 문장으로 말하라.
답: 물어보는 값에서 표본이 \(k\)개 잡힐 때까지 구역을 넓히고, 그렇게 넓힌 구역이 클수록 밀도를 낮게 매긴다.
C4 이 방법은 왜 표본이 하나도 없는 곳에서도 0을 내지 않는가? 그 성질 때문에 생기는 문제는 무엇인가?
답: 구역을 표본 \(k\)개를 만날 때까지 넓히기 때문이다. 표본이 있는 한 반지름은 늘 유한하고, \(\frac{k/n}{V}\)는 0보다 크다. 그 대가로 표본에서 아주 먼 값에도 천천히 줄어드는 값을 주어, 곡선 아래 넓이가 1을 넘어 한없이 커진다. 진짜 확률밀도처럼 적분해 쓸 수 없다.
-
16_knn-density_plot.py로 그렸고, 표의 네 값과 두 곡선이 그린 범위 어디서도 0보다 큰 것, 개수 3인 곡선의 봉우리가 더 높은 것을 같은 코드로 확인했다. ↩
-
Duda, Hart, Stork, Pattern Classification 2판, 4.4절 “\(k_n\)-Nearest-Neighbor Estimation”이 다룬다. 수치는 검증 코드로 확인했다. ↩ ↩2
-
Cover, Hart, “Nearest neighbor pattern classification”, IEEE Transactions on Information Theory, 1967이 가장 가까운 표본 하나로 답하는 규칙에서 표본 수가 한없이 클 때의 결과로 보였다. ↩